
एआई की मूल बातें
छवि वर्गीकरण कैसे काम करता है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
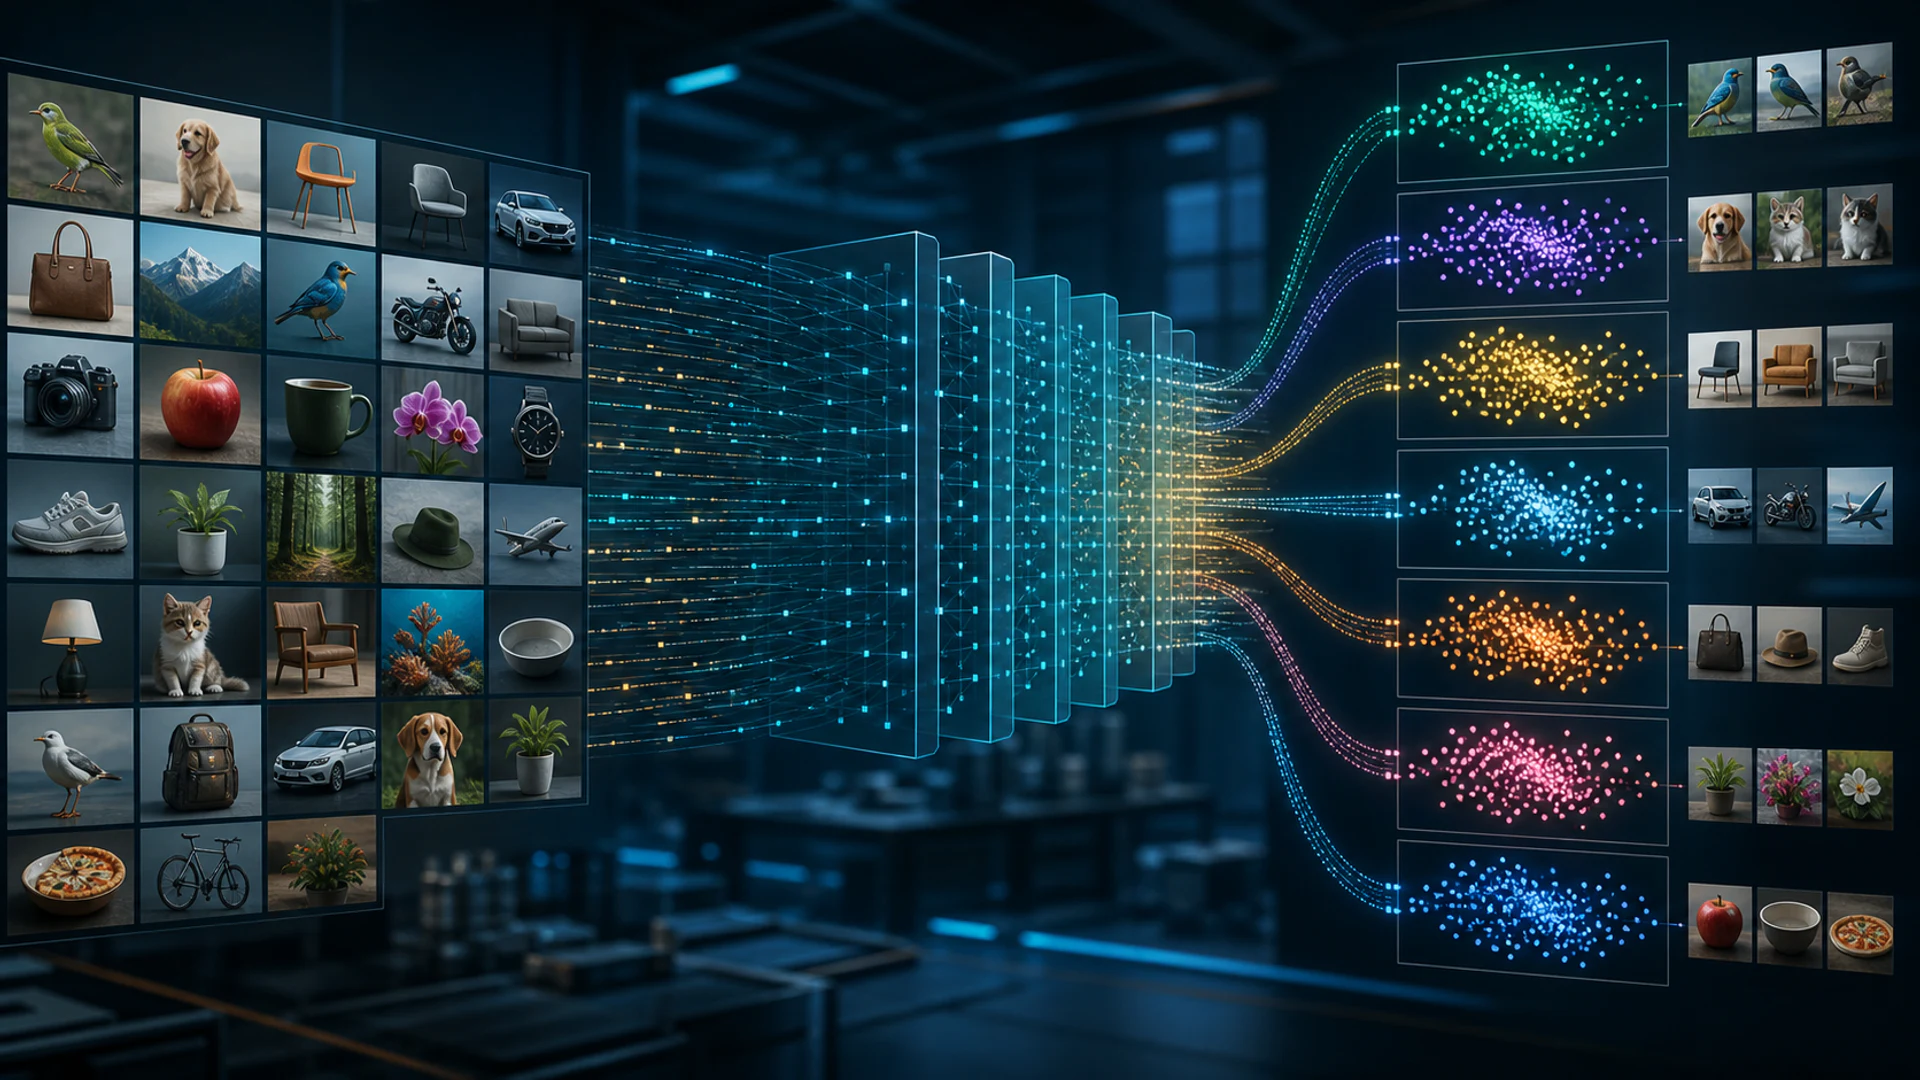
छवि वर्गीकरण पूरे चित्र के लिए एक लेबल की भविष्यवाणी करता है। यह “कौन सा उत्पाद वर्ग दिखाया गया है?” या “क्या इस स्कैन में लक्ष्य खोज शामिल है?” जैसे प्रश्नों के उत्तर देता है। यह स्वयं प्रत्येक वस्तु को स्थान नहीं देता या उसके पिक्सेल की रूपरेखा नहीं बनाता।
आधुनिक सिस्टम अक्सर कॉन्वॉल्यूशनल न्यूरल नेटवर्क या विज़न ट्रांसफ़ॉर्मर का उपयोग करते हैं, अक्सर प्री‑ट्रेंड वज़न के साथ प्रारंभिक किए जाते हैं। विश्वसनीय प्रदर्शन अभी भी लेबल, सैंपलिंग, ऑगमेंटेशन, कैलिब्रेशन और वास्तविक परिनियोजन स्थितियों में परीक्षण पर निर्भर करता है।
मुख्य बिंदु
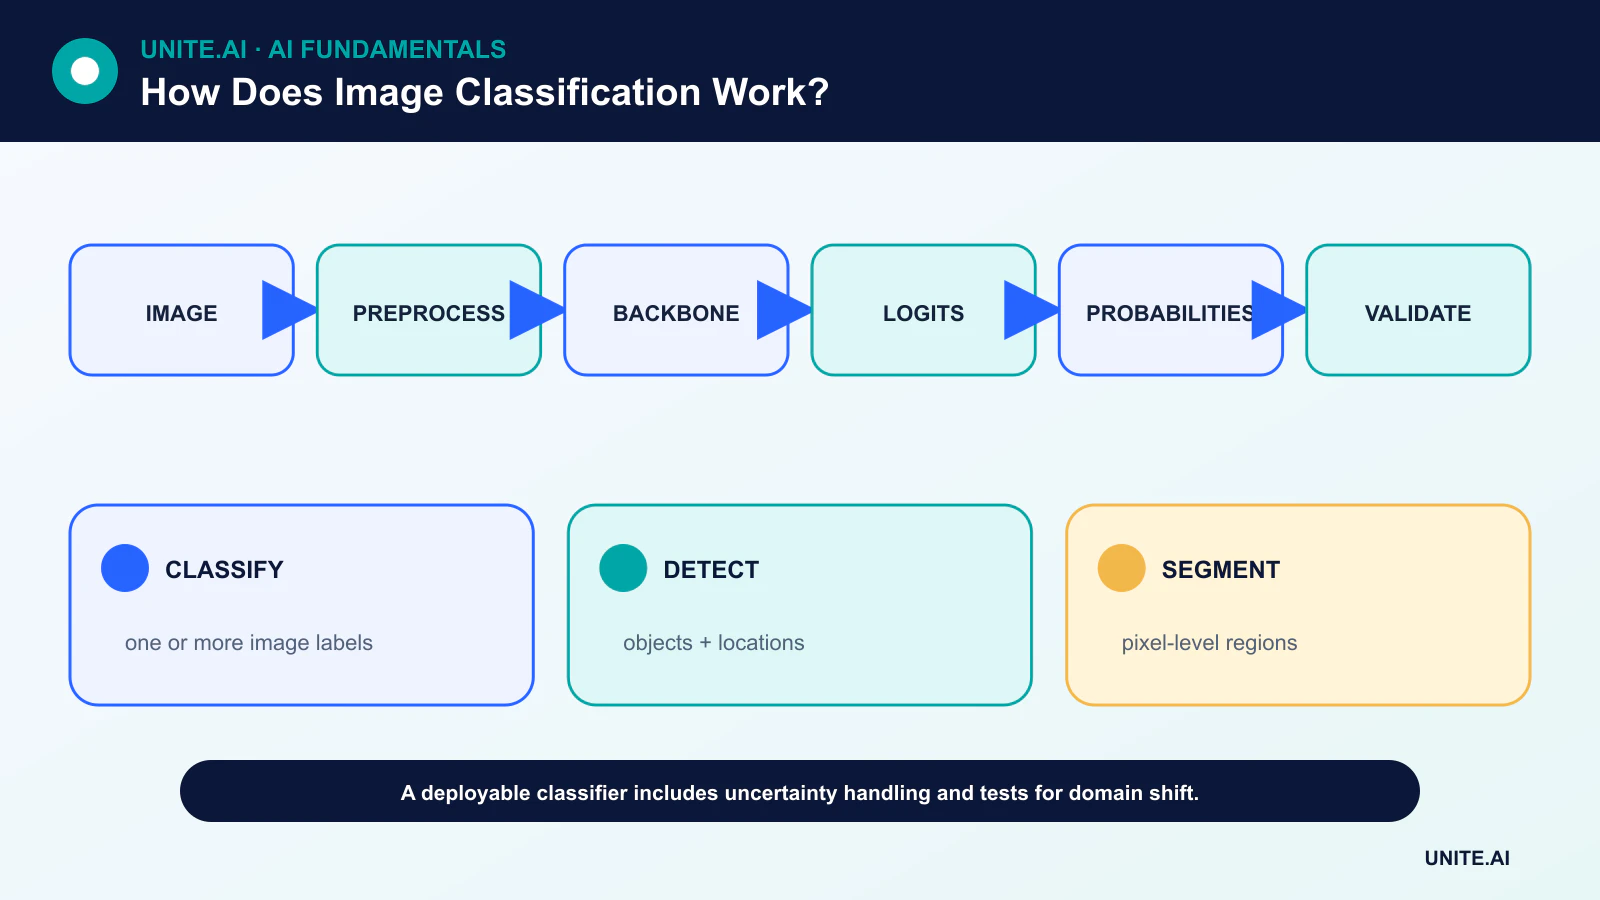
- वर्गीकरण पूरे चित्र को लेबल करता है; डिटेक्शन वस्तु बॉक्स बनाता है और सेगमेंटेशन पिक्सेल‑स्तर के क्षेत्रों को असाइन करता है।
- प्री‑ट्रेनिंग और ट्रांसफ़र लर्निंग डेटा की आवश्यकता को कम कर सकते हैं, लेकिन डोमेन का असंगत होना लाभ को नष्ट कर सकता है।
- कुल सटीकता वर्ग असंतुलन, झूठी शॉर्टकट और खराब कैलिब्रेशन को छिपा सकती है।
- छवि गुणवत्ता, कैप्चर डिवाइस, भौगोलिक स्थिति और कार्यप्रवाह में परिवर्तन सभी वितरण शिफ्ट पैदा कर सकते हैं।
पिक्सेल से स्कोर तक
छवियों को आकार बदलकर या क्रॉप करके, सामान्यीकृत किया जाता है और टेन्सर में परिवर्तित किया जाता है। डेटा ऑगमेंटेशन लेबल‑सुरक्षित परिवर्तन जैसे फ़्लिप, क्रॉप या रंग परिवर्तन लागू कर सकता है। एक बैकबोन पिक्सेल को फीचर में मैप करता है; एक वर्गीकरण हेड लॉजिट्स उत्पन्न करता है जिन्हें सापेक्ष वर्ग स्कोर में बदला जाता है।
चुना गया पूर्वप्रसंस्करण परिनियोजन से मेल खाना चाहिए। एक सेंटर क्रॉप जो संबंधित वस्तु को हटा देता है या सामान्यीकरण का असंगत होना प्रदर्शन को नुकसान पहुँचा सकता है, भले ही प्रशिक्षित वज़न अपरिवर्तित रहें।
CNNs और विज़न ट्रांसफ़ॉर्मर
कन्वॉल्यूशनल न्यूरल नेटवर्क स्थानीय फ़िल्टर और साझा वज़न का उपयोग करके स्थानिक फीचर बनाते हैं। रेजिडुअल कनेक्शन ने बहुत गहरे CNN को अनुकूलित करना आसान बना दिया। विज़न ट्रांसफ़ॉर्मर छवि को पैचों में विभाजित करते हैं और उनके बीच संबंधों को मॉडल करने के लिए अटेंशन का उपयोग करते हैं।
आर्किटेक्चर तुलना में प्रशिक्षण डेटा, ऑगमेंटेशन, कंप्यूट और रिज़ॉल्यूशन को नियंत्रित करना चाहिए। सार्वजनिक बेंचमार्क पर सबसे अच्छा मॉडल किनारा डिवाइस, छोटे डेटासेट या व्याख्यात्मकता की आवश्यकता के लिए सबसे उपयुक्त नहीं हो सकता।
ट्रांसफ़र लर्निंग और डेटा डिज़ाइन
ट्रांसफ़र लर्निंग बड़े स्रोत डेटासेट पर प्रशिक्षित वज़न से शुरू होता है। टीम बैकबोन को फ्रीज़ कर सकती है, बाद के लेयर्स को फाइन‑ट्यून कर सकती है या पूरे मॉडल को अपडेट कर सकती है। फाइन‑ट्यूनिंग आमतौर पर कम लर्निंग रेट और लीकेज‑सुरक्षित वैलिडेशन सेट की आवश्यकता होती है।
लेबल को यह वर्णन करना चाहिए कि क्या दृश्य रूप से अनुमानित किया जा सकता है। यदि निदान के लिए रोगी इतिहास आवश्यक है जो छवि में उपलब्ध नहीं है, तो वर्गीकर्ता पूर्ण क्लिनिकल निर्णय नहीं सीख सकता। डुप्लिकेट, एक वीडियो के फ्रेम और एक ही विषय की छवियों को समान विभाजन में रखना चाहिए।
मेट्रिक्स, अनिश्चितता और शॉर्टकट
टॉप‑1 सटीकता के लिए सबसे अधिक स्कोर वाला वर्ग सही होना चाहिए; टॉप‑k सटीकता k सबसे अधिक स्कोर वाले वर्गों में सही वर्ग को स्वीकार करती है। प्रति‑वर्ग प्रिसीजन, रिकॉल और एक कन्फ्यूज़न मैट्रिक्स असमान त्रुटियों को उजागर करता है।
मॉडल बैकग्राउंड, वॉटरमार्क, अधिग्रहण उपकरण या फ्रेमिंग का उपयोग कर सकते हैं, बजाय इच्छित वस्तु के। काउंटरफ़ैक्चुअल टेस्ट, सबग्रुप विश्लेषण और सैलियंसी टूल शॉर्टकट खोजने में मदद कर सकते हैं, लेकिन स्पष्टीकरण हीटमैप कारणात्मक तर्क का प्रमाण नहीं है।
परिनियोजन मॉनिटरिंग
प्रोडक्शन जांच में भ्रष्ट फ़ाइलें, अप्रत्याशित आयाम, धुंधलापन, प्रकाश, कैमरा मॉडल और नई वर्ग शामिल होने चाहिए। विश्वास को परिनियोजन‑समान डेटा पर कैलिब्रेट किया जाना चाहिए, और सीमा‑बाहरी इनपुट को अस्वीकार या समीक्षा किया जाना चाहिए।
विलंबित लेबल और त्रुटि लागत में परिवर्तन की निगरानी आवश्यक है। एक मॉडल जो इनपुट आँकड़ों से स्थिर दिखता है, फिर भी विफल हो सकता है यदि पिक्सेल और लेबल के बीच संबंध बदल जाता है।
छवि‑वर्गीकरण डेटासेट बनाना
छवि वर्गीकरण पूरे चित्र को एक या अधिक लेबल असाइन करता है। यह डिटेक्शन से अलग है, जो वस्तुओं को स्थानीयकृत करता है, और सेगमेंटेशन से, जो पिक्सेल को लेबल करता है। वर्ग सीमा, पदानुक्रम, मल्टी‑लेबल नियम, पृष्ठभूमि या अज्ञात श्रेणियाँ, और कौन सा प्रमाण दृश्य होना चाहिए, निर्धारित करें। परिनियोजन‑प्रतिनिधि कैमरे, स्थान, प्रकाश, दृश्य बिंदु, दूरी और विषय एकत्र करें। ऑगमेंटेशन से पहले विषय, दृश्य, सत्र या स्रोत के आधार पर विभाजन करें; पास के वीडियो फ्रेम या विभाजन में दोहराए गए उत्पाद चित्र गंभीर लीकेज पैदा करते हैं।
एनोटेशन निर्देशों में ओक्लूज़न, अस्पष्ट वस्तुएँ, कई वर्ग, कम गुणवत्ता, और अस्वीकार को शामिल करना चाहिए। सहमति मापें और व्यवस्थित असहमति की समीक्षा करें। केवल वर्ग संतुलन कवरेज की गारंटी नहीं देता: रोग वर्ग में केवल एक डिवाइस या वन्यजीव वर्ग में केवल एक पृष्ठभूमि हो सकती है। मेटाडेटा और निकट डुप्लिकेट की जाँच करें, और स्वतंत्र अधिग्रहण से एक संरक्षित टेस्ट सेट रखें। सिंथेटिक डेटा और वेब स्क्रैपिंग विविधता बढ़ा सकते हैं लेकिन लाइसेंसिंग, उत्पत्ति, शैली और लेबल समस्याएँ लाते हैं जिन्हें वास्तविक छवियों पर मापना आवश्यक है।
मॉडल, प्रशिक्षण और मूल्यांकन
पारम्परिक विधाएँ इंजीनियर किए गए डिस्क्रिप्टर को वर्गीकर्ता के साथ मिलाती हैं; आधुनिक सिस्टम अक्सर ट्रांसफ़र लर्निंग के माध्यम से कन्वॉल्यूशनल नेटवर्क या विज़न ट्रांसफ़ॉर्मर का उपयोग करते हैं। आकार बदलने और क्रॉप करने के विकल्प यह निर्धारित करते हैं कि कौन सी जानकारी बनी रहती है। ऑगमेंटेशन को वैध विविधता को प्रतिबिंबित करना चाहिए और लेबल को सुरक्षित रखना चाहिए। कार्य‑अनुकूल लॉस को अनुकूलित करें, असंतुलन को वजन या सैंपलिंग से सावधानीपूर्वक संभालें, और वैलिडेशन डेटा पर चेकपॉइंट चुनें। एक सरल बेसलाइन से तुलना करें और ऑगमेंटेशन, रिज़ॉल्यूशन और प्री‑ट्रेंड इनिशियलाइज़ेशन को हटाकर समझें कि सुधार कहाँ से आया।
प्रति‑वर्ग प्रिसीजन, रिकॉल, F1, कन्फ्यूज़न, आवश्यक होने पर टॉप‑k सटीकता, कैलिब्रेशन और स्थिति अनुसार प्रदर्शन रिपोर्ट करें। धुंधलापन, संपीड़न, प्रकाश, क्रॉप, ओक्लूज़न, डिवाइस और बिना समर्थित वर्ग के इनपुट का परीक्षण करें। विश्वास थ्रेशोल्ड अनिश्चित मामलों को समीक्षा की ओर निर्देशित कर सकते हैं; सॉफ़्टमैक्स प्रॉबेबिलिटी गारंटीकृत विश्वास नहीं है, विशेषकर शिफ्ट के तहत। काउंटरफ़ैक्चुअल बैकग्राउंड और ओक्लूज़न टेस्ट शॉर्टकट लर्निंग को उजागर करते हैं। सुरक्षा‑संबंधी उपयोग के लिए, सबसे खराब स्थिति की विफलताओं और फॉल्स पॉज़िटिव व नेगेटिव के परिणामों का मूल्यांकन करें।
परिनियोजन और मॉनिटरिंग
डिकोड, रंग परिवर्तन, अभिविन्यास, सामान्यीकरण, मॉडल और लेबल मैप को एक साथ पैकेज करें। निर्यातित या क्वांटाइज़्ड आर्टिफैक्ट को लक्ष्य डिवाइस पर वैलिडेट करें और एंड‑टू‑एंड लेटेंसी, मेमोरी, पावर और थ्रूपुट मापें। छवि गुणवत्ता, इनपुट और आउटपुट वितरण, कैलिब्रेशन, पुष्टि किए गए लेबल और सेंसर स्वास्थ्य की निगरानी करें। छवि संरक्षण को न्यूनतम और सुरक्षित रखें, विशेषकर चेहरों, स्थानों और दर्शकों के लिए। भ्रष्ट या सीमा‑बाहरी इनपुट के लिए फॉलबैक प्रदान करें और मॉडल संस्करणों को रोल बैक करें। वर्गीकरण परिभाषित छवि‑स्तरीय प्रश्न का उत्तर देता है; इसे असमर्थित स्थानीयकरण, पहचान या इरादा दावों में विस्तारित नहीं किया जाना चाहिए।
व्यावहारिक उदाहरण: पुनर्चक्रण योग्य सामग्री का वर्गीकरण
एक सुविधा कन्वेयर पर वस्तुओं की फ़ोटो लेती है और सामग्री वर्ग, प्रदूषण और अज्ञात को लेबल करती है। छवियों को संग्रह दिन और वस्तु बैच के आधार पर विभाजित किया जाता है, जिसमें प्रकाश, गीली सतहें, मुड़ना, ओवरलैप और खाली बेल्ट शामिल हैं। एक छोटा CNN और प्री‑ट्रेंड मॉडल को रंग और आकार नियमों के साथ तुलना किया जाता है। प्रति‑वर्ग रिकॉल, गलत वर्गीकरण, कैलिब्रेशन, थ्रूपुट और कैमरा तथा सामग्री स्थिति के अनुसार परिणाम चयन को निर्देशित करते हैं।
उत्पादन पाइपलाइन कैमरा एक्सपोज़र और बेल्ट टाइमिंग की जाँच करती है, फिर अनिश्चित वस्तुओं को वर्ग लागू करने के बजाय सामान्य स्ट्रीम में भेजती है। क्वांटाइज़्ड इन्फ़रेंस को सटीक हार्डवेयर पर वैलिडेट किया जाता है। मॉनिटरिंग इनपुट गुणवत्ता, वर्ग दर, अस्वीकृत और नमूना मैन्युअल ऑडिट को ट्रैक करती है; नई पैकेजिंग एक समीक्षा किए गए डेटा अपडेट को ट्रिगर करती है। मॉडल भौतिक गार्ड वाले सीमित सॉर्टर को नियंत्रित करता है, और सेंसर या मॉडल विफलता तंत्र को सुरक्षित स्थिति में वापस ले आती है, न कि चुपचाप सामग्री को गलत दिशा में भेजे।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय को सफल प्रदर्शन से अधिक की आवश्यकता होती है। इच्छित उपयोगकर्ता, संचालन पर्यावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले पुनरुत्पादनीय बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपलब्ध इनपुट, वितरण शिफ्ट, निर्भरता आउटेज, दुरुपयोग और सबसे अधिक उपेक्षित समूहों या पर्यावरणों का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनः उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक और रिटायरमेंट के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट का उपयोग करें, सुरक्षित फॉलबैक बनाए रखें, और जानबूझकर इंजेक्टेड विफलताओं के साथ मॉनिटरिंग को वैलिडेट करें। परिचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर परिनियोजन के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, न कि ऑफ़लाइन प्रदर्शन को स्थायी मानें। डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीति, हार्डवेयर या उद्देश्यों में परिवर्तन होने पर पुनः‑मूल्यांकन करें। एक बनाए रखा गया सिस्टम दस्तावेज़ीकृत रिकवरी, घटना सीखना, हटाना और प्रतिधारण प्रक्रियाएँ, तथा एक स्पष्ट बिंदु चाहिए जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या एक छवि वर्गीकरणकर्ता कई वस्तुओं की पहचान कर सकता है?
एक मल्टी‑लेबल वर्गीकरणकर्ता बता सकता है कि कौन‑से वर्ग उपस्थित हैं, लेकिन यह व्यक्तिगत उदाहरणों को स्थानीयकृत नहीं करता। बॉक्स या गिनती के लिए ऑब्जेक्ट डिटेक्शन आवश्यक है।
क्यों एक मॉडल उन फ़ोटो पर विफल हो सकता है जो व्यक्ति के लिए सामान्य दिखती हैं?
यह कैप्चर आर्टिफैक्ट, बनावट या बदलती सहसंबंधों पर निर्भर हो सकता है। छोटे पूर्वप्रसंस्करण अंतर और डोमेन शिफ्ट भी सीखी गई विशेषताओं को प्रभावित कर सकते हैं।
प्राथमिक संदर्भ












