
एआई की मूल बातें
कन्फ्यूजन मैट्रिक्स क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
कन्फ्यूजन मैट्रिक्स एक तालिका है जो गिनती करती है कि वर्गीकरणकर्ता की भविष्यवाणियाँ ज्ञात लेबलों से कितनी बार मिलती या नहीं मिलती हैं। यह दर्शाता है कि कौन‑से वर्ग आपस में भ्रमित हो रहे हैं और उन गिनतियों को प्रदान करता है जिनका उपयोग प्रिसीजन, रिकॉल, स्पेसिफिसिटी और F1 जैसे मीट्रिक की गणना में किया जाता है। यह सुपरवाइज़्ड लर्निंग वर्गीकरण समस्याओं के मुख्य निदान उपकरणों में से एक है।
मैट्रिक्स स्वयं एकल प्रदर्शन स्कोर नहीं है। यह एक विशिष्ट निर्णय थ्रेशोल्ड, डेटासेट और वर्ग परिभाषा पर परिणामों का संरचित दृश्य है।
मुख्य बिंदु
- बाइनरी वर्गीकरण के लिए, चार परिणाम होते हैं: सत्य सकारात्मक, गलत सकारात्मक, गलत नकारात्मक, और सत्य नकारात्मक।
- अक्षों को हमेशा लेबल करें: विभिन्न लाइब्रेरी और प्रकाशन वास्तविक और पूर्वानुमानित वर्गों को समान दिशा में नहीं रखते।
- जब वर्ग असंतुलित होते हैं, तो सटीकता गंभीर त्रुटियों को छुपा सकती है।
- वर्गीकरण थ्रेशोल्ड बदलने से कन्फ्यूजन मैट्रिक्स और प्रिसीजन व रिकॉल के बीच का समझौता बदलता है।
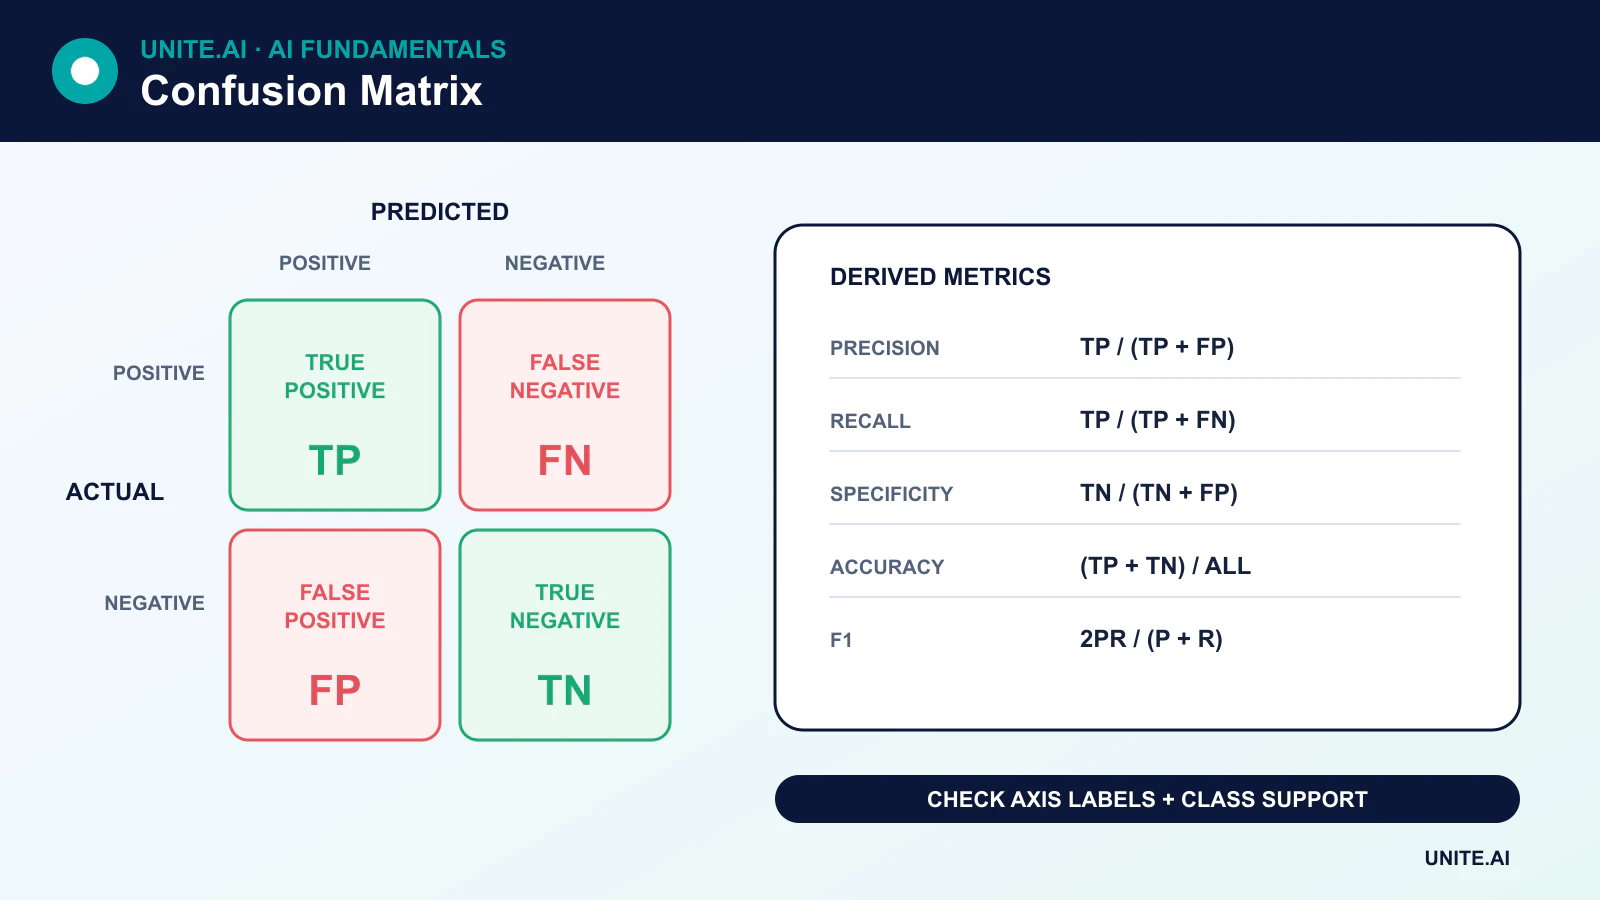
बाइनरी वर्गीकरण के चार परिणाम
- सत्य सकारात्मक (TP): उदाहरण सकारात्मक है और मॉडल भी सकारात्मक भविष्यवाणी करता है।
- गलत सकारात्मक (FP): उदाहरण नकारात्मक है लेकिन मॉडल सकारात्मक भविष्यवाणी करता है।
- गलत नकारात्मक (FN): उदाहरण सकारात्मक है लेकिन मॉडल नकारात्मक भविष्यवाणी करता है।
- सत्य नकारात्मक (TN): उदाहरण नकारात्मक है और मॉडल भी नकारात्मक भविष्यवाणी करता है।
scikit-learn की परंपरा में, पंक्तियाँ वास्तविक वर्गों को दर्शाती हैं और स्तम्भ पूर्वानुमानित वर्गों को। अन्य दृश्यांकन इस व्यवस्था को उलट सकते हैं, इसलिए लेबल—कोने की स्थितियों नहीं—व्याख्या का मार्गदर्शन करना चाहिए।
कन्फ्यूजन मैट्रिक्स से निकाले गए मीट्रिक
प्रिसीजन
Precision = TP / (TP + FP)
प्रिसीजन का उत्तर है: पूर्वानुमानित सकारात्मक उदाहरणों में से वास्तविक सकारात्मक का अनुपात कितना है?
रिकॉल या संवेदनशीलता
Recall = TP / (TP + FN)
रिकॉल का उत्तर है: सभी वास्तविक सकारात्मक उदाहरणों में से मॉडल ने कितना प्रतिशत पहचाना? बाइनरी वर्गीकरण में, सकारात्मक वर्ग का रिकॉल संवेदनशीलता या सत्य‑सकारात्मक दर भी कहा जाता है।
स्पेसिफिसिटी
Specificity = TN / (TN + FP)
स्पेसिफिसिटी नकारात्मक वर्ग के लिए रिकॉल है: वास्तविक नकारात्मकों में से मॉडल ने सही रूप से कितने को अस्वीकार किया?
सटीकता
Accuracy = (TP + TN) / (TP + TN + FP + FN)
सटीकता तब उपयोगी होती है जब वर्ग और त्रुटि लागत संतुलित हों। जब एक वर्ग प्रमुख हो, तो यह भ्रामक हो सकती है।
F1 स्कोर
F1 = 2 × (Precision × Recall) / (Precision + Recall)
F1 प्रिसीजन और रिकॉल को हार्मोनिक औसत से सारांशित करता है। यह सत्य नकारात्मकों को नजरअंदाज करता है, इसलिए यह हर कार्य के लिए उपयुक्त सारांश नहीं है।
एक व्यावहारिक उदाहरण
मान लीजिए एक परीक्षण सेट में 1,000 लेन‑देन हैं। उनमें से पचास धोखाधड़ी वाले हैं। एक मॉडल उन में से 40 धोखाधड़ी को पहचानता है लेकिन 30 वैध लेन‑देन को भी झूठा सकारात्मक चिह्नित करता है:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
मॉडल की सटीकता 96% है, लेकिन इसकी प्रिसीजन लगभग 57% और रिकॉल 80% है। उच्च सटीकता मुख्यतः कई वैध लेन‑देन के कारण है। यह मॉडल स्वीकार्य है या नहीं, यह छूटे हुए धोखाधड़ी की लागत, जांच क्षमता, और जोखिम स्कोर की कैलिब्रेशन पर निर्भर करता है।
थ्रेशोल्ड बदलने से मैट्रिक्स बदलता है
कई वर्गीकर्ता एक स्कोर आउटपुट करते हैं न कि अनिवार्य हाँ/ना उत्तर। सकारात्मक थ्रेशोल्ड को कम करने से सामान्यतः रिकॉल और गलत सकारात्मक बढ़ते हैं; इसे बढ़ाने से प्रिसीजन या स्पेसिफिसिटी बढ़ती है जबकि अधिक सकारात्मक छूटते हैं। थ्रेशोल्ड को वैलिडेशन डेटा और वास्तविक त्रुटि लागत के आधार पर चुना जाना चाहिए, न कि स्वचालित रूप से 0.5 पर निर्धारित।
प्रिसीजन‑रिकॉल और ROC वक्र विभिन्न थ्रेशोल्ड पर प्रदर्शन का सार प्रस्तुत करते हैं। जब सकारात्मक वर्ग दुर्लभ हो, तो प्रिसीजन‑रिकॉल वक्र अक्सर अधिक जानकारीपूर्ण होते हैं।
बहु‑वर्गीय कन्फ्यूजन मैट्रिक्स
K वर्गों के लिए, मैट्रिक्स K × K होता है। सही भविष्यवाणियाँ विकर्ण पर होती हैं; विकर्ण‑बाहरी कोशिकाएँ दर्शाती हैं कि कौन‑से वर्ग जोड़े भ्रमित होते हैं। प्रति‑वर्ग मीट्रिक को विभिन्न तरीकों से औसत किया जा सकता है:
- मैक्रो औसत: प्रत्येक वर्ग को समान वजन देता है।
- वेटेड औसत: प्रत्येक वर्ग को उसके उदाहरणों की संख्या के अनुसार वजन देता है।
- माइक्रो औसत: मीट्रिक की गणना से पहले परिणाम गिनतियों को जोड़ता है।
केवल एक औसत रिपोर्ट करने से छोटे वर्गों पर खराब प्रदर्शन छिप सकता है। जहाँ अंतर महत्वपूर्ण हों, समर्थन गिनती और प्रति‑वर्ग परिणाम शामिल करें।
सामान्य गलतियाँ
- अक्ष लेबल जाँचे बिना उलटा मैट्रिक्स पढ़ना।
- उपयुक्त होल्ड‑आउट सेट के बजाय प्रशिक्षण डेटा से मीट्रिक की गणना करना।
- वर्ग प्रचलन, सैंपलिंग रणनीति, या विभाजनों में डुप्लिकेट इकाइयों को नज़रअंदाज़ करना।
- विभिन्न थ्रेशोल्ड पर निर्मित मैट्रिक्स की तुलना बिना परिवर्तन नोट किए करना।
- सभी गलत सकारात्मक और गलत नकारात्मक को समान लागत मानना।
इसलिए कन्फ्यूजन मैट्रिक्स एक निदान उपकरण है, पूर्ण मूल्यांकन नहीं। कैलिब्रेशन, उपसमूह विश्लेषण, मजबूती, और डाउनस्ट्रीम परिणाम भी वर्गीकरण समीक्षा में शामिल होने चाहिए।
हर कोशिका को पढ़ना और उपयोगी मीट्रिक निकालना
बाइनरी वर्गीकरण के लिए, कन्फ्यूजन मैट्रिक्स चुने हुए सकारात्मक वर्ग और थ्रेशोल्ड के लिए सत्य सकारात्मक, गलत सकारात्मक, गलत नकारात्मक और सत्य नकारात्मक को गिनता है। सटीकता सभी मामलों में सही भविष्यवाणियों को विभाजित करती है; प्रिसीजन पूछता है कि पूर्वानुमानित सकारात्मकों में से कितना भाग सही है; रिकॉल पूछता है कि वास्तविक सकारात्मकों में से कितना भाग पाया गया; स्पेसिफिसिटी वास्तविक नकारात्मकों को सही ढंग से अस्वीकार करने को मापता है। F1 प्रिसीजन और रिकॉल का हार्मोनिक औसत है। कोई भी मीट्रिक सार्वभौमिक रूप से श्रेष्ठ नहीं है: धोखाधड़ी स्क्रीनिंग, चिकित्सा ट्रायेज़ और स्पैम फ़िल्टरिंग समान कोशिकाओं को अलग‑अलग परिणाम देती हैं।
बहु‑वर्गीय समस्याओं में, पंक्तियाँ सामान्यतः वास्तविक वर्गों को दर्शाती हैं और स्तम्भ पूर्वानुमानित वर्गों को, यद्यपि परम्पराएँ भिन्न हो सकती हैं, इसलिए लेबल स्पष्ट होने चाहिए। वन‑वर्सस‑रेस्ट गिनतियाँ प्रति‑वर्ग प्रिसीजन और रिकॉल देती हैं। मैक्रो औसत वर्गों को समान रूप से वजन देता है; माइक्रो औसत निर्णयों को जोड़ता है और आम वर्गों को प्राथमिकता देता है; वेटेड औसत वर्ग समर्थन का अनुसरण करता है। मल्टी‑लेबल कार्य कई लेबलों को एक आइटम पर अनुमति देते हैं और लेबल‑वाइज या सैंपल‑वाइज परिभाषाओं की आवश्यकता होती है। पंक्तियों द्वारा सामान्यीकरण करने से रिकॉल पैटर्न देखे जा सकते हैं या स्तम्भों द्वारा भविष्यवाणी संरचना देखी जा सकती है, लेकिन कच्ची गिनतियों को बनाए रखें ताकि दुर्लभ समूह दृश्य रूप में अतिरंजित न हों।
थ्रेशोल्ड, अनिश्चितता, और परिचालन निर्णय
कन्फ्यूजन मैट्रिक्स एक थ्रेशोल्ड पर कठोर निर्णयों का सार प्रस्तुत करता है। थ्रेशोल्ड की तुलना के लिए प्रिसीजन‑रिकॉल या ROC वक्रों का उपयोग करें, फिर क्षमता, प्रचलन और त्रुटि लागत के आधार पर एक संचालन बिंदु चुनें। कैलिब्रेशन पूछता है कि क्या पूर्वानुमानित संभावनाएँ देखी गई आवृत्ति से मेल खाती हैं और यह रैंकिंग से अलग है। जब प्रचलन बदलता है, तो प्रिसीजन बदल सकता है जबकि संवेदनशीलता और स्पेसिफिसिटी स्थिर रह सकते हैं। विश्वसनीयता अंतराल या बूटस्ट्रैप परिवर्तन रिपोर्ट करें, और छोटे उपसमूह में कुछ त्रुटियों से निष्कर्ष निकालने से बचें।
समय, स्थान, डिवाइस, भाषा और संबंधित प्रभावित समूहों के अनुसार मैट्रिक्स का ऑडिट करें ताकि केंद्रित त्रुटियों का पता चल सके। मॉडल की तुलना मौजूदा निर्णय प्रक्रिया से करें, जिसमें मानव समीक्षा भी शामिल हो। कैस्केड के लिए प्रत्येक चरण में त्रुटियों को रिकॉर्ड करें: पुनः प्राप्ति, वर्गीकरण, थ्रेशोल्डिंग, और कार्रवाई। लाइव आउटपुट लेबल को उनके विलंब और सुधार प्रक्रिया के साथ मॉनिटर करें। एक दिखने में बेहतर F1 अभी भी हानिकारक गलत नकारात्मक बढ़ा सकता है या समीक्षा क्षमता से अधिक हो सकता है। कन्फ्यूजन मैट्रिक्स एक निर्णय लेज़र है; प्रत्येक कोशिका को उस व्यक्ति से जोड़ें जो त्रुटि का अनुभव करता है और उसके बाद की प्रतिक्रिया को दर्शाएँ।
व्यावहारिक उदाहरण: चिकित्सा‑स्क्रीनिंग थ्रेशोल्ड का चयन
एक मशीन‑लर्निंग स्क्रीनिंग मॉडल कम प्रचलन वाली स्थिति के लिए जोखिम स्कोर आउटपुट करता है। टीम विभिन्न थ्रेशोल्ड पर कन्फ्यूजन मैट्रिक्स बनाती है और संवेदनशीलता, स्पेसिफिसिटी, प्रिसीजन, गलत रेफ़रल और चूके हुए मामलों को विश्वसनीयता अंतराल के साथ रिपोर्ट करती है। क्योंकि पॉज़िटिव प्रेडिक्टिव वैल्यू प्रचलन पर निर्भर करती है, यह एक डेटासेट की प्रिसीजन को उद्धृत करने के बजाय लक्षित जनसंख्या को मॉडल करती है। परिणाम डिवाइस, साइट, आयु, लिंग और अन्य चिकित्सकीय रूप से औचित्यपूर्ण समूहों में विभाजित होते हैं।
क्लिनिशियन एक ऐसा संचालन बिंदु चुनते हैं जो आवश्यक संवेदनशीलता को बनाए रखे बिना पुष्टि परीक्षण को अधिभारित करे। मैट्रिक्स को 10,000 स्क्रीन किए गए लोगों में अपेक्षित गिनती में परिवर्तित किया जाता है ताकि परिणाम समझ में आएँ। वैध शर्तों से बाहर के स्कोर स्वचालित निष्कर्ष नहीं देते। मॉनिटरिंग पूर्वानुमानों की तुलना देर से पुष्टि किए गए निदानों से करती है, क्षमता और कैलिब्रेशन को ट्रैक करती है, और प्रचलन या अधिग्रहण में बदलाव होने पर समीक्षा को ट्रिगर करती है। कन्फ्यूजन मैट्रिक्स सटीक मॉडल, थ्रेशोल्ड और जनसंख्या से जुड़ा रहता है।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय सफल प्रदर्शन से अधिक की मांग करता है। इच्छित उपयोगकर्ता, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादनीय बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपलब्ध इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग, और उन समूहों या वातावरणों का परीक्षण करें जो सबसे अधिक उपेक्षित हो सकते हैं। कार्य की गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि स्वतंत्र समीक्षक परिणाम को पुन: उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले रिलीज, अपवाद, परिवर्तन, रोलबैक और सेवानिवृत्ति के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित फॉलबैक रखें, और जानबूझकर डाली गई विफलताओं के साथ मॉनिटरिंग को सत्यापित करें। परिचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया जिम्मेदार को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, न कि ऑफलाइन प्रदर्शन को स्थायी मानें। डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियाँ, हार्डवेयर या उद्देश्य बदलने पर पुनः मूल्यांकन करें। एक बनाए रखा सिस्टम दस्तावेज़ित पुनर्प्राप्ति, घटना सीख, हटाने और रखरखाव प्रक्रियाओं, तथा स्पष्ट बिंदु की भी आवश्यकता रखता है जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
नॉर्मलाइज़्ड कन्फ्यूजन मैट्रिक्स क्या है?
नॉर्मलाइज़ेशन गिनतियों को सत्य‑वर्ग कुल, पूर्वानुमानित‑वर्ग कुल, या सभी अवलोकनों से विभाजित करता है। यह दरों को वर्गों के बीच तुलना करना आसान बनाता है, लेकिन रिपोर्ट में कच्ची समर्थन गिनतियों को भी रखना चाहिए ताकि छोटे समूहों को समान बड़े समूह समझा न जाए।
क्या कन्फ्यूजन मैट्रिक्स रिग्रेशन का मूल्यांकन कर सकता है?
सीधे नहीं। कन्फ्यूजन मैट्रिक्स को निरंतर वर्गों की आवश्यकता होती है। निरंतर लक्ष्य को बिनिंग करने से जानकारी खो जाती है; रिग्रेशन सामान्यतः अवशेष विश्लेषण और निरंतर मानों के लिए डिज़ाइन किए गए मीट्रिक, जैसे MAE या RMSE, का उपयोग करता है।
प्राथमिक संदर्भ












