
एआई की मूल बातें
भावना विश्लेषण क्या है? विधियाँ, उपयोग और सीमाएँ

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
भाव विश्लेषण पाठ, भाषण प्रतिलिपियों या अन्य सामग्री में मूल्यांकनात्मक भाषा का अनुमान लगाता है। एक प्रणाली सकारात्मक, नकारात्मक या तटस्थ जैसी ध्रुवीयता को वर्गीकृत कर सकती है; पहलू‑स्तर की राय का पता लगा सकती है; तीव्रता का अनुमान लगा सकती है; या किसी विशेष दावे के प्रति रुख की पहचान कर सकती है।
लक्ष्य को सावधानीपूर्वक परिभाषित करना आवश्यक है। भावना (Sentiment) भावनाओं, इरादे, विषाक्तता, संतुष्टि या सत्य के समान नहीं है। एक सकारात्मक वाक्य व्यंग्यात्मक रूप से हानिकारक घटना का वर्णन कर सकता है, जबकि एक नकारात्मक उत्पाद समीक्षा भी कुल मिलाकर उत्पाद की सिफारिश कर सकती है।
मुख्य बिंदु
- उदाहरण एकत्र करने से पहले इकाई, लक्ष्य, लेबल और संदर्भ को परिभाषित करें।
- शब्दकोश पारदर्शी बुनियादी मॉडल होते हैं; पर्यवेक्षित और ट्रांसफ़ॉर्मर मॉडल अधिक संदर्भ को पकड़ सकते हैं लेकिन प्रतिनिधि डेटा की आवश्यकता होती है।
- नकारात्मकता, व्यंग्य, डोमेन शब्दावली, बहुभाषी पाठ और पहलू सीमाएँ अभी भी कठिन हैं।
- प्रति वर्ग, उपसमूह, डोमेन और समय अवधि के अनुसार मूल्यांकन करें; परिणामस्वरूप उपयोगों के लिए मानव समीक्षा शामिल करें।
स्तर और लक्ष्य
दस्तावेज़‑स्तर विश्लेषण पूरे आइटम के लिए एक लेबल उत्पन्न करता है। वाक्य‑स्तर विश्लेषण कथनों को अलग करता है, जबकि पहलू‑आधारित विश्लेषण भावना को किसी इकाई या गुण से जोड़ता है—उदाहरण के लिए, छवि गुणवत्ता के बारे में सकारात्मक लेकिन बैटरी जीवन के बारे में नकारात्मक।
रुख यह पूछता है कि वक्ता किसी विशिष्ट प्रस्ताव का समर्थन करता है या नहीं, जो भावनात्मक स्वर से भिन्न हो सकता है। इन भेदों को पाठ वर्गीकरण विधियों को लागू करने से पहले एनोटेशन गाइड में निर्धारित किया जाना चाहिए।
शब्दकोश, पारंपरिक मॉडल और ट्रांसफ़ॉर्मर
एक शब्दकोश शब्दों को स्कोर असाइन करता है और नकारात्मकता या तीव्रता के नियमों के साथ उन्हें जोड़ता है। यह व्याख्यात्मक और सस्ता है लेकिन संदर्भ में कठिनाई होती है। पारंपरिक पर्यवेक्षित मॉडल शब्द या n‑gram विशेषताओं का उपयोग करते हैं, जबकि ट्रांसफ़ॉर्मर संदर्भात्मक प्रतिनिधित्व सीखते हैं और फाइन‑ट्यून किए जा सकते हैं।
फ्यू‑शॉट प्रॉम्प्टिंग सुविधाजनक हो सकता है, लेकिन आउटपुट उदाहरणों और शब्दावली पर निर्भर करते हैं। प्रत्येक जटिल दृष्टिकोण की तुलना एक बुनियादी मॉडल से करें और फ्यू‑शॉट लर्निंग का उपयोग केवल एक अलग, संस्करणित मूल्यांकन सेट के साथ ही करें।
डेटा और भाषा चुनौतियाँ
लेबल्स एनोटेटर के दृष्टिकोण को प्रतिबिंबित कर सकते हैं न कि एक वस्तुनिष्ठ तथ्य को। डोमेन शिफ्ट गंभीर है: ‘अप्रत्याशित’ फिल्म के लिए प्रशंसा और वाहन के लिए आलोचना दोनों हो सकता है। कोड‑स्विचिंग, बोली, इमोजी, उद्धृत भाषण और व्यंग्य टोकन‑स्तर संकेतों को जटिल बनाते हैं।
वर्गों को जानबूझकर संतुलित करें और संबंधित लेखकों, उत्पादों या वार्तालापों को प्रशिक्षण और परीक्षण के बीच लीक होने से रोकें। एक मॉडल जो किसी ब्रांड या वक्ता को याद रखता है, वह भावना को सीखे बिना भी सटीक दिख सकता है।
मूल्यांकन और जिम्मेदार उपयोग
सटीकता के बजाय प्रिसीजन, रिकॉल, F1 और एक कन्फ्यूज़न मैट्रिक्स रिपोर्ट करें। त्रुटियों की समीक्षा पहलू, लंबाई, बोली और समय के आधार पर करें, और प्रत्येक गलती की परिचालन लागत के लिए थ्रेशोल्ड को कैलिब्रेट करें।
समग्र रुझान शोध या ट्रायेज़ को समर्थन दे सकते हैं, लेकिन किसी व्यक्ति की स्थिति का अनुमान लगाना या रोजगार, क्रेडिट, स्वास्थ्य या पुलिसिंग निर्णय लेना अधिक जोखिम पैदा करता है। अनिश्चितता, स्रोत संदर्भ, गोपनीयता नियंत्रण और मानव समीक्षा प्रदान करें।
एनोटेशन और डेटासेट निर्माण
एक एनोटेशन गाइड लिखें जिसमें लक्ष्य इकाई, विश्लेषण इकाई, लेबल परिभाषाएँ, मिश्रित और तटस्थ संभाल, उद्धरण नियम, व्यंग्य नीति, और डोमेन के उदाहरण शामिल हों। कई एनोटेटरों के साथ पायलट करें, सहमति की गणना करें, असहमति पर चर्चा करें, और लेबल स्केल करने से पहले कार्य को संशोधित करें।
सैंपलिंग निर्धारित करती है कि मॉडल क्या सीखता है। सोशल‑मीडिया स्ट्रीम अत्यधिक सक्रिय खातों को अधिक प्रतिनिधित्व दे सकता है; समर्थन टिकट संतुष्ट ग्राहकों को छोड़ सकते हैं; स्टार रेटिंग समीक्षात्मक पाठ से मेल नहीं खा सकती। स्रोत और समय मेटाडेटा संरक्षित रखें, प्लेटफ़ॉर्म की शर्तों और गोपनीयता का सम्मान करें, और उन जनसंख्या से एक टेस्ट सेट बनाएं जहाँ निर्णय लिए जाएंगे।
लेबल लीक रेटिंग्स, संग्रह प्रणाली द्वारा डाले गए इमोजी, टेम्पलेटेड हस्ताक्षर, या भावना से जुड़े उत्पाद नामों के माध्यम से हो सकता है। निकट‑समान पोस्ट को डिडुप्लिकेट करें और वार्तालापों या लेखकों को समूहित करें ताकि उनकी भाषा विभाजन के दोनों पक्षों में न दिखाई दे।
मॉडलिंग विकल्प और कैलिब्रेशन
शब्दकोश प्रणालियाँ शब्द स्कोर को जोड़ती हैं और नकारात्मकता, तीव्रता, विराम चिह्न या इमोजी के लिए समायोजित करती हैं। वे उपयोगी सत्यापन प्रदान करती हैं और डोमेन शब्दों के साथ अनुकूलित की जा सकती हैं। TF–IDF विशेषताओं वाले रैखिक मॉडल कुछ डेटासेट्स पर प्रतिस्पर्धी रहते हैं और प्रभावशाली n‑gram को उजागर करते हैं।
प्रसंगिक एन्कोडर शब्दों को आसपास के पाठ के अनुसार प्रस्तुत करते हैं और ध्रुवीयता या पहलुओं के लिए फाइन‑ट्यून किए जा सकते हैं। लंबी दस्तावेज़ों को पदानुक्रमिक मॉडलों, वाक्य एकत्रीकरण, या प्रासंगिक भागों की पुनः प्राप्ति की आवश्यकता हो सकती है। बहुभाषी दृष्टिकोण एक साझा मॉडल प्रशिक्षित कर सकते हैं, पिवट भाषा में अनुवाद कर सकते हैं, या स्थानीय मॉडल बनाए रख सकते हैं; प्रत्येक के कवरेज और सांस्कृतिक समझौते होते हैं।
जब स्कोर कार्रवाई को ट्रिगर करते हैं तो प्रायिकता कैलिब्रेशन महत्वपूर्ण है। विश्वसनीयता प्लॉट और अपेक्षित कैलिब्रेशन त्रुटि दर्शाते हैं कि रिपोर्ट किया गया 0.8 भरोसा लगभग 80 प्रतिशत शुद्धता के बराबर है या नहीं। थ्रेशोल्ड मानव समीक्षा के लिए एक परहेज बैंड बना सकते हैं, और जब त्रुटि लागत अलग हो तो अलग थ्रेशोल्ड उचित हो सकते हैं—असमान गुणवत्ता को छुपाने के लिए नहीं।
अनुप्रयोग और सामान्य गलतफहमियां
समग्र भावना थीम को प्राथमिकता देने, अभियान प्रतिक्रियाओं की तुलना करने, या त्वरित सेवा संदेशों को रूट करने में मदद कर सकती है। पहलू विश्लेषण अक्सर समग्र ध्रुवीयता से अधिक उपयोगी होता है क्योंकि यह बताता है कि लोग क्या चर्चा करते हैं। रुझान विश्लेषण को समय के साथ स्थिर सैंपलिंग और लेबल परिभाषाओं की आवश्यकता होती है।
नकारात्मक पोस्ट की प्रचलन को जनसंख्या की राय के बराबर न समझें। पोस्टिंग व्यवहार, बॉट, मॉडरेशन, प्लेटफ़ॉर्म जनसांख्यिकी, अभियान और संग्रह क्वेरी नमूने को आकार देते हैं। एक भावना मॉडल मौन जनसंख्या को नहीं मापता, और शब्दावली में बदलाव को दृष्टिकोण में बदलाव माना जा सकता है।
व्यक्तिगत निर्णयों के लिए, गलत लेबल कलंकित कर सकते हैं और चुनौती देना कठिन हो सकता है। भावना को कर्मचारी जुड़ाव, मानसिक स्वास्थ्य, क्रेडिटवर्थीनेस, इरादा या धोखे का विकल्प बनाने से बचें। जब लोग प्रभावित होते हैं, तो स्रोत संदर्भ दिखाएँ, सुधार की अनुमति दें, और वास्तविक विवेक के साथ एक मानव निर्णयकर्ता की आवश्यकता रखें।
व्यावहारिक उदाहरण: ग्राहक प्रतिक्रिया के लिए भावना विश्लेषण
समर्थन टिप्पणी का विश्लेषण करने वाली कंपनी को निर्धारित करना चाहिए कि उसे दस्तावेज़ भावना, पहलू भावना, भावना, तात्कालिकता या मुद्दा वर्गीकरण चाहिए या नहीं। ‘डिलीवरी तेज़ थी लेकिन उत्पाद टूट गया’ को एक सकारात्मक‑या‑नकारात्मक लेबल से सही ढंग से नहीं दर्शाया जा सकता। लक्ष्य, नकारात्मकता, व्यंग्य, मिश्रित कथन, उद्धृत भाषण और अज्ञात मामलों के लिए एक एनोटेशन गाइड बनाएँ, फिर लेबल को वास्तविक सत्य मानने से पहले सहमति मापें।
एक शब्दकोश या रैखिक बुनियादी मॉडल की तुलना फाइन‑ट्यून किए गए एन्कोडर या प्रॉम्प्टेड भाषा मॉडल से करें। निकट‑डुप्लिकेट लीक से बचने के लिए डेटा को समय या ग्राहक के आधार पर विभाजित करें, और वर्ग की प्रचलन को संरक्षित रखें। प्रिसीजन, रिकॉल, F1, कैलिब्रेशन और भाषा, चैनल, उत्पाद और जनसांख्यिकीय प्रॉक्सी के अनुसार कन्फ्यूज़न रिपोर्ट करें, केवल जहाँ कानूनी और उचित हो। उच्च‑विश्वास त्रुटियों की समीक्षा करें क्योंकि वे स्वचालित रूटिंग में अनिश्चित आउटपुट की तुलना में अधिक खतरनाक होते हैं।
भावना को एकत्रीकरण या प्राथमिकता के लिए एक संकेत के रूप में उपयोग करें, न कि व्यक्ति की स्थिति के निर्विवाद माप के रूप में। शब्दावली और उत्पाद ड्रिफ्ट की निगरानी करें, समीक्षा किए गए उदाहरणों से पुनः प्रशिक्षित करें, और एजेंटों को लेबल सुधारने की अनुमति दें। असत्यापित भावना स्कोर से संरक्षित गुणों का अनुमान न लगाएँ या कर्मचारियों को अनुशासित न करें। कार्यकारी रिपोर्टिंग के लिए नमूना आकार, अनिश्चितता, अनुपलब्ध डेटा और परिवर्तन को चलाने वाले विषय दिखाएँ ताकि बदलता स्कोर जांच की ओर ले जाए न कि सरल निष्कर्ष की ओर।
बहुभाषी तैनाती यह नहीं माननी चाहिए कि इनपुट का अनुवाद स्वर, नकारात्मकता, मुहावरा या सांस्कृतिक परम्परा को बनाए रखता है। प्रत्येक समर्थित भाषा और मिश्रित‑भाषा पैटर्न को मूलभाषी समीक्षकों के साथ सत्यापित करें, और जब प्रमाण कमजोर हो तो अज्ञात परिणाम प्रदान करें। डोमेन अनुकूलन भी महत्वपूर्ण है: सामान्य बातचीत में नकारात्मक लगने वाले शब्द तकनीकी विवरण में तटस्थ हो सकते हैं। अलग थ्रेशोल्ड या मॉडल तभी रखें जब परिचालन प्रमाण अतिरिक्त जटिलता और शासन बोझ को उचित ठहराता हो।
व्यावहारिक कार्यान्वयन चेकलिस्ट
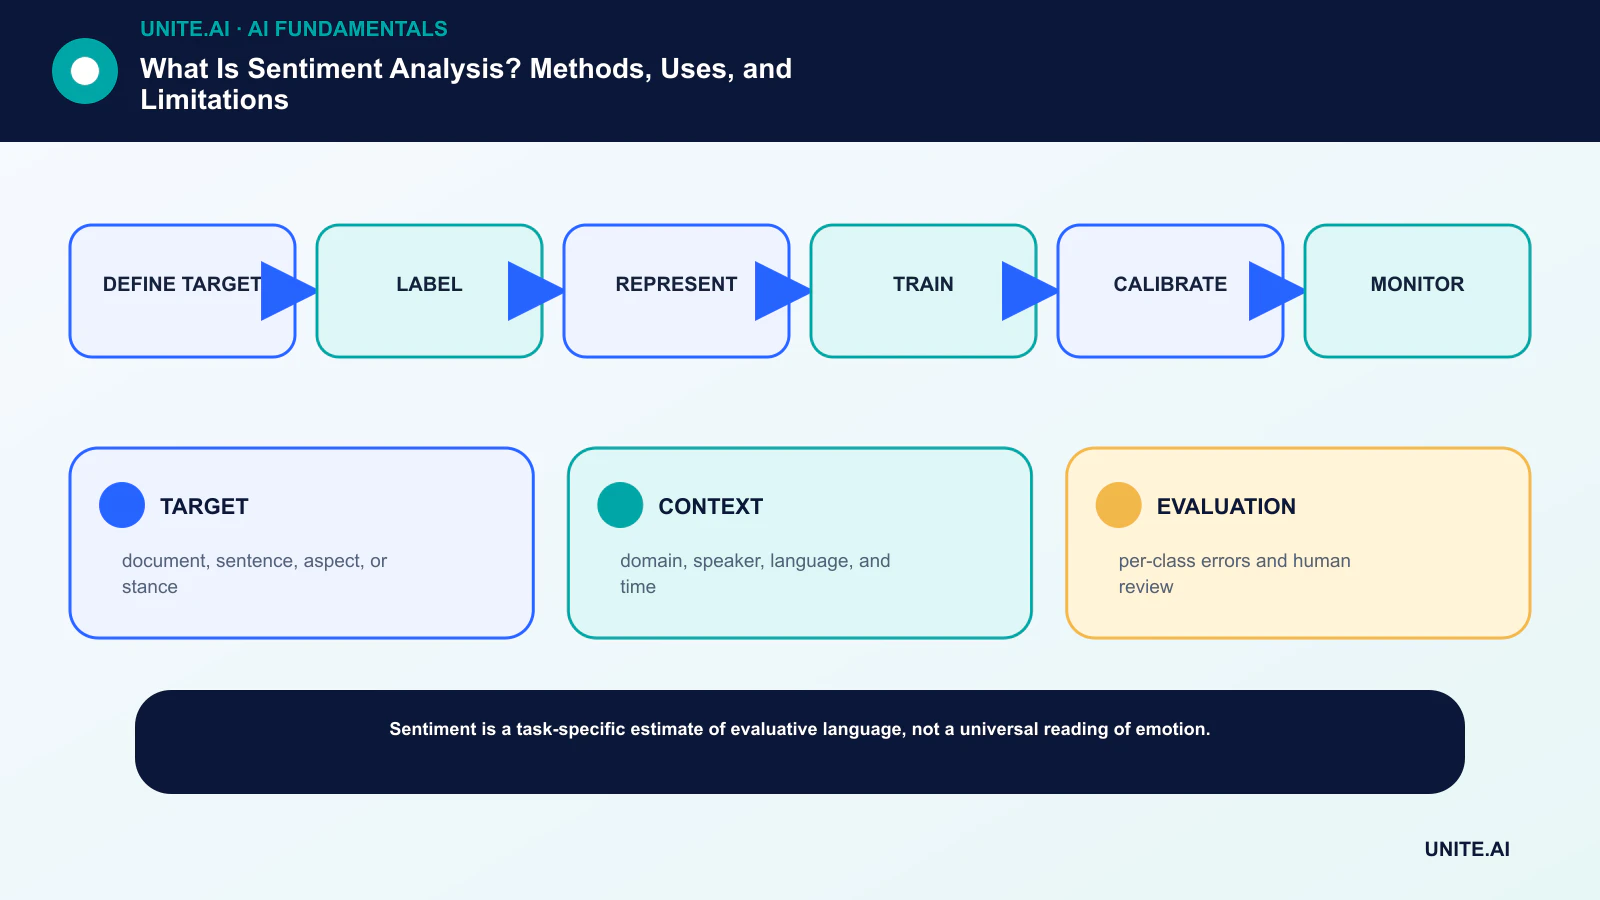
धारणा को सीमित, परीक्षण योग्य कार्यप्रवाह में बदलें: लक्ष्य → लेबल → प्रतिनिधित्व → प्रशिक्षण → कैलिब्रेशन → मॉनिटर निर्धारित करें। एक उत्तरदायी मालिक को नाम दें, डेटा और निर्भरताओं का दस्तावेज़ बनाएं, एक सरल बुनियादी मॉडल स्थापित करें, स्वीकृति और रोक मानदंड सेट करें, प्रतिनिधि विफलताओं का परीक्षण करें, और दायरे को विस्तारित करने से पहले मॉनिटरिंग, रोलबैक और समीक्षा को परिभाषित करें। संस्करण और धारणाओं को रिकॉर्ड करें ताकि अन्य टीम परिणाम को पुन: उत्पन्न कर सके और समझ सके कि क्या बदला।
लॉन्च से पहले, सिस्टम को बनाने, संचालित करने, सुरक्षित रखने और प्रभावित करने वाले लोगों के साथ एक दस्तावेज़ित तत्परता समीक्षा चलाएँ। सामान्य मामलों, सीमा स्थितियों, निर्भरता विफलताओं और दुरुपयोग का परीक्षण करें; साक्ष्य और अनसुलझे जोखिमों को संरक्षित रखें। परिभाषित करें कि कौन रिलीज़ को मंजूरी दे सकता है, थ्रेशोल्ड बदल सकता है, आउटपुट को ओवरराइड कर सकता है, या संचालन रोक सकता है। वास्तविक‑विश्व डेटा आने पर निर्णय को पुनः देखें, क्योंकि तकनीकी रूप से सफल पायलट व्यापक पैमाने पर विश्वसनीय प्रदर्शन की गारंटी नहीं देता।
- TARGET: दस्तावेज़, वाक्य, पहलू, या रुख।
- CONTEXT: डोमेन, वक्ता, भाषा, और समय।
- EVALUATION: प्रति‑वर्ग त्रुटियाँ और मानव समीक्षा।
अक्सर पूछे जाने वाले प्रश्न
क्या भावना विश्लेषण वस्तुनिष्ठ है?
नहीं। यह कार्य और एनोटेशन प्रक्रिया द्वारा परिभाषित लेबल का अनुमान लगाता है। कुछ पाठ वास्तव में अस्पष्ट, मिश्रित, संदर्भ‑निर्भर, या पाठकों द्वारा अलग‑अलग व्याख्यायित होते हैं।
क्या भावना विश्लेषण व्यंग्य का पता लगा सकता है?
मॉडल कुछ पैटर्न सीख सकते हैं, लेकिन व्यंग्य अक्सर वक्ता के इतिहास, साझा ज्ञान और पाठ के बाहर के संदर्भ पर निर्भर करता है। यह एक सामान्य विफलता मोड बना रहता है।
मुख्य संदर्भ












