एआई की मूल बातें
बड़े भाषा मॉडल (LLMs) क्या हैं?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
एक बड़ा भाषा मॉडल (LLM) एक न्यूरल नेटवर्क है जिसे बड़े अनुक्रम संग्रहों पर टोकन या संबंधित भाषा उद्देश्यों की भविष्यवाणी करने के लिए प्रशिक्षित किया गया है। अधिकांश वर्तमान LLM ट्रांसफ़ॉर्मर आर्किटेक्चर का उपयोग करते हैं और एक सामान्य इंटरफ़ेस के माध्यम से भाषा को उत्पन्न, वर्गीकृत, सारांशित, अनुवाद, पुनः प्राप्त और रूपांतरित कर सकते हैं।
एक LLM डेटाबेस या गारंटीकृत तर्ककर्ता नहीं है। इसका आउटपुट प्रशिक्षण डेटा, पोस्ट‑ट्रेनिंग, संदर्भ, उपकरण और डिकोडिंग द्वारा आकारित एक सशर्त भविष्यवाणी है। प्रवाहशीलता तथ्यात्मक त्रुटि, अनिश्चितता, पक्षपात या असुरक्षित व्यवहार के साथ भी सह-अस्तित्व रख सकती है।
मुख्य बिंदु
- टोकनाइज़ेशन पाठ को अलग-अलग इकाइयों में परिवर्तित करता है; एम्बेडिंग और अटेंशन संदर्भात्मक प्रतिनिधित्व बनाते हैं।
- प्रि‑ट्रेनिंग व्यापक पैटर्न सीखती है, जबकि फाइन‑ट्यूनिंग और प्राथमिकता विधियाँ कार्य व्यवहार को आकार देती हैं।
- रिट्रीवल और उपकरण वर्तमान साक्ष्य या क्रियाएँ जोड़ सकते हैं, लेकिन इसके लिए अलग अनुमतियों और सत्यापन की आवश्यकता होती है।
- परिनियोजित प्रणाली का मूल्यांकन गुणवत्ता, आधारभूतता, सुरक्षा, विलंब, लागत और ड्रिफ्ट के लिए करें।
टोकन, ट्रांसफ़ॉर्मर, और प्री‑ट्रेनिंग
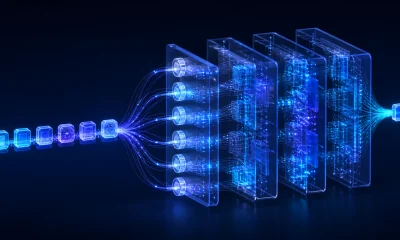
पाठ को टोकनों में विभाजित किया जाता है। एक transformer उन्हें वेक्टर में मैप करता है, अटेंशन और फीड‑फ़ॉरवर्ड लेयरों के माध्यम से जानकारी को मिश्रित करता है, और अगले या अनुपस्थित टोकन पर संभाव्यता वितरण उत्पन्न करता है।
सेल्फ‑सुपरवाइज़्ड उद्देश्यों से कच्चे अनुक्रमों से प्रशिक्षण संकेत बनते हैं। पैरामीटर, डेटा और कंप्यूट में स्केलिंग विभिन्न रेंज में लॉस को पूर्वानुमेय रूप से सुधार सकती है, लेकिन डेटासेट की गुणवत्ता, आर्किटेक्चर, अनुकूलन और मूल्यांकन निर्धारित करते हैं कि व्यावहारिक रूप से कौन सी क्षमताएँ उभरती हैं।
पोस्ट‑ट्रेनिंग और इन्फ़रेंस
इंस्ट्रक्शन ट्यूनिंग प्रदर्शन का उपयोग करती है; प्रेफ़रेंस ऑप्टिमाइज़ेशन आउटपुट को मानव निर्णय या नीति के साथ बेहतर मेल कर सकता है। इन्फ़रेंस के समय, एक प्रॉम्प्ट और बातचीत इतिहास संदर्भ को परिभाषित करते हैं, जबकि टेम्परेचर और सैंपलिंग सेटिंग्स विविधता को प्रभावित करती हैं।
RLHF और समान विधियाँ व्यवहार को आकार देती हैं, न कि पूर्ण तथ्य‑जांचकर्ता स्थापित करती हैं। मॉडल अभी भी एक संभावित लेकिन असमर्थित उत्तर उत्पन्न कर सकता है।
रिट्रीवल, उपकरण, और एजेंट
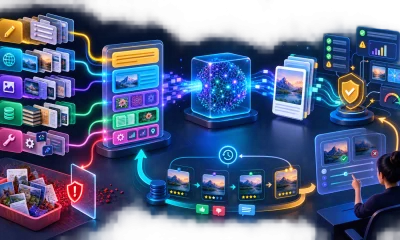
रिट्रीवल‑ऑगमेंटेड जनरेशन बाहरी संग्रह से चयनित अंश प्रदान करता है। टूल कॉलिंग एप्लिकेशन कोड को डेटाबेस क्वेरी करने, गणना करने, खोज करने या कार्रवाई करने देती है। ये पैटर्न कुछ ज्ञान और निष्पादन को मॉडल वज़न से अलग करते हैं।
एप्लिकेशन को टूल आर्ग्यूमेंट्स को मान्य करना चाहिए, अनुमतियों को लागू करना चाहिए, उद्धरणों को संरक्षित करना चाहिए, और पुनः प्राप्त सामग्री को अविश्वसनीय इनपुट के रूप में मानना चाहिए। Vector similarity search रिट्रीवल में मदद करती है लेकिन यह सिद्ध नहीं करती कि कोई अंश उत्तर का समर्थन करता है।
सीमाएँ और मूल्यांकन
LLMs भ्रमित कर सकते हैं, स्मरणित सामग्री को उजागर कर सकते हैं, दुर्भावनापूर्ण निर्देशों का पालन कर सकते हैं, पक्षपात को दोहरा सकते हैं, और उन कार्यों में विफल हो सकते हैं जो प्रशिक्षण उदाहरणों से समान दिखते हैं। लंबा संदर्भ यह गारंटी नहीं देता कि हर तथ्य का सही उपयोग या सामंजस्य किया गया है।
दस्तावेज़ीकृत प्रॉम्प्ट और संस्करणों के साथ प्रतिनिधिक निजी कार्यों पर मूल्यांकन करें। स्रोतों द्वारा समर्थन, अस्वीकार, कैलिब्रेशन, सुरक्षा, उपसमूह परिणाम, मानव कार्यभार, विलंब और लागत को मापें। रिलीज़ के बाद मॉनिटर करें क्योंकि मॉडल, डेटा और उपयोगकर्ता व्यवहार बदलते हैं।
प्रशिक्षण डेटा और मॉडल विकास
प्रि‑ट्रेनिंग कॉर्पोरा वेब पेज, पुस्तकें, कोड, शैक्षणिक सामग्री, बातचीत और लाइसेंस्ड या क्यूरेटेड स्रोतों को मिलाते हैं। पाइपलाइन भाषा का पता लगाती है, डुप्लिकेट हटाती है, गुणवत्ता और असुरक्षित सामग्री को फ़िल्टर करती है, व्यक्तिगत डेटा को संभालती है, और मिश्रण वज़न चुनती है। ये विकल्प ज्ञान, भाषा कवरेज, शैली, पक्षपात और स्मरण को आकार देते हैं।
ऑप्टिमाइज़ेशन प्रक्रियाएँ टोकन अनुक्रमों के बैच बनाती हैं और ग्रेडिएंट डिसेंट के साथ भविष्यवाणी लॉस को न्यूनतम करती हैं। वितरित प्रशिक्षण डेटा, मॉडल टेन्सर, पाइपलाइन चरण या विशेषज्ञों को एक्सेलेरेटरों में विभाजित करता है। स्केल पर चेकपॉइंटिंग, संख्यात्मक स्थिरता, नेटवर्क संचार और त्रुटि पुनर्प्राप्ति प्रमुख इंजीनियरिंग चिंताएँ बन जाती हैं।
प्रशिक्षण के दौरान मूल्यांकन लॉस और क्षमता सूट को ट्रैक करता है, लेकिन बेंचमार्क प्रदूषण परिणामों को बढ़ा सकता है। समय अवधि और स्वामित्व कार्यों को अलग रखें, ओवरलैप की खोज करें, और सटीक प्रॉम्प्ट, डिकोडिंग, टूल और स्कोरिंग की रिपोर्ट करें। एक मॉडल औसत लॉस को सुधार सकता है जबकि सुरक्षा या कम‑संसाधन भाषा में प्रतिगमन दिखाई दे सकते हैं।
संदर्भ विंडो, डिकोडिंग, और इन्फ़रेंस
इन्फ़रेंस के समय, कुंजी‑मान कैश पहले के टोकनों के लिए अटेंशन प्रोजेक्शन संग्रहीत करता है ताकि उन्हें हर चरण में पुनः गणना करने की आवश्यकता न हो। कैश मेमोरी लेयर, अनुक्रम, बैच और प्रतिनिधित्व के साथ बढ़ती है। क्वांटाइज़ेशन और पेजिंग दबाव कम करती हैं लेकिन गुणवत्ता या विलंब को बदल सकती हैं।
ग्रीडी डिकोडिंग सबसे अधिक संभाव्यता वाले टोकन को चुनती है; टेम्परेचर संभावनाओं को पुनः स्केल करता है; टॉप‑k और टॉप‑p उम्मीदवार सेट को सीमित करते हैं; बीम सर्च कई अनुक्रमों को ट्रैक करती है। सर्वोत्तम रणनीति इस पर निर्भर करती है कि कार्य निर्धारण, विविधता, संरचित आउटपुट या अनुक्रम संभावना को महत्व देता है या नहीं। उत्पन्न करने के बाद हमेशा स्कीमा को मान्य करें।
लंबा संदर्भ उपलब्ध जानकारी की मात्रा बढ़ाता है, लेकिन यह याददाश्त या तर्क की गारंटी नहीं देता। स्थिति, विचलन, विरोधाभास और प्रॉम्प्ट संरचना उपयोग को प्रभावित करती है। रिट्रीवल छोटा साक्ष्य सेट चुन सकता है, जबकि सारांश इतिहास को संकुचित करता है जिससे विवरण खोने का जोखिम रहता है। संदर्भ लंबाई और स्थान के अनुसार प्रदर्शन को मापें।
अनुकूलन, परिनियोजन, और आर्थिक पहलू
पूर्ण फाइन‑ट्यूनिंग सभी पैरामीटर अपडेट करता है; पैरामीटर‑कुशल विधियाँ एडैप्टर या लो‑रैंक मैट्रिक्स अपडेट करती हैं; निरंतर प्रि‑ट्रेनिंग डोमेन वितरण को अनुकूलित करती है; इंस्ट्रक्शन और प्रेफ़रेंस ट्यूनिंग प्रतिक्रियाओं को आकार देती हैं। रिट्रीवल अक्सर अक्सर बदलते तथ्यों के लिए बेहतर होता है, जबकि ट्यूनिंग व्यवहार और कार्य प्रारूप के लिए बेहतर है। इन विधियों को संयोजित किया जा सकता है।
परिनियोजन विकल्पों में होस्टेड API, प्रबंधित एंडपॉइंट, स्वयं‑होस्टेड ओपन वेट्स, ऑन‑डिवाइस मॉडल और हाइब्रिड शामिल हैं। डेटा हैंडलिंग, संस्करण नियंत्रण, विलंब, थ्रूपुट, क्षेत्रों, उपलब्धता, मॉडल पोर्टेबिलिटी, समर्थन और कुल लागत की तुलना करें। स्वयं‑होस्टिंग सुरक्षा, स्केलिंग, अपडेट और दुरुपयोग मॉनिटरिंग की ज़िम्मेदारी स्थानांतरित करती है।
प्रति टोकन लागत अधूरी है। एक कमजोर मॉडल को पुनः प्रयास, लंबे प्रॉम्प्ट, अधिक समीक्षा या महंगे त्रुटियों की आवश्यकता हो सकती है। आवश्यक गुणवत्ता और जोखिम स्तर पर सफलतापूर्वक पूर्ण कार्य की लागत को मापें। जब वे संपूर्ण कार्यप्रवाह को सुधारते हैं तो कैशिंग, बैचिंग, छोटे रूटेड मॉडल और निर्धारक कोड का उपयोग करें।
व्यावहारिक उदाहरण: एंटरप्राइज़ दस्तावेज़ों में LLM को ग्राउंड करना
एक दस्तावेज़ सहायक को अनुमति‑सजग कॉर्पस, स्थिर दस्तावेज़ पहचानकर्ता, संस्करण और प्रभावी तिथियों, पार्स करने योग्य संरचना, और उत्तर योग्य, उत्तर न योग्य, अस्पष्ट और विरोधाभासी प्रश्नों के मूल्यांकन सेट से शुरू करना चाहिए। रिट्रीवल चंक और मेटाडेटा को इंडेक्स करता है, लेकिन चंक आकार और ओवरलैप को दस्तावेज़ संरचना से मिलना चाहिए। सर्च गुणवत्ता को जनरेशन से पहले स्वतंत्र रूप से मापा जाता है ताकि प्रवाहशील मॉडल लापता साक्ष्य को छिपा न सके।
रनटाइम पर, उपयोगकर्ता को प्रमाणित करें, एक्सेस के आधार पर रिट्रीवल को फ़िल्टर करें, साक्ष्य को पुनः प्राप्त और पुनः रैंक करें, एक सीमित प्रॉम्प्ट बनाएं, उद्धृत उत्तर उत्पन्न करें, और आवश्यक आउटपुट को मान्य करें। मॉडल को यह बताना चाहिए जब स्रोत विरोधाभासी हों या उत्तर का समर्थन न करें। टूल उपयोग और बाहरी क्रियाओं के लिए अलग प्राधिकरण आवश्यक है। पुनः प्राप्त दस्तावेज़ों में एम्बेडेड निर्देशों से बचाव करें, सामग्री को डेटा के रूप में मानें न कि उच्च‑प्राथमिकता प्रणाली नीति के रूप में।
रिट्रीवल रीकॉल, उद्धरण सटीकता, उत्तर की शुद्धता, ग्राउंडेडनेस, अस्वीकृति, विलंब और लागत को भूमिकाओं और दस्तावेज़ प्रकारों के अनुसार मूल्यांकित करें। प्रत्येक परीक्षण के लिए मॉडल, प्रॉम्प्ट, इंडेक्स, पार्सर और कॉर्पस संस्करणों को ट्रैक करें। उत्पादन में, निजी पाठ को उजागर किए बिना साक्ष्य IDs और फ़ीडबैक को लॉग करें, सामग्री परिवर्तन के बाद नए उत्तर न योग्य प्रश्नों की निगरानी करें, और एक सुरक्षित फ़ॉलबैक बनाए रखें। LLM इंटरफ़ेस रिकॉर्ड प्रबंधन, एक्सेस कंट्रोल या जवाबदेह विषय‑विशेष समीक्षा को प्रतिस्थापित नहीं करता।
क्षमता योजना को प्रॉम्प्ट और आउटपुट लंबाई वितरण, समवर्ती उपयोगकर्ता, कैश व्यवहार, टूल विलंब और पुनः प्रयास दरों को मॉडल करना चाहिए। स्ट्रीमिंग से महसूस किया गया विलंब घटता है लेकिन मॉडरेशन और रद्दीकरण को जटिल बनाता है क्योंकि असुरक्षित या गलत सामग्री पूरी प्रतिक्रिया की जाँच से पहले उपयोगकर्ता तक पहुँच सकती है। टोकन और टूल बजट सेट करें, टेनेंट को अलग करें, प्रदाता क्रेडेंशियल की सुरक्षा करें, और मॉडल संस्करणों के बीच फेलओवर का अभ्यास करें बिना उपयोगकर्ताओं पर निर्भर व्यवहार को चुपचाप बदलें।
व्यावहारिक कार्यान्वयन चेकलिस्ट
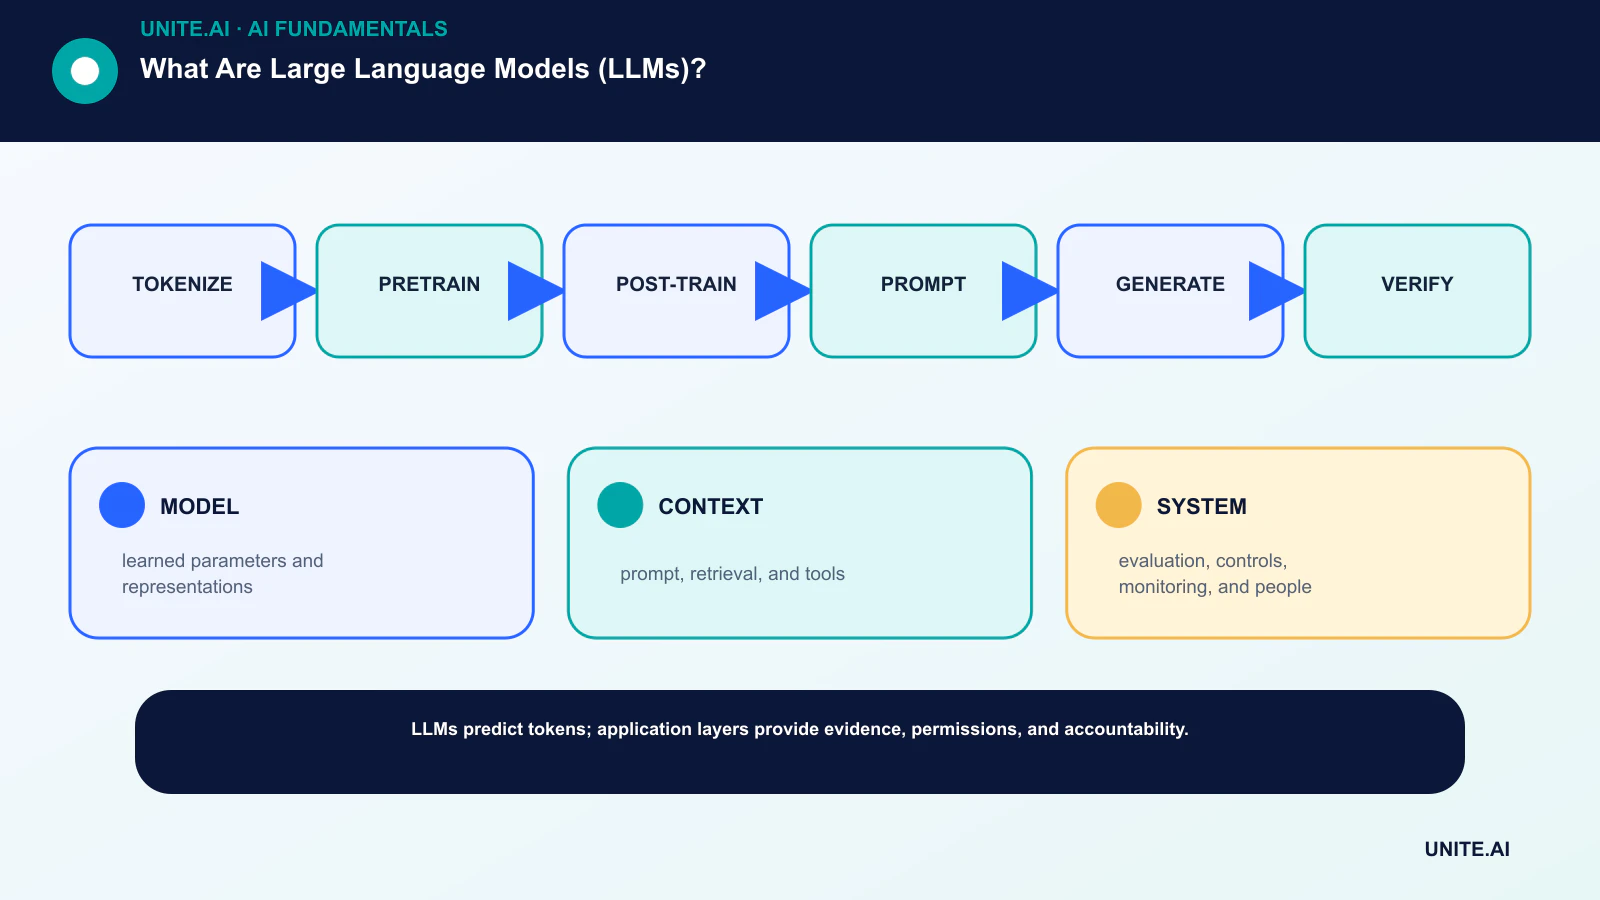
धारणा को एक सीमित, परीक्षण योग्य कार्यप्रवाह में बदलें: tokenize → pretrain → post-train → prompt → generate → verify। एक उत्तरदायी मालिक का नाम रखें, डेटा और निर्भरताओं को दस्तावेज़ित करें, एक सरल बेसलाइन स्थापित करें, स्वीकृति और रोक मानदंड सेट करें, प्रतिनिधिक विफलताओं का परीक्षण करें, और दायरे को विस्तारित करने से पहले मॉनिटरिंग, रोलबैक और समीक्षा को परिभाषित करें। संस्करणों और धारणाओं को रिकॉर्ड करें ताकि दूसरी टीम परिणाम को दोहरा सके और समझे कि क्या बदला।
लॉन्च से पहले, उन लोगों के साथ एक दस्तावेज़ीकृत रेडीनेस समीक्षा चलाएँ जो सिस्टम बनाते, संचालित करते, सुरक्षित करते और उससे प्रभावित होते हैं। सामान्य मामलों, सीमा स्थितियों, निर्भरता विफलताओं और दुरुपयोग का परीक्षण करें; साक्ष्य और अनसुलझे जोखिमों को संरक्षित रखें। निर्धारित करें कि कौन रिलीज़ को मंजूरी दे सकता है, थ्रेशोल्ड बदल सकता है, आउटपुट को ओवरराइड कर सकता है, या संचालन को रोक सकता है। वास्तविक‑विश्व डेटा आने पर निर्णय को पुनः देखें, क्योंकि तकनीकी रूप से सफल पायलट व्यापक स्केल पर विश्वसनीय प्रदर्शन की गारंटी नहीं देता।
- MODEL: सीखे गए पैरामीटर और प्रतिनिधित्व।
- CONTEXT: प्रॉम्प्ट, रिट्रीवल और उपकरण।
- SYSTEM: मूल्यांकन, नियंत्रण, मॉनिटरिंग और लोग।
अक्सर पूछे जाने वाले प्रश्न
LLMs को बड़े क्यों कहा जाता है?
कोई सार्वभौमिक पैरामीटर सीमा नहीं है। ‘बड़े’ शब्द पहले के भाषा मॉडलों की तुलना में स्केल को दर्शाता है, जिसमें पैरामीटर, प्रशिक्षण डेटा, कंप्यूट और उपयोग की व्यापकता शामिल है।
क्या LLMs भाषा को समझते हैं?
वे उपयोगी आंतरिक प्रतिनिधित्व बनाते हैं और जटिल व्यवहार प्रदर्शित करते हैं, लेकिन ‘समझना’ शब्द के कई अर्थ होते हैं। प्रदर्शन को कार्य‑दर‑कार्य दिखाना चाहिए, न कि प्रवाहशीलता से अनुमानित करना चाहिए।
प्राथमिक संदर्भ