एआई की मूल बातें
फ़्यू-शॉट लर्निंग क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
फ़्यू-शॉट लर्निंग यह अध्ययन करती है कि मॉडल केवल कुछ लेबल किए गए उदाहरणों से नई कार्य या वर्ग में कैसे अनुकूलित हो सकता है। क्लासिक बेंचमार्क में, एक एपिसोड सपोर्ट सेट प्रदान करता है—जैसे पाँच वर्ग, प्रत्येक वर्ग में एक या पाँच उदाहरण—और मॉडल को अनदेखे क्वेरीज़ को वर्गीकृत करने को कहता है।
यह शब्द इन-कॉन्टेक्स्ट लर्निंग के लिए भी उपयोग किया जाता है, जहाँ एक प्री‑ट्रेंड भाषा मॉडल अपने प्रॉम्प्ट में कुछ डेमॉन्स्ट्रेशन प्राप्त करता है बिना पैरामीटर अपडेट किए। ये सेटिंग्स कम उदाहरणों वाले लक्ष्य को साझा करती हैं लेकिन अलग अनुकूलन तंत्र उपयोग करती हैं और अलग मूल्यांकन डिज़ाइन की आवश्यकता होती है।
मुख्य बिंदु
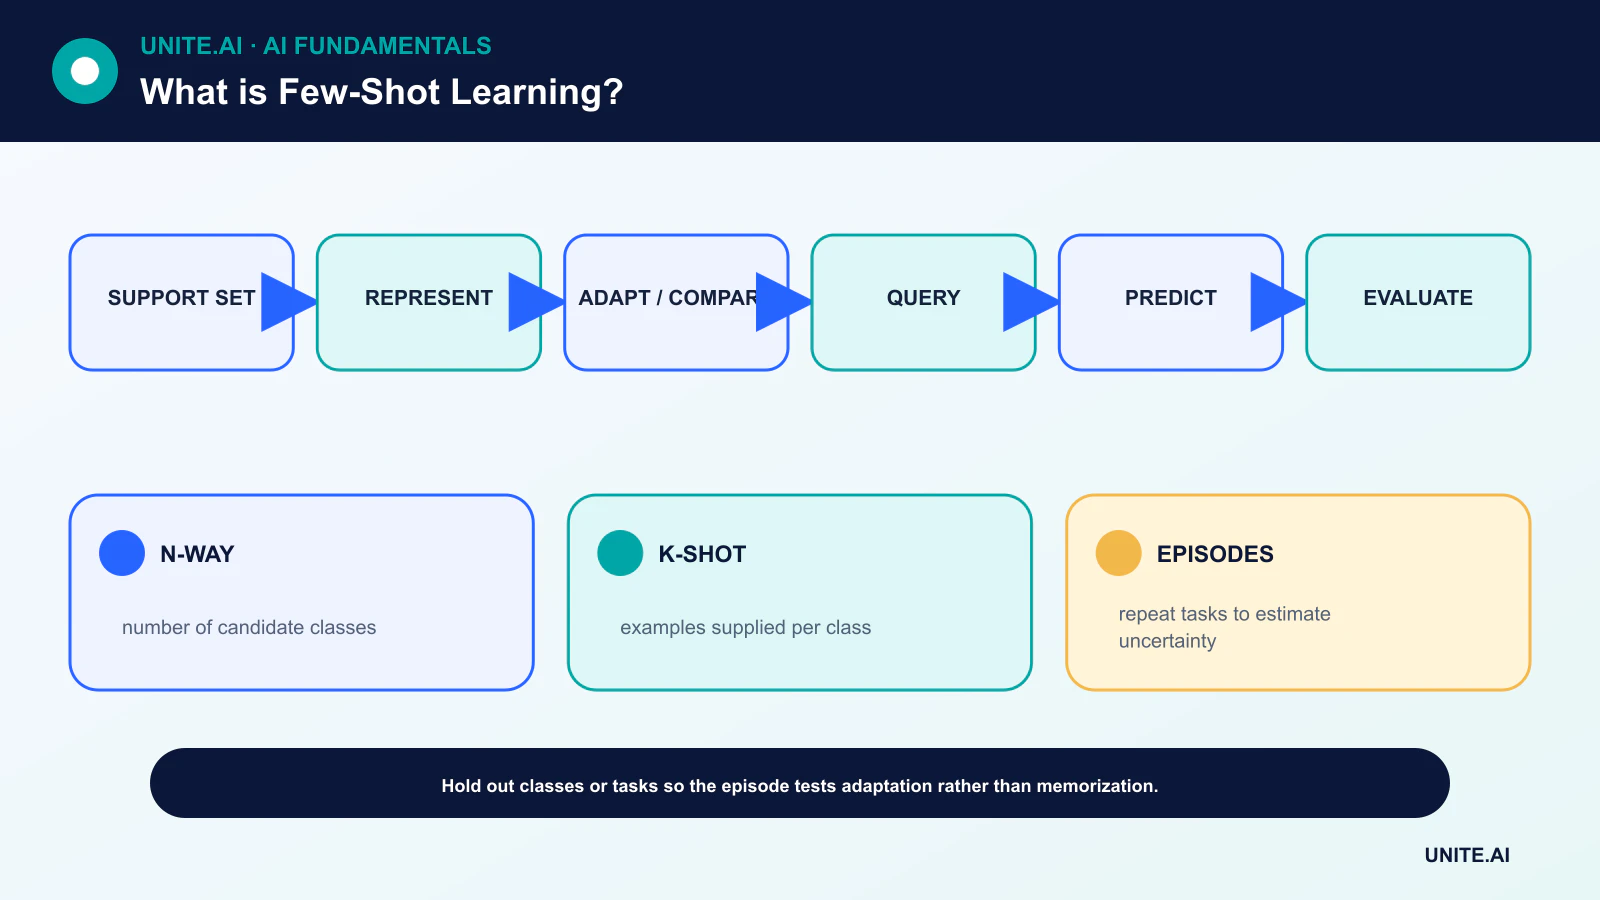
- N-way K-shot N वर्गों और प्रत्येक वर्ग के K लेबल किए गए सपोर्ट उदाहरणों का वर्णन करता है।
- मेट्रिक‑लर्निंग विधियां क्वेरीज़ की तुलना सपोर्ट उदाहरणों के सीखे हुए प्रतिनिधित्व से करती हैं।
- मेटा‑लर्निंग कई कार्यों में अनुकूलन करती है ताकि नया कार्य जल्दी सीखा जा सके।
- कुछ उदाहरण लेबल त्रुटियों, लीक, वर्ग अस्पष्टता और अनिश्चितता को बढ़ा देते हैं, इसलिए बेसलाइन और विश्वास रिपोर्टिंग महत्वपूर्ण हैं।
एपिसोड, सपोर्ट सेट और क्वेरी सेट
एक फ़्यू-शॉट एपिसोड छोटे लेबल किए गए सपोर्ट सेट को मूल्यांकन के लिए उपयोग किए जाने वाले क्वेरी सेट से अलग करता है। मेटा‑ट्रेनिंग के दौरान, मॉडल कई ऐसे एपिसोड देखता है। मजबूत मूल्यांकन पूरे वर्गों, कार्यों या डोमेनों को बाहर रखता है ताकि परीक्षण एपिसोड अनुकूलन को मापे, न कि स्मृति को।
सटीकता वितरण कई एपिसोडों में रिपोर्ट करें, न कि एक सुविधाजनक नमूने में। सरल निकटतम‑पड़ोसी और रैखिक बेसलाइन के साथ तुलना करें; एक परिष्कृत विधि जो एक अच्छी‑तरह से प्रशिक्षित प्रतिनिधित्व और एक बुनियादी वर्गीकारक को नहीं हरा सकती, उसकी जटिलता को उचित नहीं ठहरा सकती।
मेट्रिक लर्निंग और प्रोटोटाइप
मैचिंग नेटवर्क और संबंधित विधियां सपोर्ट और क्वेरी उदाहरणों को ऐसी जगह एम्बेड करती हैं जहाँ निकटवर्ती वेक्टर को समान लेबल साझा करना चाहिए। प्रोटोटाइपिकल नेटवर्क प्रत्येक वर्ग के सपोर्ट एम्बेडिंग का औसत निकालते हैं और क्वेरी को उन वर्ग प्रोटोटाइपों से दूरी के आधार पर वर्गीकृत करते हैं।
यह फ़्यू-शॉट लर्निंग को प्रतिनिधित्व की गुणवत्ता से जोड़ता है। एक प्री‑ट्रेंड डीप-लर्निंग मॉडल पहले से ही प्रासंगिक फीचर्स को अच्छी तरह व्यवस्थित कर सकता है, जबकि असंगत प्रतिनिधित्व हर दूरी को भ्रामक बना सकता है।
ऑप्टिमाइज़ेशन‑आधारित मेटा‑लर्निंग
मॉडल‑एग्नॉस्टिक मेटा‑लर्निंग उन पैरामीटरों की खोज करता है जो कुछ ग्रेडिएंट चरणों से अनुकूलित हो सकते हैं। अन्य विधियां एक ऑप्टिमाइज़र, एक प्रारंभिक बिंदु या एक पैरामीटर अपडेट नियम सीखती हैं। बाहरी लूप कार्यों के बीच अनुकूलन‑के‑बाद प्रदर्शन का मूल्यांकन करता है।
मेटा‑लर्निंग मानता है कि उपयोगी संरचना प्रशिक्षण और लक्ष्य कार्यों के बीच साझा होती है। जब लक्ष्य वितरण में तीव्र अंतर होता है, तो तेज़ अनुकूलन विफल हो सकता है। वैधता को शॉट्स, वर्गों, डोमेनों और कार्य की कठिनाई में विविधता लानी चाहिए, न कि एक बेंचमार्क को सार्वभौमिक मानना चाहिए।
ट्रांसफ़र लर्निंग और डेटा‑स्तरीय रणनीतियां
ट्रांसफ़र लर्निंग अक्सर सबसे मजबूत व्यावहारिक प्रारंभिक बिंदु होता है: एक प्री‑ट्रेंड एन्कोडर को फ्रीज़ करें, एक छोटा हेड प्रशिक्षित करें, फिर यदि पर्याप्त डेटा उपलब्ध हो तो चयनात्मक रूप से फाइन‑ट्यून करें। डेटा ऑग्मेंटेशन इनवेरिएंसेस ला सकता है, लेकिन अवास्तविक सिंथेटिक उदाहरण पक्षपात को बढ़ा सकते हैं या शॉर्टकट बना सकते हैं।
एक्टिव लर्निंग यह प्राथमिकता दे सकता है कि कौन से उदाहरण लेबल किए जाएँ, जबकि सेमी‑सुपरवाइज़्ड लर्निंग अतिरिक्त अनलेबल्ड डेटा का उपयोग कर सकता है। ये पूरक रणनीतियां हैं, फ़्यू‑शॉट लर्निंग के समानार्थक नहीं।
फ़्यू‑शॉट प्रॉम्प्टिंग अलग है
एक ट्रांसफ़ॉर्मर अपने संदर्भ में रखे गए डेमॉन्स्ट्रेशन से पैटर्न निकाल सकता है। कोई स्थायी पैरामीटर अपडेट आवश्यक नहीं है। क्रम, शब्दावली और लेबल संतुलन आउटपुट को काफी बदल सकते हैं, और उदाहरण कंटेक्स्ट विंडो के बड़े हिस्से को खा सकते हैं।
एक प्रतिनिधि मूल्यांकन सेट का उपयोग करें, प्रत्येक प्रॉम्प्ट और डेमॉन्स्ट्रेशन को संस्करणित करें, और ज़ीरो‑शॉट, फ़्यू‑शॉट और फाइन‑ट्यून विकल्पों का परीक्षण करें। एक छोटा सपोर्ट सेट व्यापक जनसंख्या‑व्यापी दावों का समर्थन नहीं करता, विशेषकर दुर्लभ या सुरक्षा‑संकटपूर्ण मामलों के लिए।
फ़्यू‑शॉट लर्निंग प्रतिमान और कार्य निर्माण
फ़्यू‑शॉट लर्निंग का लक्ष्य बहुत कम लेबल किए गए उदाहरणों से कार्य करना है। मेट्रिक‑आधारित विधियों में, एक एन्कोडर उदाहरणों को ऐसी जगह मैप करता है जहाँ निकटतम प्रोटोटाइप या पड़ोसी वर्गों का प्रतिनिधित्व करते हैं। ऑप्टिमाइज़ेशन‑आधारित मेटा‑लर्निंग तेज़ अनुकूलन के लिए एक प्रारंभिक बिंदु या अपडेट नियम प्रशिक्षित करता है। ट्रांसफ़र लर्निंग प्री‑ट्रेंड मॉडल को छोटे लक्ष्य सेट पर फाइन‑ट्यून करता है। इन‑कॉन्टेक्स्ट लर्निंग प्रॉम्प्ट में उदाहरण प्रदान करता है बिना वज़न अपडेट किए। ये तंत्र अलग हैं, इसलिए दावों को यह स्पष्ट करना चाहिए कि पैरामीटर बदलते हैं या नहीं, पहले कौन‑सी ट्रेनिंग हुई, और उदाहरण कैसे चुने गए।
मूल्यांकन को दावे की सामान्यीकरण के अनुसार प्रशिक्षण और परीक्षण वर्गों, कार्यों, विषयों या डोमेनों को अलग करना चाहिए। एक N-way K-shot एपिसोड में N वर्ग और प्रत्येक वर्ग के K सपोर्ट उदाहरण होते हैं, साथ ही स्कोरिंग के लिए क्वेरी उदाहरण। दोहराए गए एपिसोड सपोर्ट चयन से वैरिएंस का अनुमान लगाते हैं। प्रॉम्प्टिंग के लिए, उदाहरण क्रम, लेबल शब्दावली, फॉर्मेट, और डेमॉन्स्ट्रेशन समानता परिणामों को काफी बदल सकती है। समान प्रतिनिधित्व और डेटा बजट का उपयोग करके ज़ीरो‑शॉट, निकटतम‑पड़ोसी, रैखिक‑प्रोब, और सामान्य फाइन‑ट्यून बेसलाइन के साथ तुलना करें।
डेटा गुणवत्ता, अनिश्चितता, और नकारात्मक ट्रांसफ़र
कुछ उदाहरणों के साथ, गलत लेबल वाले या असामान्य मामलों का प्रभाव अत्यधिक होता है। एनोटेशन नियम निर्धारित करें, प्रत्येक सपोर्ट आइटम की जांच करें, और एक अज्ञात या अस्वीकार परिणाम को संरक्षित रखें। डेटा ऑग्मेंटेशन और सिंथेटिक उदाहरण तभी मदद कर सकते हैं जब वे कार्य को संरक्षित रखें और वास्तविक विविधता जोड़ें। एक प्री‑ट्रेंड मॉडल अपने स्रोत डोमेन से शॉर्टकट या पक्षपात ट्रांसफ़र कर सकता है। आउट‑ऑफ़‑डोमेन मामलों, दुर्लभ समूहों, और एक सपोर्ट उदाहरण हटाने की संवेदनशीलता का परीक्षण करें। कार्यों और रैंडम सीड्स के across confidence intervals रिपोर्ट करें, न कि एक अनुकूल प्रॉम्प्ट।
एक्टिव लर्निंग सूचनात्मक मामलों पर लेबल मांग सकता है जबकि सेमी‑सुपरवाइज़्ड विधियां अतिरिक्त धारणाओं के तहत अनलेबल्ड डेटा का उपयोग करती हैं। रिट्रीवल प्रासंगिक डेमॉन्स्ट्रेशन को गतिशील रूप से चुन सकता है लेकिन परीक्षण‑लेबल लीक से बचना चाहिए। अनुकूलन जल्दी ओवरफ़िट हो सकता है, इसलिए अपडेट को सीमित करें, रेग्यूलराइज़ेशन उपयोग करें, और अलग उदाहरणों पर वैधता करें। उच्च‑स्टेक कार्यों के लिए, कुछ लेबल कभी भी स्वायत्त निर्णयों को उचित नहीं ठहराते; मॉडल को प्राथमिकता देने या समीक्षा में सहायता करने के लिए उपयोग करें जब तक पर्याप्त परिणाम प्रमाण मौजूद न हो।
उत्पादन संचालन
बेस मॉडल, एम्बेडिंग या प्रॉम्प्ट टेम्पलेट, डेमॉन्स्ट्रेशन, लेबल स्कीमा, और अनुकूलन पैरामीटरों को संस्करणित करें। उदाहरणों की सुरक्षा करें क्योंकि प्रॉम्प्ट या ग्रेडिएंट संवेदनशील रिकॉर्ड उजागर कर सकते हैं। जैसे ही वर्ग और भाषा बदलती है, प्रदर्शन की निगरानी करें, और स्वचालित सेल्फ‑लेबलिंग के बजाय नियंत्रित समीक्षा के माध्यम से सपोर्ट उदाहरणों को ताज़ा करें। फ़्यू‑शॉट लर्निंग पूर्व संरचना का उपयोग करके लेबल किए गए लक्ष्य की आवश्यकता को कम करता है; यह प्रतिनिधि मूल्यांकन, सावधानीपूर्ण कार्य परिभाषा, डोमेन विशेषज्ञता, या जब नया कार्य उस पूर्व से बाहर हो तो सुरक्षित बैकअप की आवश्यकता को नहीं हटाता।
व्यावहारिक उदाहरण: नई उत्पाद के लिए फ़्यू‑शॉट वर्गीकरण
एक सपोर्ट टीम को एक उत्पाद के लिए रूटिंग लेबल चाहिए जिसमें प्रत्येक समस्या के लिए केवल पाँच समीक्षित उदाहरण हों। यह प्री‑ट्रेंड एम्बेडिंग में निकटतम प्रोटोटाइप, एक रैखिक हेड, पैरामीटर‑कुशल फाइन‑ट्यूनिंग, और इन‑कॉन्टेक्स्ट प्रॉम्प्टिंग की तुलना करता है। उत्पाद परिवार, ग्राहक, और बाद के संदेशों को मेटा‑ट्रेनिंग और मॉडल चयन से बाहर रखा जाता है। दोहराए गए सपोर्ट‑सेट सैंपलिंग वर्ग रिकॉल, कैलिब्रेशन, वैरिएंस, और एक गलत लेबल वाले डेमॉन्स्ट्रेशन की संवेदनशीलता रिपोर्ट करती है।
निम्न‑विश्वास और असमर्थित संदेश सामान्य सपोर्ट की ओर रूट होते हैं, और समीक्षक नियंत्रित कतार के माध्यम से लेबल सुधारते हैं। उदाहरणों को पहचान रहित, संस्करणित किया जाता है, और कभी भी अंतिम परीक्षण सेट से नहीं चुना जाता। मॉनिटरिंग नई शब्दावली, वर्ग दरें, सुधार, और असहमति को ट्रैक करती है। जब पर्याप्त लेबल जमा हो जाते हैं, तो फ़्यू‑शॉट सिस्टम की तुलना सामान्य सुपरवाइज़्ड ट्रेनिंग से की जाती है। तेज़ सेटअप उपयोगी है, लेकिन यदि प्रदर्शन अस्थिर रहता है या नया उत्पाद पूर्व कार्य परिवारों से काफी अलग है तो स्वचालन को उचित नहीं ठहराता।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय को सफल डेमॉन्स्ट्रेशन से अधिक चाहिए। इच्छित उपयोगकर्ताओं, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताओं, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादक बेसलाइन और एक संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपलब्ध इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग, और उन समूहों या वातावरणों का परीक्षण करें जो सबसे अधिक सेवा‑हीन हो सकते हैं। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुन: उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक, और रिटायरमेंट के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित बैकअप संरक्षित रखें, और जानबूझकर इंजेक्टेड विफलताओं के साथ मॉनिटरिंग की पुष्टि करें। परिचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, न कि मानें कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियां, हार्डवेयर, या उद्देश्य बदलें, पुनः‑मूल्यांकन करें। एक बनाए रखा गया सिस्टम दस्तावेज़ीकृत पुनर्प्राप्ति, घटना सीखना, हटाना और रखरखाव प्रक्रियाओं, और एक स्पष्ट बिंदु की आवश्यकता रखता है जहाँ इसे निष्क्रिय या बदलना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या वन‑शॉट लर्निंग फ़्यू‑शॉट लर्निंग के समान है?
वन‑शॉट लर्निंग वह विशेष मामला है जिसमें प्रत्येक वर्ग या कार्य के लिए एक लेबल किया गया सपोर्ट उदाहरण होता है। ज़ीरो‑शॉट लर्निंग में कोई लेबल किया गया लक्ष्य उदाहरण नहीं होता।
क्या फ़्यू‑शॉट लर्निंग डेटा की आवश्यकता को समाप्त कर देती है?
नहीं। यह निर्भरता को प्री‑ट्रेनिंग डेटा, संबंधित कार्यों, प्रतिनिधित्व और धारणाओं की ओर स्थानांतरित करता है। लक्ष्य लेबल कम होते हैं; कुल सीखने का इतिहास आमतौर पर बड़ा होता है।
प्राथमिक संदर्भ