
एआई की मूल बातें
एन्सेम्बल लर्निंग क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
Ensemble learning कई मॉडलों की भविष्यवाणियों को मिलाता है। मुख्य विचार यह है कि विभिन्न त्रुटियों वाले मॉडल अपने आउटपुट को औसत, वोट या मेटा-लर्नर को पास करने पर अधिक सटीक या स्थिर परिणाम दे सकते हैं।
सिर्फ मॉडल जोड़ना पर्याप्त नहीं है। यदि सभी सदस्य एक ही शॉर्टकट सीखते हैं, तो उनकी त्रुटियाँ सहसंबद्ध होंगी और एन्सेम्बल केवल उसी गलती में अधिक आत्मविश्वास दिखा सकता है।
मुख्य निष्कर्ष
- एन्सेम्बल सबसे बेहतर तब काम करते हैं जब प्रत्येक सदस्य मॉडल स्वयं उपयोगी हो और सार्थक रूप से अलग त्रुटियाँ करे।
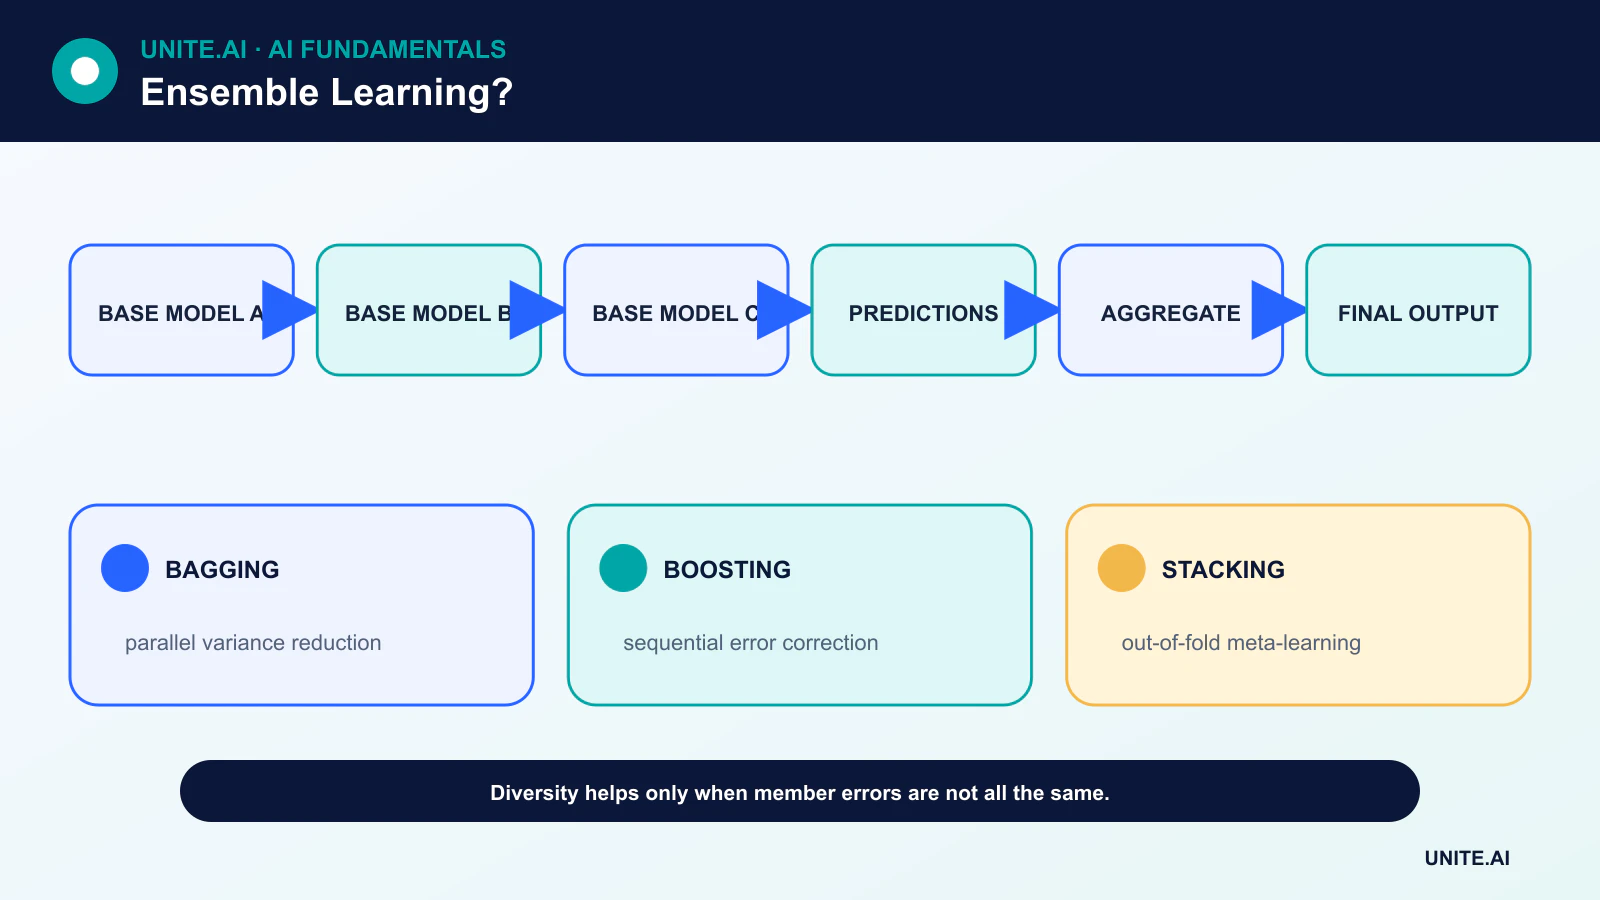
- बैगिंग समानांतर में पुनःसैंपल किए डेटा पर सदस्य को प्रशिक्षित करता है; बूस्टिंग क्रमिक रूप से शिक्षार्थियों को त्रुटियों को सुधारने के लिए प्रशिक्षित करता है।
- स्टैकिंग आउट‑ऑफ‑फ़ोल्ड भविष्यवाणियों पर मेटा‑मॉडल को प्रशिक्षित करता है, न कि इन‑सैंपल भविष्यवाणियों पर।
- सटीकता में वृद्धि को लेटेंसी, कैलिब्रेशन, व्याख्यात्मकता और रखरखाव लागत के साथ तौलना चाहिए।
वोटिंग और औसतकरण
हार्ड वोटिंग सबसे अधिक वोट वाले वर्ग को चुनती है। सॉफ्ट वोटिंग वर्ग संभावनाओं का औसत लेती है, आमतौर पर कैलिब्रेशन के बाद। रिग्रेशन एन्सेम्बल अक्सर संख्यात्मक भविष्यवाणियों का औसत लेते हैं। वेटेड संस्करण मजबूत सदस्यों को अधिक प्रभाव देते हैं।
जब त्रुटियाँ पूरी तरह सहसंबद्ध नहीं होतीं तो औसत करने से वैरिएंस घट सकता है। यह साझा डेटा दोष, लेबल त्रुटि या अनुपस्थित उपसमूह को ठीक नहीं कर सकता। विविधता को असहमति और त्रुटि ओवरलैप के माध्यम से मापा जाना चाहिए, न कि विभिन्न मॉडल नामों से अनुमानित किया जाना चाहिए।
बैगिंग और रैंडम फॉरेस्ट
बूटस्ट्रैप एग्रीगेटिंग पुनःसैंपल किए डेटा सेट पर मॉडल को प्रशिक्षित करता है और उनका औसत लेता है। एक decision tree उच्च वैरिएंस वाला होता है, जिससे यह बैगिंग के लिए स्वाभाविक उम्मीदवार बनता है।
रैंडम फॉरेस्ट विभाजन पर रैंडम फीचर चयन जोड़ते हैं, जिससे पेड़ों के बीच सहसंबंध कम होता है। आउट‑ऑफ‑बैग उदाहरण प्रदर्शन का अनुमान लगा सकते हैं, परन्तु अंतिम अपरिवर्तित टेस्ट सेट मॉडल चयन और डिप्लॉयमेंट दावों के लिए अभी भी मूल्यवान रहता है।
बूस्टिंग
बूस्टिंग चरण‑बद्ध रूप से एक एडिटिव मॉडल बनाता है। बाद के शिक्षार्थी उन उदाहरणों या अवशिष्ट पैटर्न पर ध्यान केंद्रित करते हैं जिन्हें वर्तमान एन्सेम्बल ठीक से संभाल नहीं पाता। AdaBoost उदाहरण वज़न बदलता है; gradient boosting चुने हुए लॉस के नकारात्मक ग्रेडिएंट पर शिक्षार्थियों को फिट करता है।
बूस्टेड ट्री जटिल टेबलर संबंधों को मॉडल कर सकते हैं, लेकिन गहरे ट्री, अत्यधिक राउंड और लीक अभी भी overfit कर सकते हैं। लर्निंग रेट, ट्री की गहराई, सबसैंपलिंग और अर्ली स्टॉपिंग मुख्य नियंत्रण हैं।
स्टैकिंग और ब्लेंडिंग
स्टैकिंग एक द्वितीय‑स्तर मॉडल बनाता है जो बेस भविष्यवाणियों को कैसे मिलाना है सीखता है। लीक से बचने के लिए, मेटा‑मॉडल की प्रत्येक प्रशिक्षण पंक्ति को उस बेस मॉडल से आना चाहिए जिसने उस पंक्ति पर प्रशिक्षण नहीं किया हो। क्रॉस‑वैलिडेशन इन आउट‑ऑफ‑फ़ोल्ड भविष्यवाणियों को उत्पन्न करता है।
ब्लेंडिंग मेटा‑मॉडल के लिए एक अलग होल्डआउट सेट का उपयोग करता है, जो सरल है पर प्रशिक्षण के लिए उपलब्ध डेटा को कम करता है। दोनों दृष्टिकोणों को इन्फरेंस पर समान प्री‑प्रोसेसिंग और संस्करण नियंत्रण की आवश्यकता होती है।
ऑपरेशनल ट्रेड‑ऑफ़
एन्सेम्बल मेमोरी, कंप्यूट और विफलता मोड को कई गुना बढ़ा सकता है। इसे समझाना, कैलिब्रेट करना और लगातार अपडेट करना कठिन हो सकता है। डिस्टिलेशन एन्सेम्बल को छोटे मॉडल में संकुचित कर सकता है, परंतु छात्र मॉडल का स्वतंत्र रूप से मूल्यांकन करना आवश्यक है।
व्यावहारिक चयन प्रदर्शन, टेल लेटेंसी, कैलिब्रेशन, संसाधन उपयोग और त्रुटि लागत की तुलना करता है। कभी‑कभी एक अच्छी तरह नियमित मॉडल एक नाज़ुक स्टैक से छोटे सटीकता लाभ से अधिक पसंद किया जाता है।
एन्सेम्बल क्यों काम करते हैं
एन्सेम्बल लर्निंग कई मॉडलों को मिलाता है जिससे उनकी त्रुटियाँ आंशिक रूप से रद्द हो जाती हैं या उनकी ताकतें विभिन्न क्षेत्रों को कवर करती हैं। बैगिंग पुनःसैंपल किए डेटा पर मॉडल को प्रशिक्षित करता है और भविष्यवाणियों का औसत लेता है, जिससे वैरिएंस घटता है; रैंडम फॉरेस्ट ट्रीज़ को डिकॉरिलेट करने के लिए रैंडम फीचर चयन जोड़ते हैं। बूस्टिंग शिक्षार्थियों को क्रमिक रूप से प्रशिक्षित करता है ताकि अवशिष्ट त्रुटियों पर ध्यान दिया जा सके, अक्सर बायस घटाता है पर शोर और ट्यूनिंग के प्रति संवेदनशीलता बढ़ाता है। स्टैकिंग बेस‑मॉडल भविष्यवाणियों पर मेटा‑मॉडल को प्रशिक्षित करता है। विविधता उपयोगी होनी चाहिए: समान मॉडल का औसत लेना लागत बढ़ाता है पर त्रुटि में अधिक कमी नहीं लाता।
त्रुटियों के बीच सहसंबंध लाभ निर्धारित करता है। विविधता डेटा सैंपल, फीचर, एल्गोरिदम, हाइपरपैरामीटर, रैंडम इनिशियलाइज़ेशन या समय विंडो से आ सकती है। हार्ड वोटिंग आत्मविश्वास को हटाती है; सॉफ्ट वोटिंग संभावनाओं का औसत लेती है पर संगत कैलिब्रेशन आवश्यक है। रिग्रेशन औसत या मजबूत एग्रीगेशन उपयोग कर सकता है। स्टैकिंग में आउट‑ऑफ‑फ़ोल्ड भविष्यवाणियाँ अनिवार्य हैं—एक ही फ़िटेड डेटा से बेस भविष्यवाणियों पर मेटा‑मॉडल को प्रशिक्षित करने से लीक होता है। जटिल संयोजक अपनाने से पहले एक सरल औसत बेसलाइन रखें।
मूल्यांकन, कैलिब्रेशन और अनिश्चितता
प्रत्येक सदस्य और एन्सेम्बल को समान प्री‑प्रोसेसिंग के साथ होल्ड‑आउट सेट पर तुलना करें। कार्य मीट्रिक, कैलिब्रेशन, उपसमूह त्रुटियाँ, फ़ोल्ड या सीड्स में वैरिएंस, और संसाधन लागत रिपोर्ट करें। एन्सेम्बल औसत गुणवत्ता सुधार सकता है जबकि सामान्य डेटा या लेबल द्वारा उत्पन्न साझा ब्लाइंड स्पॉट को छिपा सकता है। असहमति की जाँच करें: यह अनिश्चितता पहचान सकती है, परन्तु सहसंबद्ध आत्मविश्वास‑भरी गलत मॉडल भी सहमत हो सकते हैं। अंतिम एन्सेम्बल को कैलिब्रेट करें, केवल सदस्यों को नहीं, और समीक्षा क्षमता व परिणामों के विरुद्ध एब्स्टेंशन थ्रेशोल्ड को मान्य करें।
आउट‑ऑफ‑बैग अनुमान बैग्ड मॉडलों के लिए उपयोगी हैं पर अंतिम डिप्लॉयमेंट‑प्रतिनिधि टेस्ट को नहीं बदलते। समय‑संबंधी डेटा के लिए, क्रम तोड़ने वाले री‑सैंपलिंग से बचें। सुरक्षा‑संबंधी उपयोग में, सदस्य विफलता, पुराने मॉडल और एडवर्सेरियल इनपुट का परीक्षण करें। जब कई उम्मीदवारों को आज़माया जाता है तो वेटेड एन्सेम्बल वैलिडेशन डेटा पर ओवरफ़िट हो सकते हैं। उम्मीदवार चयन को रिकॉर्ड करें और जहाँ ट्यूनिंग व्यापक हो वहाँ नेस्टेड वैलिडेशन उपयोग करें।
सर्विंग और रखरखाव
एन्सेम्बल मेमोरी, लेटेंसी, ऊर्जा और ऑपरेशनल निर्भरताओं को कई गुना बढ़ाते हैं। डिस्टिलेशन संयुक्त व्यवहार को एक मॉडल में संकुचित कर सकता है, जिसके लिए नई वैलिडेशन आवश्यकता होती है। सदस्यों, प्री‑प्रोसेसिंग, वज़न और रूटिंग को एक ही आर्टिफैक्ट के रूप में संस्करणित करें; जब कोई सदस्य टाइम‑आउट हो या अमान्य परिणाम दे तो व्यवहार निर्धारित करें। सदस्य भविष्यवाणियों और असहमति की निगरानी करें ताकि मौन विफलता दिखाई दे। अनावश्यक सदस्यों को हटाएँ और जानबूझकर पुनः‑ट्रेन करें। एन्सेम्बल तब भविष्यवाणी सुधारते हैं जब त्रुटि विविधता वास्तविक हो, पर वे पक्षपाती प्रशिक्षण डेटा या अमान्य लक्ष्य को विश्वसनीय प्रमाण नहीं बना सकते।
व्यावहारिक उदाहरण: गंभीर मौसम अलर्ट के लिए एन्सेम्बल
एक फोरकास्टिंग टीम भौतिक‑मॉडल फीचर सेट, ग्रेडिएंट‑बूस्टेड ट्री, न्यूरल सीक्वेंस मॉडल और कैलिब्रेटेड सांख्यिकीय बेसलाइन को मिलाती है। आउट‑ऑफ‑फ़ोल्ड भविष्यवाणियाँ एक सरल मेटा‑मॉडल को प्रशिक्षित करती हैं, और मूल्यांकन में भविष्य के तूफ़ानों को शामिल किया जाता है जो सदस्य प्रशिक्षण से पूरी तरह बाहर रखे गए हैं। मीट्रिक में इवेंट रिकॉल, फॉल्स अलार्म, लीड टाइम, कैलिब्रेशन, भौगोलिक प्रदर्शन और दुर्लभ चरम स्थितियों में विश्वसनीयता शामिल हैं। सदस्य त्रुटि सहसंबंध की जाँच की जाती है क्योंकि साझा इनपुट डेटा साझा ब्लाइंड स्पॉट बना सकता है।
सर्विंग प्रत्येक भविष्यवाणी और संयुक्त परिणाम को रखती है। यदि कोई सदस्य उपलब्ध नहीं है, तो सिस्टम मौन री‑नॉर्मलाइज़ करने के बजाय पूर्व‑मान्यताप्राप्त घटित कॉन्फ़िगरेशन का उपयोग करता है। असहमति अतिरिक्त समीक्षा को प्रेरित करती है पर सभी मामलों में इसे अनिश्चितता नहीं माना जाता। मॉनिटरिंग सदस्य ड्रिफ्ट, लेटेंसी और तूफ़ान परिणामों को ट्रैक करती है, वज़न केवल नियंत्रित वैलिडेशन के माध्यम से अपडेट होते हैं। सार्वजनिक चेतावनियाँ अधिकृत मौसम विज्ञान निर्णय प्रक्रियाओं के तहत रहती हैं; एन्सेम्बल प्रमाण बढ़ाता है पर स्वायत्त रूप से अलर्ट नीति को पुनः परिभाषित नहीं करता।
कार्यान्वयन प्रमाण और ऑपरेशनल तत्परता
एक प्रोडक्शन निर्णय को सफल डेमो से अधिक चाहिए। इच्छित उपयोगकर्ताओं, ऑपरेटिंग वातावरण, इनपुट, आउटपुट, निर्भरताओं, मालिक और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले पुनरुत्पादनीय बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य केस, सीमा स्थितियों, विकृत या अनुपस्थित इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग और उन समूहों या वातावरणों का परीक्षण करें जो सबसे अधिक सेवा‑हीन हो सकते हैं। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि स्वतंत्र समीक्षक परिणाम को पुनः उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक और रिटायरमेंट के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट उपयोग करें, एक सुरक्षित फॉलबैक रखें, और जानबूझकर इंजेक्टेड फेल्योर के साथ मॉनिटरिंग को सत्यापित करें। ऑपरेशनल टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर डिप्लॉयमेंट के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें बजाय यह मानने के कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियाँ, हार्डवेयर या लक्ष्य बदलें, पुनः‑मूल्यांकन करें। एक बनाए रखा गया सिस्टम दस्तावेज़ीकृत रिकवरी, घटना सीख, डिलीशन और रिटेंशन प्रक्रियाएँ, तथा एक स्पष्ट बिंदु चाहिए जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या रैंडम फॉरेस्ट एक एन्सेम्बल है?
हां। यह कई रैंडमाइज़्ड decision trees को मिलाता है, आमतौर पर वोटिंग या औसतकरण द्वारा।
क्या समान मॉडल एक उपयोगी एन्सेम्बल बना सकते हैं?
यदि प्रशिक्षण डेटा, इनिशियलाइज़ेशन या सैंपलिंग पर्याप्त रूप से अलग त्रुटियाँ उत्पन्न करती हैं तो वे बना सकते हैं, पर केवल डुप्लिकेशन से कोई लाभ नहीं मिलता।
प्राथमिक संदर्भ












