
एआई की मूल बातें
बेयस प्रमेय क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
बेयस प्रमेय यह वर्णन करता है कि साक्ष्य देखे जाने के बाद परिकल्पना की संभाव्यता को कैसे अद्यतन किया जाता है। यह परिकल्पना के दिए गए साक्ष्य की संभाव्यता को साक्ष्य के दिए गए परिकल्पना की संभाव्यता से जोड़ता है।
यह अंतर सांख्यिकीय तर्क और मशीन लर्निंग के लिए केंद्रीय है। एक परीक्षण बहुत सटीक हो सकता है जब कोई स्थिति मौजूद हो, जबकि सकारात्मक परिणाम फिर भी स्थिति को इंगित करने की मध्यम संभाव्यता रखता है यदि वह स्थिति दुर्लभ हो।
मुख्य बिंदु
- पोस्टेरियर पूर्वविश्वास को देखे गए साक्ष्य की संभावना के साथ मिलाता है।
- साक्ष्य पद संभाव्य परिकल्पनाओं को सामान्यीकृत करता है।
- आधार दरें स्पष्ट रूप से मजबूत साक्ष्य को भी हावी कर सकती हैं।
- नैव बेयस मानता है कि विशेषताएँ वर्ग के दिए जाने पर शर्तीय रूप से स्वतंत्र होती हैं, न कि हर परिस्थिति में स्वतंत्र।
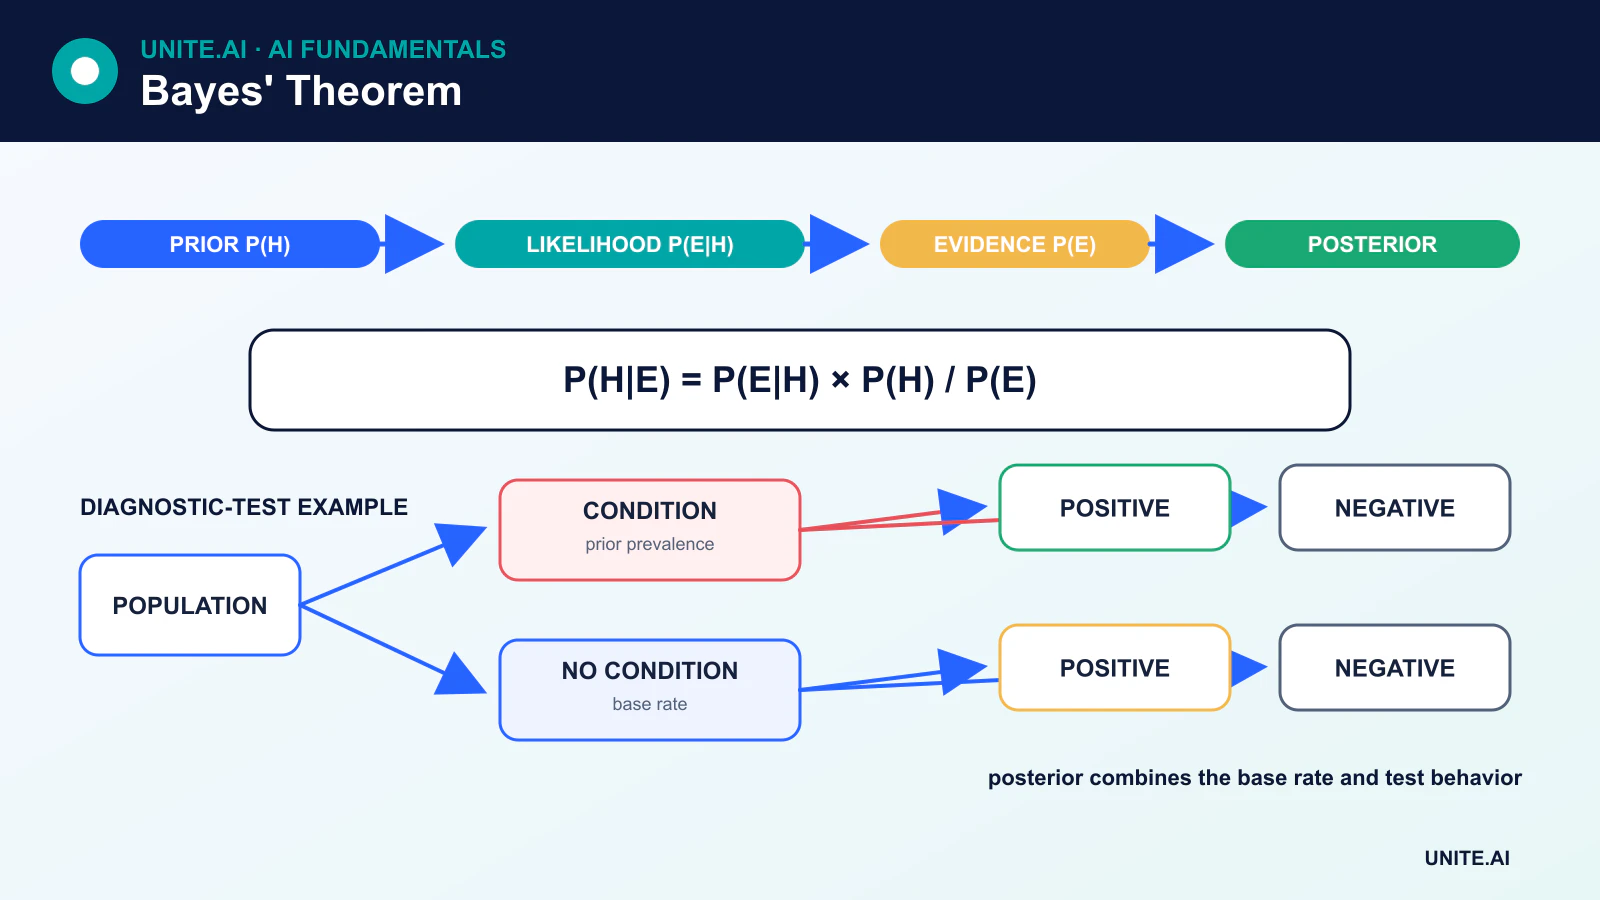
सूत्र
P(A|B) = P(B|A)P(A) / P(B)
- P(A) परिकल्पना A की पूर्व संभाव्यता है।
- P(B|A) वह संभावना है कि साक्ष्य B देखा जाए यदि A सत्य है।
- P(B) साक्ष्य की समग्र संभाव्यता है।
- P(A|B) वह पोस्टेरियर संभाव्यता है जो B देखे जाने के बाद A की होती है।
प्रमेय दो समान अभिव्यक्तियों से प्राप्त होता है जो संयुक्त संभाव्यता को दर्शाती हैं: P(A ∩ B) = P(B|A)P(A) और P(A ∩ B) = P(A|B)P(B)।
एक संख्यात्मक आधार-दर उदाहरण
मान लीजिए कोई स्थिति जनसंख्या के 1% को प्रभावित करती है। एक परीक्षण की संवेदनशीलता 90% है और झूठी सकारात्मक दर 5% है। 1,000 लोगों पर विचार करें:
- लगभग 10 लोगों को यह स्थिति है; परीक्षण सही ढंग से 9 को चिन्हित करता है।
- लगभग 990 लोग नहीं हैं; 5% झूठी सकारात्मक दर लगभग 50 को चिन्हित करती है।
- इस प्रकार लगभग 59 सकारात्मक परिणाम होते हैं, जिनमें से 9 वास्तविक सकारात्मक हैं।
सकारात्मक परिणाम के बाद स्थिति की संभाव्यता लगभग 9 / 59 ≈ 15% है, न कि 90%। परीक्षण की संवेदनशीलता P(positive | condition) का उत्तर देती है; उपयोगकर्ता आमतौर पर P(condition | positive) चाहता है। बेयस प्रमेय आधार दर का उपयोग करके इन्हें जोड़ता है।
बेयesian अद्यतन
जैसे-जैसे नया साक्ष्य आता है, पोस्टेरियर अगली अद्यतन के लिए पूर्व (प्रायर) बन सकता है। एक पूर्ण बेयesian मॉडल संभावित परिकल्पनाओं, पूर्व वितरणों, संभावना (likelihood) और अनुमानित मात्रा को निर्दिष्ट करता है। अनिश्चितता को केवल बिंदु अनुमान के बजाय पोस्टेरियर वितरण द्वारा दर्शाया जाता है।
पूर्व को दस्तावेज़ित किया जाना चाहिए और संवेदनशीलता के लिए परीक्षण किया जाना चाहिए। एक कमजोर सूचना वाला पूर्व अविश्वसनीय मानों को नियमित कर सकता है, जबकि खराब चुना गया मजबूत पूर्व सीमित डेटा पर हावी हो सकता है।
नैव बेयस वर्गीकर्ता
नैव बेयस बेयस प्रमेय और निम्नलिखित अनुमान का उपयोग करके विशेषताएँ x₁ … xₙ से वर्ग y की भविष्यवाणी करता है:
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
विशेषताओं को यह मान लिया जाता है कि वर्ग ज्ञात होने के बाद शर्तीय रूप से स्वतंत्र हैं। यह अक्सर अवास्तविक होता है, फिर भी वर्ग स्कोर उपयोगी रहने पर वर्गीकर्ता अच्छा काम कर सकता है।
सामान्य प्रकार
- Multinomial Naive Bayes मल्टिनॉमियल नैव बेयस गिनती-सम प्रकार की विशेषताओं को मॉडल करता है और दस्तावेज़ वर्गीकरण में सामान्य है।
- Bernoulli Naive Bayes बर्नौली नैव बेयस द्विआधारी विशेषता उपस्थिति को मॉडल करता है।
- Gaussian Naive Bayes गॉसियन नैव बेयस प्रत्येक निरंतर विशेषता को वर्ग-शर्तीय गॉसियन वितरण के साथ मॉडल करता है।
- Categorical Naive Bayes कैटेगोरिकल नैव बेयस विविक्त श्रेणियों को मॉडल करता है।
स्मूथिंग और संख्यात्मक स्थिरता
यदि प्रशिक्षण में कोई विशेषता मान कभी भी किसी वर्ग के साथ नहीं आता है, तो बिना स्मूथिंग के संभाव्यता अनुमान शून्य हो सकता है और पूरे गुणनफल को समाप्त कर देता है। जोड़ात्मक या लैप्लास-शैली की स्मूथिंग इसे रोकती है। कार्यान्वयन लोग संभाव्यताएँ गणना करते हैं ताकि कई छोटे मानों का गुणन स्थिर लोग मानों के जोड़ में बदल जाए।
संभाव्यताएँ, स्कोर, और कैलिब्रेशन
नैव बेयस संभाव्यता आउटपुट खराब कैलिब्रेटेड हो सकते हैं क्योंकि सहसंबद्ध विशेषताओं को प्रभावी रूप से कई बार गिना जाता है। एक वर्गीकर्ता वर्गों को अच्छी तरह क्रमबद्ध कर सकता है जबकि आत्मविश्वास को अधिक दर्शाता है। जब संभाव्यताएँ निर्णयों को संचालित करती हैं, तो कैलिब्रेशन को अलग रखे डेटा पर मूल्यांकन किया जाना चाहिए।
बेयस, नैव बेयस से परे
बेयesian अनुमान पदानुक्रमित मॉडलों, A/B परीक्षणों, वैज्ञानिक पैरामीटर अनुमान, पूर्वानुमान, अनिश्चितता-समझ निर्णय निर्माण, और संभाव्यात्मक ग्राफिकल मॉडलों को समर्थन देता है। जब पोस्टेरियर को बंद रूप में गणना नहीं किया जा सकता, तो मार्कोव चेन मॉन्टे कार्लो और वैरिएशनल इनफ़रेंस जैसी अनुमानित विधियों का उपयोग किया जाता है।
सामान्य तर्क त्रुटियाँ
- P(A|B) को P(B|A) के साथ भ्रमित करना।
- दुर्लभ या सामान्य आधार दर को अनदेखा करना।
- पूर्व को वस्तुनिष्ठ मानना या उसे बिना दस्तावेज़ के छोड़ देना।
- उच्च संभावना को स्वचालित रूप से उच्च पोस्टेरियर मान लेना।
- एक भविष्यवाणी संबंध को कारणत्व के रूप में व्याख्या करना।
शर्तीय संभाव्यता, ऑड्स, और साक्ष्य
बेयस प्रमेय साक्ष्य के बाद परिकल्पना की संभाव्यता को उसके पूर्व संभाव्यता, परिकल्पना के तहत साक्ष्य को देखने की संभावना, और साक्ष्य की कुल संभाव्यता से जोड़ता है। ऑड्स रूप में, पोस्टेरियर ऑड्स पूर्व ऑड्स को संभावना अनुपात से गुणा करने के बराबर होते हैं। यह परीक्षण से पहले क्या माना गया था और परीक्षण कितनी तीव्रता से परिकल्पनाओं को अलग करता है, को अलग करता है। जब स्थिति दुर्लभ होती है, तो आधार दर पोस्टेरियर में प्रवेश करने के कारण अत्यधिक सटीक दिखने वाला परीक्षण भी कई झूठी सकारात्मक उत्पन्न कर सकता है।
संभावना (likelihood) एक स्थिर देखे गए डेटा के लिए परिकल्पना का फलन है और इसे परिकल्पना की संभाव्यता के साथ भ्रमित नहीं करना चाहिए। साक्ष्य का सामान्यीकरण प्रतिस्पर्धी परिकल्पनाओं के बीच योग या समाकलन करता है। शर्तीय स्वतंत्रता मान्यताएँ, जैसा कि नैव बेयस में, गणना को सरल बना सकती हैं, परन्तु उनके परिणामों के विरुद्ध जाँचनी चाहिए। कई साक्ष्य टुकड़े स्वतंत्र के रूप में गुणा नहीं किए जा सकते जब वे कारण साझा करते हों या जानकारी दोहराते हों। कारणात्मक दिशा भी महत्वपूर्ण है: P(evidence|hypothesis) सामान्यतः P(hypothesis|evidence) नहीं होता, यह क्लासिक उल्टी-सम्भावना त्रुटि है।
मॉडलिंग विकल्प, गणना, और निर्णय उपयोग
बेयesian विश्लेषण एक पूर्व, संभावना, और पोस्टेरियर भविष्यवाणी वितरण निर्दिष्ट करता है। पूर्व स्थापित ज्ञान को एन्कोड कर सकते हैं, छोटे नमूनों को नियमित कर सकते हैं, या कमजोर सूचना वाले हो सकते हैं; उन्हें संवेदनशीलता विश्लेषण के माध्यम से उचित ठहराया और परीक्षण किया जाना चाहिए। संयुग्म मॉडल विश्लेषणात्मक अद्यतन प्रदान करते हैं, जबकि मार्कोव चेन मॉन्टे कार्लो, वैरिएशनल इनफ़रेंस, और क्रमिक विधियाँ जटिल पोस्टेरियर्स का अनुमान लगाती हैं। संगति, प्रभावी नमूना आकार, अनुमान त्रुटि, और पूर्व भविष्यवाणी की विश्वसनीयता का निदान करें, बजाय इसके कि बिना गणना जांच के केवल पोस्टेरियर संख्या रिपोर्ट की जाए।
एक पोस्टेरियर संभाव्यता जानकारी देती है परन्तु अकेले ही कार्रवाई का चयन नहीं करती। निर्णयों के लिए हानि, लाभ, प्रतिबंध, और उपलब्ध विकल्प आवश्यक होते हैं। संभाव्यात्मक मॉडलों का मूल्यांकन कैलिब्रेशन, उचित स्कोरिंग नियम, और नए डेटा पर पोस्टेरियर भविष्यवाणी जांचों के साथ करें। केवल उसी साक्ष्य के साथ अद्यतन करें जो मॉडल प्रक्रिया के तहत एकत्र किया गया हो; चयन पक्षपात और डेटा सेट शिफ्ट संभावना को अमान्य कर सकते हैं। विश्वसनीय अंतराल और मान्यताओं को इस प्रकार संप्रेषित करें कि उन्हें गारंटीकृत आवृत्ति सीमा न माना जाए। बेयस प्रमेय सटीक संभाव्यता बीजगणित है, जबकि बेयesian निष्कर्ष की गुणवत्ता मॉडल और प्रदान किए गए साक्ष्य पर निर्भर करती है।
व्यावहारिक उदाहरण: निदान परीक्षण की व्याख्या
एक परीक्षण की संवेदनशीलता 95% और विशिष्टता 90% है, परन्तु स्थिति केवल 1% स्क्रीन किए गए जनसंख्या को प्रभावित करती है। 10,000 लोगों के लिए, लगभग 95 वास्तविक सकारात्मक और 990 झूठी सकारात्मक अपेक्षित हैं, जिससे सकारात्मक भविष्यवाणी मान 9% से कम होता है। बेयस प्रमेय आधार-दर प्रभाव को स्पष्ट करता है। गणना जनसंख्या, परीक्षण थ्रेशहोल्ड, और अनिश्चितता को दर्शाती है, न कि संवेदनशीलता को इस बात के रूप में विज्ञापित करती है कि सकारात्मक परिणाम सही है। यह अंतर सावधानीपूर्ण डेटा साइंस के लिए भी मूलभूत है।
क्लिनिशियन केवल तब अतिरिक्त साक्ष्य के साथ संभाव्यता को अद्यतन करते हैं जब परीक्षणों के बीच निर्भरता को मॉडल किया गया हो। एक निर्णय थ्रेशहोल्ड में छूटी बीमारी का नुकसान, पुष्टि परीक्षण जोखिम, लागत, और रोगी की पसंद शामिल होती है। स्थानीय जनसंख्या में कैलिब्रेशन जाँच की जाती है, और प्रचलन में परिवर्तन समीक्षा को ट्रिगर करता है। पोस्टेरियर चर्चा और अगले कदमों का समर्थन करता है; यह पुष्टि निदान को प्रतिस्थापित नहीं करता। रिपोर्टिंग प्राकृतिक आवृत्तियों और संवेदनशीलता विश्लेषण का उपयोग करती है ताकि रोगी और चिकित्सक देख सकें कि निष्कर्ष संभाव्य मान्यताओं के तहत कैसे बदलता है।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय को सफल प्रदर्शन से अधिक की आवश्यकता होती है। इरादे वाले उपयोगकर्ताओं, संचालन पर्यावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले पुनरुत्पादनीय बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा शर्तों, विकृत या अनुपलब्ध इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग, और उन समूहों या पर्यावरणों का परीक्षण करें जो सबसे अधिक सेवा रहित हो सकते हैं। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, विलंब, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक रूपांतरण और थ्रेशहोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुन: उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक, और सेवानिवृत्ति के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित बैकअप रखें, और जानबूझकर डाले गए विफलताओं के साथ मॉनिटरिंग सत्यापित करें। परिचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशहोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, न कि यह मानते हुए कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियाँ, हार्डवेयर, या उद्देश्य बदलें, पुनर्मूल्यांकन करें। एक रखरखाव वाला सिस्टम दस्तावेज़ित पुनर्प्राप्ति, घटना सीखना, हटाने और रखरखाव प्रक्रियाओं, और एक स्पष्ट बिंदु की भी आवश्यकता रखता है जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
संभावना (likelihood) और संभाव्यता (probability) में क्या अंतर है?
पैरामीटर स्थिर होने पर, मॉडल संभावित डेटा को संभाव्यता देता है। देखे गए डेटा स्थिर होने पर, वही अभिव्यक्ति संभाव्य पैरामीटर मानों पर संभावना फ़ंक्शन (likelihood) के रूप में देखी जा सकती है। संख्यात्मक सूत्र समान हो सकता है जबकि व्याख्या भिन्न होती है।
क्या नैव बेयस पूर्ण बेयesian अनुमान है?
यह वर्गीकरण के लिए बेयस प्रमेय का उपयोग करता है, लेकिन एक मजबूत शर्तीय‑स्वतंत्रता मॉडल के साथ। व्यापक बेयesian अनुमान अज्ञात मात्राओं पर वितरण रखता है और पोस्टेरियर वितरण के साथ तर्क करता है।
प्राथमिक संदर्भ












