एआई की मूल बातें
इमोशन एआई (अफ़ेक्टिव कंप्यूटिंग) क्या है, और यह क्यों महत्वपूर्ण है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
इमोशन एआई, जिसे अक्सर अफेक्टिव कंप्यूटिंग कहा जाता है, भावनात्मक संकेतों से जुड़े संकेतों—जैसे भाषा, स्वर लहजा, चेहरे की हरकतें, मुद्रा, शारीरिक विज्ञान, या इंटरैक्शन पैटर्न—पर गणना लागू करता है। कोई प्रणाली लेबल वर्गीकृत कर सकती है, वैलेन्स और अरोशन जैसे आयामों का अनुमान लगा सकती है, या इंटरफ़ेस को अनुकूलित कर सकती है।
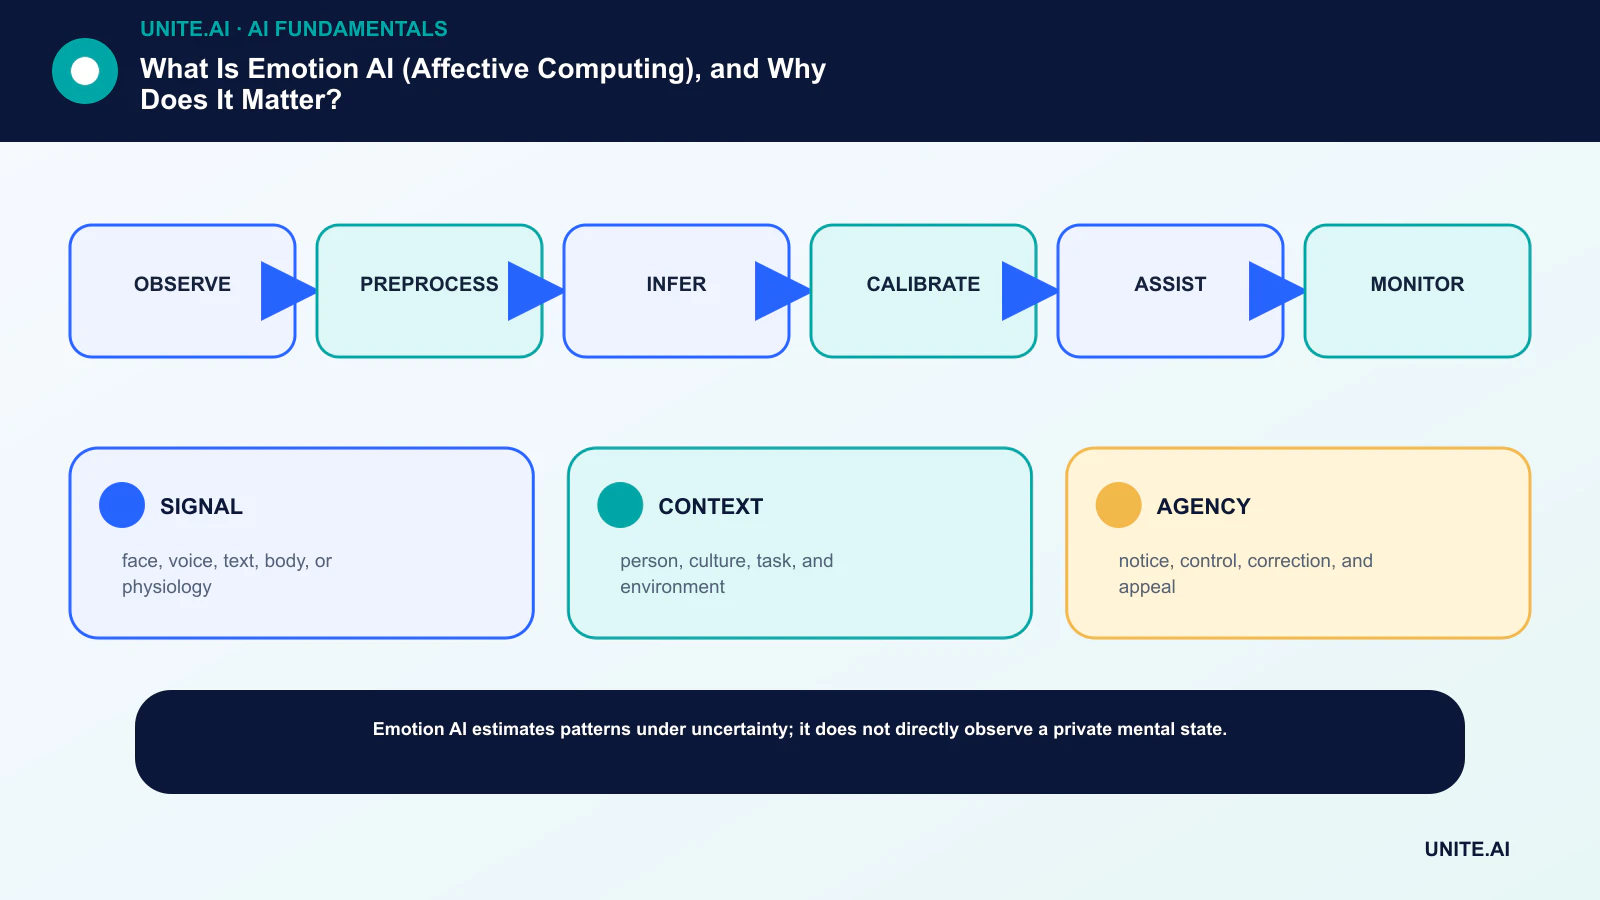
आउटपुट एक अनुमान है—अंदरूनी भावनात्मक स्थिति की प्रत्यक्ष पढ़ाई नहीं। अभिव्यक्तियाँ व्यक्ति, संस्कृति, संदर्भ, स्वास्थ्य और स्थिति के अनुसार बदलती हैं, इसलिए समान देखी जा सकने वाली संकेत कई व्याख्याओं को समर्थन दे सकता है। उच्च-जोखिम वाले उपयोगों के लिए ठोस प्रमाण, सहमति और कानूनी समीक्षा आवश्यक है।
मुख्य बिंदु
- देखे जाने योग्य लक्ष्य को सटीक रूप से परिभाषित करें; भावना, अभिव्यक्ति, सेंटिमेंट, तनाव, और सहभागिता परस्पर बदलने योग्य नहीं हैं।
- केवल तैयार किए गए बेंचमार्क पर नहीं, बल्कि इच्छित जनसंख्या और पर्यावरण पर सत्यापन करें।
- छिपी निगरानी या परिणामस्वरूप स्वचालित निर्णय के बजाय सहायता और उपयोगकर्ता नियंत्रण को प्राथमिकता दें।
- अनिश्चितता, डेटा अधिकार, रखरखाव, उपसमूह प्रदर्शन, और निर्णय को चुनौती देने का मार्ग दस्तावेज़ित करें।
संकेत और मॉडल लक्ष्य
टेक्स्ट मॉडल अभिव्यक्त सेंटिमेंट का अनुमान लगा सकते हैं; ऑडियो मॉडल समय, पिच और ऊर्जा का उपयोग करते हैं; विज़न मॉडल हरकतों का विश्लेषण करते हैं; शारीरिक प्रणालियाँ हृदय गति या त्वचा चालकता का उपयोग कर सकती हैं। मल्टीमॉडल सिस्टम संकेतों को संयोजित करते हैं, पर अधिक सेंसर स्वचालित रूप से अधिक सटीक लेबल नहीं बनाते।
‘निराश’ जैसा लेबल एनोटेशन निर्देशों और संदर्भ पर निर्भर करता है। शब्दों का सेंटिमेंट विश्लेषण व्यक्ति की भावनात्मक स्थिति का अनुमान लगाने से अधिक सीमित है, और इनको क्लिनिकल मूल्यांकन के साथ भ्रमित नहीं किया जाना चाहिए।
क्यों संदर्भ और अनिश्चितता प्रमुख हैं
लोग भावनाओं को छुपाते, बढ़ा-चढ़ा कर बताते या अलग-अलग तरीके से व्यक्त करते हैं। विकलांगता, भाषा, प्रकाश, माइक्रोफ़ोन की गुणवत्ता, और सामाजिक मानदंड देखे गए संकेतों को बदल सकते हैं। प्रयोगशाला डेटा सेट कॉल सेंटर, कक्षा, वाहन या क्लिनिक का प्रतिनिधित्व नहीं कर सकते।
कैलिब्रेशन, एब्स्टेन्शन, समूह-वार त्रुटियों, क्रॉस-डोमेन प्रदर्शन और विकल्पों का मूल्यांकन करें। कन्फ्यूज़न मैट्रिक्स यह दिखाने में मदद करते हैं कि कौन से लेबल भ्रमित होते हैं, पर कारण समझने के लिए गुणात्मक समीक्षा आवश्यक है।
उपयोगी और जोखिमपूर्ण अनुप्रयोग
उपयोगकर्ता-नियंत्रित अनुप्रयोग पहुँच, प्रतिबिंबित जर्नलिंग, अनुकूलित प्रशिक्षण, या सुरक्षा अलर्ट को समर्थन दे सकते हैं। इन उपयोगों को यह स्पष्ट करना चाहिए कि क्या मापा जा रहा है, सुधार की अनुमति दे, और निश्चितता को अधिक नहीं दिखाए।
रोज़गार, शिक्षा, बीमा, पुलिसिंग, और स्वास्थ्य संबंधी निर्णय बहुत अधिक दांव रखते हैं। EU AI एक्ट कार्यस्थलों और शिक्षा में कुछ इमोशन-रिकॉग्निशन उपयोगों को प्रतिबंधित करता है, विशिष्ट अपवादों के अधीन, और अन्य उपयोगों को जोखिम के अनुसार वर्गीकृत करता है। आवश्यकताएँ अधिकार क्षेत्र के अनुसार भिन्न होती हैं और समय के साथ बदलती रहती हैं।
जिम्मेदार तैनाती
पूछें कि क्या कार्य को वास्तव में इमोशन अनुमान की आवश्यकता है। डेटा न्यूनतमकरण, स्पष्ट उद्देश्य, छोटा रखरखाव, सुरक्षा, स्वतंत्र परीक्षण, उपयोगकर्ता सूचना, और मानव समीक्षा का उपयोग करें। किसी अन्य उद्देश्य के लिए एकत्रित संकेतों से द्वितीयक प्रोफ़ाइल बनाने से बचें।
एक्सप्लेनएबल‑AI प्रथाओं को लागू करें, लेकिन यह न सुझाएँ कि सैलियंसी मैप किसी भावना को सिद्ध करता है। अनिश्चितता को सरल भाषा में संप्रेषित करें और परिणाम से बाहर निकलने या चुनौती देने का सार्थक तरीका प्रदान करें।
भावना कैसे प्रदर्शित की जाती है
श्रेणीय मॉडल खुशी, गुस्सा, डर, उदासी, या तटस्थ जैसे लेबल की भविष्यवाणी करते हैं। आयामी मॉडल वैलेन्स, अरोशन, और डॉमिनेंस जैसे निरंतर मानों का अनुमान लगाते हैं। मूल्यांकन मॉडल यह वर्णन करते हैं कि व्यक्ति एक घटना का कैसे आकलन करता है। ये प्रतिनिधित्व सिद्धांत और माप विकल्प हैं, न कि परस्पर बदलने योग्य वास्तविक सत्य।
एनोटेशन घटना का अनुभव करने वाले व्यक्ति, पर्यवेक्षक, चिकित्सक, या प्रयोगात्मक प्रोटोकॉल से आ सकते हैं। स्वयं‑रिपोर्ट में अंतर्दृष्टि और स्मृति सीमाएँ होती हैं; पर्यवेक्षक लेबल व्यवहार से स्थिति का अनुमान लगाते हैं; शारीरिक माप अरोशन और कई गैर‑भावनात्मक प्रक्रियाओं को दर्शाते हैं। डेटा सेट को यह स्पष्ट करना चाहिए कि लेबल किसके दृष्टिकोण को दर्शाता है।
कालिक मॉडलिंग महत्वपूर्ण है क्योंकि भावना समय के साथ विकसित होती है। फ्रेम‑स्तर के चेहरे के लेबल अस्थायी हरकतों पर अधिक प्रतिक्रिया दे सकते हैं, जबकि वाक्य‑स्तर का औसत परिवर्तन को छिपा सकता है। विंडो की लंबाई, सेंसरों के बीच समकालिकता, लापता चैनल, और वक्ता की बेसलाइन परिणाम को प्रभावित करती हैं।
मोडैलिटी के अनुसार मॉडलिंग पाइपलाइन
विज़न पाइपलाइन चेहरे या शरीर का पता लगाती और संरेखित करती है, फ्रेम या लैंडमार्क निकालती है, फिर स्थानिक और कालिक विशेषताओं को वर्गीकृत करती है। ओक्लूज़न, कैमरा कोण, संपीड़न, त्वचा टोन, चश्मा, चेहरे का अंतर, और जानबूझकर अभिव्यक्ति प्रदर्शन को बदल सकती है। चेहरे के एक्शन यूनिट्स आंदोलन को सीधे वर्णित करती हैं, जो घोषित भावना से अधिक स्पष्ट हैं और अधिक सुरक्षित लक्ष्य हो सकते हैं।
ऑडियो पाइपलाइन भाषण को अलग करती है, स्तर को सामान्यीकृत करती है, और स्पेक्ट्रल, प्रॉसोडिक, तथा कालिक पैटर्न को मॉडल करती है। ऊँचा पिच उत्साह, तनाव, प्रश्न, या वक्ता की आदत दर्शा सकता है। टेक्स्ट पाइपलाइन अभिव्यक्त मूल्यांकन और संदर्भ को पकड़ती है, लेकिन स्वर खो देती है जब तक ऑडियो के साथ नहीं जोड़ी जाती। मल्टीमॉडल फ्यूज़न फीचर, निर्णय, या क्रॉस‑अटेंशन लेयर पर हो सकता है।
व्यक्तिकरण व्यक्तिगत आधाररेखा के अनुसार कैलिब्रेट कर सकता है, पर इसके लिए अधिक डेटा चाहिए और यह एक संवेदनशील दीर्घकालिक प्रोफ़ाइल बनाता है। सिस्टम को जहाँ संभव हो स्थानीय या अल्पकालिक अनुकूलन को प्राथमिकता देनी चाहिए और बिना वैध उद्देश्य के एक व्यक्ति के डेटा का उपयोग करके असंबंधित अनुमान बनाने से बचना चाहिए।
मूल्यांकन, मानव कारक, और सुरक्षा उपाय
एक ही वीडियो के फ्रेम को यादृच्छिक रूप से प्रशिक्षण और परीक्षण में विभाजित करने से डेटा लीक हो सकता है। इच्छित दावे के अनुसार लोगों, सत्रों, उपकरणों, साइटों, और समय अवधि को अलग रखें। मैक्रो मीट्रिक्स रिपोर्ट करें ताकि सामान्य वर्ग दुर्लभ स्थितियों में विफलता को छिप न सकें, और अस्पष्ट इनपुट के लिए एब्स्टेन विकल्प शामिल करें।
उपयोगकर्ता अध्ययन को यह मापना चाहिए कि अनुकूलन वास्तव में मदद करता है या नहीं। गलत अनुमान पर स्वर बदलने वाला इंटरफ़ेस घुसपैठ या अभद्र महसूस हो सकता है। उपयोगकर्ताओं को सिस्टम को सुधारने, अनुकूलन की डिग्री चुनने, और प्रतिक्रिया के कार्यात्मक कारण को देखने दें, बिना उन्हें निश्चित भावनात्मक लेबल सौंपे।
उच्च‑जोखिम वाली तैनाती के लिए प्रभाव आकलन, कानूनी समीक्षा, सुरक्षा, और द्वितीयक उपयोग पर प्रतिबंध आवश्यक है। कच्चा वीडियो या बायोमैट्रिक्स केवल आवश्यक होने पर ही संग्रहीत करें, पहुँच सीमित करें, और हटाने की प्रक्रिया निर्धारित करें। धोखा, प्रदर्शन, क्षमता, इरादा, या मानसिक स्वास्थ्य के एकल प्रमाण के रूप में इमोशन स्कोर का उपयोग न करें।
तैनाती से पहले इमोशन‑एआई उपयोग केस का मूल्यांकन
सबसे पहले दावा किए गए निर्माण को परिभाषित करें: चेहरे की हरकत, स्वर लहजा, स्वयं‑रिपोर्टेड भावना, देखी गई व्यवहार, या क्लिनिकल स्थिति परस्पर बदलने योग्य नहीं हैं। उस निर्णय की पहचान करें जो आउटपुट का उपयोग करेगा और क्या कम घुसपैठ वाला संकेत इसे पूरा कर सकता है। वह प्रणाली जो स्पष्ट निराशा प्रतिक्रिया के आधार पर गेम कठिनाई को अनुकूलित करती है, उसका प्रमाण और जोखिम प्रोफ़ाइल वेबकैम से कर्मचारी की ईमानदारी का अनुमान लगाने वाली प्रणाली से अलग है।
सत्यापन के लिए प्रतिनिधि लोग, संस्कृतियाँ, भाषाएँ, उपकरण, संदर्भ, और रिकॉर्डिंग स्थितियों की आवश्यकता होती है, साथ ही दावे के अनुरूप ग्राउंड ट्रुथ। सरल बेसलाइन के साथ तुलना करें और अनिश्चितता, उपसमूह त्रुटि, रेटर‑दर असहमति, और प्रयोगशाला से बाहर प्रदर्शन रिपोर्ट करें। संभाव्य स्कोर को इस बात के श्रेणीय बयान में न बदलें कि व्यक्ति क्या महसूस करता है। उपयोगकर्ताओं को सुधार, बाहर निकलने, और जहाँ संभव हो गैर‑बायोमैट्रिक मार्ग प्रदान करें।
निष्कर्षात्मक निर्णयों को केवल अनुमानित भावना पर आधारित होने से प्रतिबंधित करें, विशेषकर रोजगार, शिक्षा, बीमा, पुलिसिंग, स्वास्थ्य‑सेवा, और सेवाओं की पहुँच में। कच्चे ऑडियो और वीडियो को न्यूनतम रखें, बायोमैट्रिक पहचानकर्ता को अलग रखें, और द्वितीयक उपयोग को नियंत्रित करें। दस्तावेज़ीकरण में प्रशिक्षण संदर्भ, इच्छित उपयोग, अमान्य उपयोग, और ज्ञात बाधाओं जैसे विकलांगता, मास्किंग, तनाव, संस्कृति, या दवा को स्पष्ट किया जाना चाहिए। इमोशन एआई एक मापन दावा है जिसे प्रमाण चाहिए, न कि आंतरिक अनुभव की जादुई खिड़की।
व्यावहारिक कार्यान्वयन चेकलिस्ट
धारणा को सीमित, परीक्षण योग्य कार्यप्रवाह में बदलें: अवलोकन → पूर्व‑प्रसंस्करण → अनुमान → कैलिब्रेशन → सहायता → निगरानी। एक उत्तरदायी मालिक का नाम रखें, डेटा और निर्भरताओं को दस्तावेज़ित करें, एक सरल बेसलाइन स्थापित करें, स्वीकृति और रोक मानदंड निर्धारित करें, प्रतिनिधि विफलताओं का परीक्षण करें, और दायरे को विस्तारित करने से पहले निगरानी, रोलबैक, और समीक्षा को परिभाषित करें। संस्करण और धारणाएँ रिकॉर्ड करें ताकि दूसरी टीम परिणाम को पुनः उत्पन्न कर सके और परिवर्तन समझ सके।
लॉन्च से पहले, उन लोगों के साथ दस्तावेज़ित तत्परता समीक्षा चलाएँ जो सिस्टम बनाते, संचालित करते, सुरक्षित रखते, और उससे प्रभावित होते हैं। सामान्य मामलों, सीमा स्थितियों, निर्भरता विफलताओं, और दुरुपयोग का परीक्षण करें; प्रमाण और अनसुलझे जोखिम संरक्षित रखें। यह निर्धारित करें कि रिलीज़ को कौन मंजूर कर सकता है, थ्रेशोल्ड बदल सकता है, आउटपुट को ओवरराइड कर सकता है, या संचालन को रोक सकता है। वास्तविक‑विश्व डेटा आने पर निर्णय को पुनः देखें, क्योंकि तकनीकी रूप से सफल पायलट व्यापक पैमाने पर विश्वसनीय प्रदर्शन की गारंटी नहीं देता।
- सिग्नल: चेहरा, आवाज, टेक्स्ट, शरीर, या शारीरिक विज्ञान।
- संदर्भ: व्यक्ति, संस्कृति, कार्य, और पर्यावरण।
- एजेंसी: सूचना, नियंत्रण, सुधार, और अपील।
अक्सर पूछे जाने वाले प्रश्न
क्या एआई चेहरे से भावनाओं को सटीक रूप से पढ़ सकता है?
यह चेहरे की हरकतों से डेटासेट लेबल की भविष्यवाणी कर सकता है, पर ये हरकतें आंतरिक भावना को अनन्य रूप से निर्धारित नहीं करतीं। सटीकता काफी हद तक संदर्भ, जनसंख्या, लेबल, और माप डिज़ाइन पर निर्भर करती है।
क्या इमोशन एआई कानूनी है?
यह उपयोग, डेटा, लोगों, और अधिकार क्षेत्र पर निर्भर करता है। कुछ संदर्भ प्रतिबंधित या उच्च‑जोखिम वाले होते हैं। संगठनों को सामान्य तकनीकी चेकलिस्ट नहीं, बल्कि वर्तमान कानूनी सलाह की आवश्यकता है।
प्राथमिक संदर्भ