
एआई की मूल बातें
टेक्स्ट वर्गीकरण कैसे काम करता है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
टेक्स्ट वर्गीकरण दस्तावेज़, संदेश या टेक्स्ट के भाग को एक या अधिक लेबल असाइन करता है। उदाहरणों में स्पैम पहचान, इरादा रूटिंग, सेंटिमेंट विश्लेषण, टॉपिक टैगिंग, मॉडरेशन और सपोर्ट‑टिकट प्राथमिकता शामिल हैं।
एक प्रोडक्शन क्लासिफायर केवल मॉडल से अधिक होता है। यह सटीक लेबल टैक्सोनॉमी, प्रतिनिधिक एनोटेशन, लीकेज‑सुरक्षित विभाजन, कैलिब्रेटेड निर्णय नियम और बदलती भाषा तथा वर्ग की प्रचलनता की निगरानी पर निर्भर करता है।
मुख्य बिंदु
- आर्किटेक्चर चुनने से पहले लेबल और अस्पष्ट मामलों को परिभाषित करें।
- सरल बैग‑ऑफ़‑वर्ड्स बेसलाइन अभी भी मूल्यवान हैं; प्री‑ट्रेंड एन्कोडर संदर्भ और ट्रांसफ़र लर्निंग जोड़ते हैं।
- सटीकता कम प्रतिनिधि वर्ग के प्रदर्शन को छुपा सकती है, इसलिए क्लास‑अवेयर मेट्रिक्स और त्रुटि विश्लेषण का उपयोग करें।
- प्रॉबेबिलिटी कैलिब्रेशन, परहेज और मानव समीक्षा स्कोर को अधिक सुरक्षित निर्णयों में बदलते हैं।
टैक्सोनॉमी और एनोटेशन नीति को परिभाषित करें
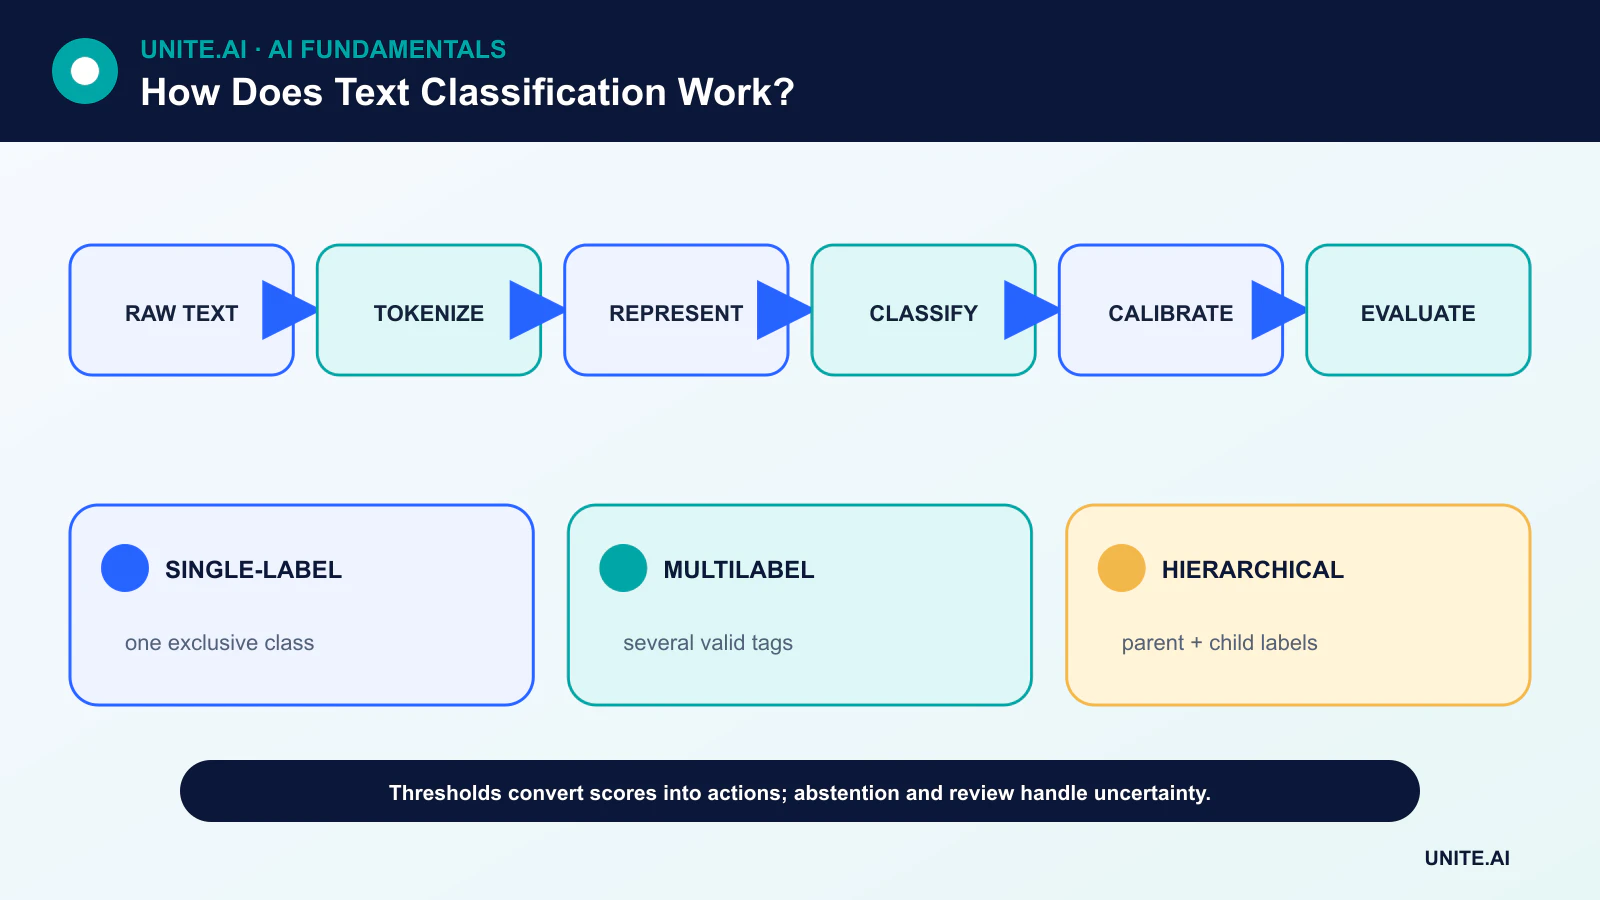
एकल‑लेबल कार्य एक परस्पर अनन्य वर्ग चुनता है। मल्टी‑लेबल कार्य कई स्वतंत्र टैग असाइन कर सकता है। पदानुक्रमित टैक्सोनॉमी में पैरेंट और चाइल्ड लेबल होते हैं। ये अलग‑अलग लर्निंग समस्याएँ हैं और विभिन्न आउटपुट तथा मेट्रिक्स की आवश्यकता होती है।
एनोटेटरों को परिभाषाएँ, सकारात्मक और नकारात्मक उदाहरण, अनुपस्थित संदर्भ के नियम और एस्केलेशन पाथ चाहिए। एग्रीमेंट सांख्यिकी अस्पष्ट कार्य को उजागर कर सकती है, लेकिन असहमति वास्तविक अस्पष्टता को भी दर्शा सकती है जिसे सिस्टम को बनाए रखना चाहिए।
पाठ का प्रतिनिधित्व
पारम्परिक पाइपलाइन टोकन काउंट, n‑gram और TF‑IDF को रैखिक क्लासिफायर या सपोर्ट वेक्टर मशीन के साथ उपयोग करती हैं। ये तेज़ी से प्रशिक्षित होती हैं, प्रभावशाली शब्दों को उजागर करती हैं और एक मजबूत बेसलाइन प्रदान करती हैं।
न्यूरल सिस्टम टोकनों को एम्बेडिंग में मैप करते हैं। प्री‑ट्रेंड ट्रांसफ़ॉर्मर एन्कोडर ध्यान (attention) का उपयोग करके संदर्भित प्रतिनिधित्व बनाते हैं और लेबल्ड उदाहरणों के साथ फाइन‑ट्यून किए जा सकते हैं। प्रॉम्प्टेड या ज़ीरो‑शॉट क्लासिफायर प्रारंभिक लेबलिंग को कम कर सकते हैं, लेकिन उनके लेबल शब्दावली, मॉडल संस्करण और कैलिब्रेशन का वास्तविक डोमेन में मूल्यांकन आवश्यक है।
लीकेज के बिना प्रशिक्षण
डेटासेट को प्रशिक्षण, वैलिडेशन और अंतिम टेस्ट डेटा में विभाजित किया जाता है। निकट‑डुप्लिकेट दस्तावेज़, समान वार्तालाप से संदेश या समान स्रोत के टेम्पलेट एक ही विभाजन में रहने चाहिए। समय‑निर्भर उपयोग के लिए, कालानुक्रमिक विभाजन डिप्लॉयमेंट को बेहतर दर्शाता है।
क्लास असंतुलन को वेटिंग, रिसैंपलिंग, थ्रेशोल्ड चयन या अतिरिक्त डेटा द्वारा संबोधित किया जा सकता है। सिंथेटिक उदाहरण वास्तविक अल्पसंख्यक‑क्लास विफलताओं की समीक्षा का स्थान नहीं लेनी चाहिए और मॉडल को आसानी से सीखने वाले आर्टिफैक्ट्स पेश कर सकती हैं।
मेट्रिक्स और कैलिब्रेटेड निर्णय
एक कॉन्फ्यूज़न मैट्रिक्स दर्शाता है कि कौन से लेबल भ्रमित होते हैं। प्रिसीजन मापता है कि कितने प्रेडिक्टेड पॉज़िटिव सही हैं; रिकॉल मापता है कि कितने ट्रू पॉज़िटिव पाए गए। मैक्रो औसत क्लासों को समान रूप से वेट करता है, जबकि माइक्रो औसत व्यक्तिगत उदाहरणों को वेट करता है।
एक रॉ सॉफ्टमैक्स स्कोर स्वचालित रूप से भरोसेमंद प्रॉबेबिलिटी नहीं होता। कैलिब्रेशन विश्वास को वास्तविक शुद्धता से तुलना करता है। टीमें क्लास‑स्पेसिफिक थ्रेशोल्ड सेट कर सकती हैं, जब विश्वास कम हो तो परहेज (abstain) कर सकती हैं और संवेदनशील मामलों को समीक्षक को रूट कर सकती हैं।
डिप्लॉयमेंट, बहुभाषी उपयोग और ड्रिफ्ट
टेक्स्ट उत्पादों, घटनाओं, स्लैंग और विरोधी व्यवहार के साथ बदलता रहता है। मॉनिटरिंग को इनपुट भाषा, लंबाई, आउट‑ऑफ़‑वोकैबुलरी पैटर्न, क्लास रेट, विश्वास और देरी वाले परिणामों को ट्रैक करना चाहिए। री‑ट्रेनिंग को वर्ज़नड डेटा और महत्वपूर्ण उदाहरणों की रिग्रेशन सूट की आवश्यकता होती है।
बहुभाषी प्रदर्शन को प्रत्येक भाषा और बोली के अनुसार परीक्षण करना आवश्यक है। सब कुछ एक ही भाषा में अनुवाद करने से सेंटिमेंट या एंटिटीज़ बदल सकते हैं; एक बहुभाषी एन्कोडर अभी भी असमान प्रदर्शन कर सकता है क्योंकि उसकी प्री‑ट्रेनिंग और लेबल समान रूप से प्रतिनिधित्व नहीं करते।
प्रतिनिधित्व और वर्गीकार परिवार
टेक्स्ट वर्गीकरण एक दस्तावेज़, वाक्य या टोकन अनुक्रम को एक या अधिक लेबल में मैप करता है। निर्धारित करें कि लेबल परस्पर अनन्य, मल्टी‑लेबल, पदानुक्रमित, क्रमबद्ध या ओपन‑सेट हैं या नहीं। पारम्परिक पाइपलाइन टेक्स्ट को टोकनाइज़ करती हैं, बैग‑ऑफ़‑वर्ड्स या TF‑IDF फीचर बनाती हैं, और लॉजिस्टिक रिग्रेशन, नायव बेज़ या रैखिक SVM को प्रशिक्षित करती हैं। न्यूरल सिस्टम कॉन्वॉल्यूशन, रिकर्रेंस या ट्रांसफ़ॉर्मर के साथ एम्बेडिंग सीखते हैं। प्रॉम्प्टेड लैंग्वेज मॉडल टास्क‑स्पेसिफिक ट्रेनिंग के बिना वर्गीकृत कर सकते हैं, लेकिन आउटपुट प्रतिबंध, लागत, ड्रिफ्ट और साक्ष्य अभी भी सरल बेसलाइन के विरुद्ध मूल्यांकन की आवश्यकता रखते हैं।
प्रोसेसिंग प्रतिनिधित्व पर निर्भर करती है। लोअर‑केसिंग या विराम चिह्न हटाने से नाम, सेंटिमेंट, कोड या भाषा के संकेत नष्ट हो सकते हैं; स्टेमिंग अलग अर्थों को मिलाने का कारण बन सकता है। ट्रांसफ़ॉर्मर टोकनाइज़र सबवर्ड्स पर काम करते हैं और लंबाई सीमा रखते हैं, इसलिए ट्रंकेशन रणनीति महत्वपूर्ण है। बड़े दस्तावेज़ों को चंकिंग और एग्रीगेशन की आवश्यकता हो सकती है। रॉ टेक्स्ट और ट्रांसफ़ॉर्मेशन संस्करण को संरक्षित रखें, तथा लेखक, वार्तालाप, स्रोत या समय के आधार पर विभाजन करें ताकि निकट‑डुप्लिकेट और दोहराए जाने वाले टेम्पलेट ट्रेन और टेस्ट के बीच न मिलें।
लेबल, मेट्रिक्स, और त्रुटि विश्लेषण
एक एनोटेशन गाइड को स्कोप, उदाहरण, अस्पष्ट मामलों और एक अनजान या परहेज विकल्प को परिभाषित करना चाहिए। एग्रीमेंट को मापें और असहमति को बहुमत वोट से छुपाने के बजाय उसका निपटारा करें। असंतुलित क्लासों के लिए, सटीकता अपर्याप्त है; क्लास के अनुसार प्रिसीजन, रिकॉल, F1, कॉन्फ्यूज़न, कैलिब्रेशन और थ्रेशोल्ड‑स्पेसिफिक वर्कलोड रिपोर्ट करें। मल्टी‑लेबल कार्यों को माइक्रो, मैक्रो और लेबल‑लेवल मेट्रिक्स चाहिए। भाषाओं, बोलियों, डोमेन्स, संदेश लंबाई और समय का मूल्यांकन करें। शब्दावली या टेम्पलेट ड्रिफ्ट होने पर रैंडम स्प्लिट गुणवत्ता को अधिक दिखा सकता है।
त्रुटि विश्लेषण को प्रतिनिधित्व विफलता, अपर्याप्त संदर्भ, लेबल अस्पष्टता, दुर्लभ शब्दावली, नकारात्मकता, व्यंग्य और झूठी संकेतों से अलग करना चाहिए। ऐसे काउंटरफ़ैक्चुअल टेस्ट उपयोग करें जो नाम, बोली संकेत या अप्रासंगिक मेटाडाटा बदलते हैं जबकि अर्थ को बनाए रखते हैं। उच्च‑विश्वास वाले त्रुटियों और अस्वीकृत मामलों का निरीक्षण करें। एक मॉडल सीख सकता है कि ग्राहक चैनल या हस्ताक्षर लेबल की भविष्यवाणी करता है बजाय सामग्री की व्याख्या के। मॉडल क्षमता बढ़ाने से पहले लीकेज हटाएँ और डेटा को पुनः संशोधित करें।
प्रोडक्शन डिजाइन
एक स्थिर टोकनाइज़र और मॉडल को स्कीमा वैलिडेशन, लंबाई सीमा, बैचिंग और असमर्थित भाषा या कम विश्वास के लिए फॉलबैक के साथ सर्व करें। इनपुट वितरण, लेबल रेट, कैलिब्रेशन, लेटेंसी और समीक्षा किए गए परिणामों की निगरानी करें। टेक्स्ट की सुरक्षा करें क्योंकि इसमें व्यक्तिगत, गोपनीय या विरोधी निर्देश हो सकते हैं। स्वचालित मॉडरेशन, पात्रता या रूटिंग के लिए अपील प्रदान करें और विभिन्न त्रुटियों को मापें। लेबल और थ्रेशोल्ड को व्यावसायिक नीति के साथ वर्ज़न करें। टेक्स्ट वर्गीकरण केवल अपने परिभाषित लेबल सिस्टम और डेटा वितरण के भीतर विश्वसनीय है; प्रवाहमान मॉडल व्याख्याएँ यह प्रमाण नहीं देतीं कि वर्गीकरण सही है।
व्यावहारिक उदाहरण: आने वाले सपोर्ट अनुरोधों का वर्गीकरण
एक सपोर्ट टीम परस्पर अनन्य रूटिंग लेबल के साथ तात्कालिक, बहुभाषी और अनजान फ्लैग निर्धारित करती है। एनोटेटर मिश्रित मुद्दों के लिए मार्गदर्शन के साथ डी‑आईडेंटिफ़ाइड संदेशों को लेबल करते हैं और एग्रीमेंट मापते हैं। एक TF‑IDF लॉजिस्टिक बेसलाइन, फाइन‑ट्यून्ड एन्कोडर और प्रॉम्प्टेड मॉडल समान समय‑आधारित टेस्ट सेट का उपयोग करते हैं। मूल्यांकन क्लास प्रिसीजन और रिकॉल, तात्कालिक फ़ॉल्स नेगेटिव्स, कैलिब्रेशन, स्कीमा वैधता, लेटेंसी और लागत की रिपोर्ट करता है, तथा लीकेज से बचने के लिए निकट‑डुप्लिकेट टेम्पलेट को समूहित किया जाता है।
डिप्लॉय किया गया क्लासिफायर भाषा और लंबाई को वैध करता है, कमजोर साक्ष्य पर परहेज (abstain) करता है, और एजेंटों को रूट सुधारने देता है। प्रॉम्प्ट और संदेश असविश्वसनीय माने जाते हैं; टूल एक्सेस नहीं है। मॉनिटरिंग लेबल प्रचलन, विश्वास, सुधार, प्रतिक्रिया समय और उभरते विषयों को ट्रैक करती है। नीति या उत्पाद परिवर्तन टैक्सोनॉमी और री‑ट्रेनिंग डेटा को समीक्षा के माध्यम से अपडेट करता है। सिस्टम कतार स्थान को सुधारता है, लेकिन यह वैध लेबलों से परे ग्राहक की भावना या अधिकार का अनुमान नहीं लगाता।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक प्रोडक्शन निर्णय को सफल डेमोंस्ट्रेशन से अधिक चाहिए। इच्छित उपयोगकर्ताओं, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले पुनरुत्पादनीय बेसलाइन और वर्ज़नड मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपस्थित इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग और सबसे अधिक सेवा‑रहित समूहों या वातावरण का परीक्षण करें। टास्क क्वालिटी को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनः उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक और रिटायरमेंट के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित फॉलबैक बनाए रखें, और जानबूझकर इंजेक्टेड विफलताओं के साथ मॉनिटरिंग की पुष्टि करें। ऑपरेशनल टेलीमेट्री को इनपुट क्वालिटी, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और रिस्पॉन्स ओनर परिभाषित करें, फिर डिप्लॉयमेंट के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, न कि ऑफ़लाइन प्रदर्शन को स्थायी मानें। डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियों, हार्डवेयर या उद्देश्यों में परिवर्तन होने पर पुनः मूल्यांकन करें। एक रखरखाव किया गया सिस्टम दस्तावेज़ीकृत रिकवरी, घटना सीखना, डिलीशन और रिटेंशन प्रक्रियाओं, तथा एक स्पष्ट बिंदु की भी आवश्यकता रखता है जहाँ इसे निष्क्रिय या बदलना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या सेंटिमेंट एनालिसिस एक टेक्स्ट‑क्लासिफिकेशन कार्य है?
आमतौर पर हाँ, लेकिन सेंटिमेंट मल्टी‑लेबल, पहलू‑आधारित या निरंतर हो सकता है, न कि केवल एक सकारात्मक/तटस्थ/नकारात्मक लेबल।
टेक्स्ट क्लासिफायर को कब परहेज (abstain) करना चाहिए?
जब विश्वास कम हो, टेक्स्ट दायरे से बाहर हो, आवश्यक संदर्भ अनुपलब्ध हो, या गलत स्वचालित कार्रवाई की लागत समीक्षा की लागत से अधिक हो।
प्राथमिक संदर्भ












