
एआई की मूल बातें
सपोर्ट वेक्टर मशीनें क्या हैं?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
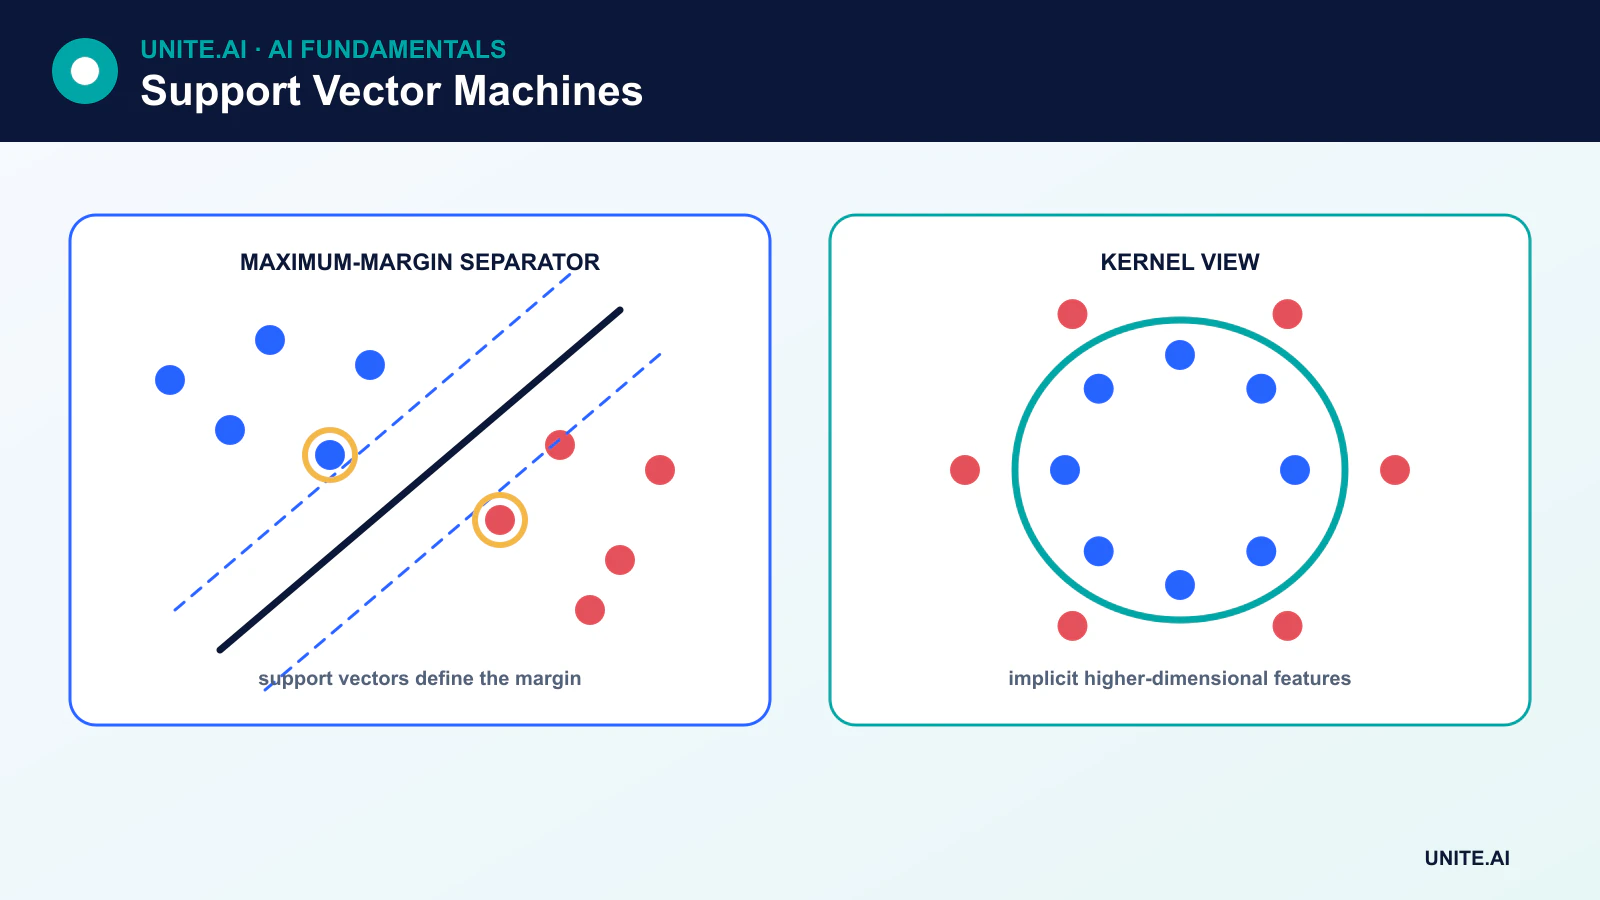
एक सपोर्ट वेक्टर मशीन (SVM) एक सुपरवाइज़्ड लर्निंग विधि है जो वर्गों के बीच सबसे विस्तृत मार्जिन के साथ निर्णय सीमा खोजती है। वह प्रशिक्षण उदाहरण जो उस सीमा को निर्धारित करते हैं, सपोर्ट वेक्टर कहलाते हैं।
SVM रैखिक या गैर‑रैखिक वर्गीकरण, प्रतिगमन और नवीनता पहचान कर सकते हैं। वे विशेष रूप से छोटे‑से‑मध्यम डेटा सेटों के लिए उपयोगी होते हैं जिनमें सूचनात्मक विशेषताएँ होती हैं, जिसमें उच्च‑आयामी विरल डेटा भी शामिल है, लेकिन बहुत बड़े डेटा सेटों पर उनका प्रशिक्षण खर्च असंगत हो सकता है।
मुख्य बिंदु
- एक SVM सीमा और सबसे निकटतम प्रशिक्षण बिंदुओं के बीच न्यूनतम मार्जिन को अधिकतम करता है।
- सपोर्ट वेक्टर डेटा बिंदु होते हैं, अतिरिक्त हाइपरप्लेन नहीं।
- पैरामीटर C मार्जिन की चौड़ाई को उल्लंघनों के दंड के साथ संतुलित करता है।
- कर्नेल्स एक अप्रत्यक्ष फीचर स्पेस में समानता की गणना करते हैं बिना प्रत्येक परिवर्तित फीचर को स्पष्ट रूप से निर्मित किए।
अधिकतम‑मार्जिन विचार
एक रैखिक द्विआधारी वर्गीकर्ता के लिए, निर्णय सीमा एक हाइपरप्लेन होती है:
w · x + b = 0
वेक्टर w अभिविन्यास निर्धारित करता है और b ऑफ़सेट। कई हाइपरप्लेन प्रशिक्षण वर्गों को अलग कर सकते हैं। SVM वह चुनता है जो दोनों पक्षों के सबसे निकटतम उदाहरणों तक की दूरी को अधिकतम करता है। ये सबसे निकटतम उदाहरण सपोर्ट वेक्टर होते हैं और फिट की गई सीमा पर सबसे अधिक प्रभाव डालते हैं।
उद्देश्य यह नहीं है कि सीमा से प्रत्येक बिंदु तक की दूरी को स्वतंत्र रूप से अधिकतम किया जाए। यह न्यूनतम मार्जिन को अधिकतम करता है जबकि वर्ग बाधाओं को संतुष्ट या दंडित करता है।
हार्ड और सॉफ्ट मार्जिन
एक हार्ड‑मार्जिन SVM को पूर्ण रैखिक विभाजन की आवश्यकता होती है और यह आउटलेयर के प्रति संवेदनशील होता है। वास्तविक डेटा सेटों को आमतौर पर एक सॉफ्ट मार्जिन की जरूरत होती है, जो मार्जिन के भीतर या सीमा के गलत पक्ष में स्थित अवलोकनों के लिए स्लैक वेरिएबल्स पेश करता है।
हाइपरपैरामीटर C इन उल्लंघनों के दंड को नियंत्रित करता है:
- एक बड़ा C उल्लंघनों को अधिक कठोरता से दंडित करता है और अक्सर एक संकरी मार्जिन उत्पन्न करता है जो प्रशिक्षण उदाहरणों के अधिक निकट चलता है।
- एक छोटा C अधिक उल्लंघनों की अनुमति देता है बदले में एक विस्तृत, अधिक नियमितीकृत मार्जिन के लिए।
सपोर्ट वेक्टरों की संख्या डेटा और समाधान का परिणाम है; C बढ़ाने से किसी विशिष्ट सपोर्ट‑वेक्टर गिनती की गारंटी नहीं मिलती।
कर्नेल ट्रिक
कुछ वर्गों को मूल फीचर स्पेस में सीधी हाइपरप्लेन से अलग नहीं किया जा सकता। एक कर्नेल दूसरे फीचर स्पेस के अनुरूप अंतरिक गुणनफल का मूल्यांकन करता है। यह SVM को प्रत्येक परिवर्तित निर्देशांक की स्पष्ट गणना किए बिना गैर‑रैखिक सीमा फिट करने देता है।
सामान्य कर्नेल्स में शामिल हैं:
- Linear: टेक्स्ट जैसी उच्च‑आयामी विरल विशेषताओं के लिए कुशल।
- Polynomial: चुनी गई डिग्री तक अंतःक्रियाओं को मॉडल करता है।
- Radial basis function (RBF): दूरी के आधार पर लचीली स्थानीय सीमाएँ बनाता है।
- Sigmoid: न्यूरल सक्रियण जैसा दिखता है लेकिन सामान्यतः डिफ़ॉल्ट विकल्प नहीं होता।
RBF SVM के लिए, gamma नियंत्रित करता है कि प्रत्येक प्रशिक्षण उदाहरण सीमा को कितनी स्थानीय रूप से प्रभावित करता है। बड़ा gamma अत्यधिक विस्तृत क्षेत्रों को बना सकता है और ओवरफ़िट कर सकता है; छोटा gamma अधिक सुगम प्रभाव देता है।
बहु‑वर्गीय वर्गीकरण
क्लासिक SVM उद्देश्य द्विआधारी है। लाइब्रेरीज़ इसे one-vs-rest जैसी रणनीतियों से विस्तारित करती हैं, जो प्रत्येक वर्ग के लिए एक वर्गीकर्ता प्रशिक्षित करती है, या one-vs-one, जो वर्ग जोड़ों के लिए वर्गीकर्ता प्रशिक्षित करती है और उनके निर्णयों को मिलाती है। बहु‑वर्गीय SVM केवल वर्गों की संख्या से एक कम रेखा नहीं बनाते।
सपोर्ट वेक्टर प्रतिगमन और वन‑क्लास SVM
सपोर्ट वेक्टर प्रतिगमन (SVR) एक फ़ंक्शन फिट करता है जबकि epsilon‑व्यापी ट्यूब के भीतर की त्रुटियों को अनदेखा करता है और बड़े विचलनों को दंडित करता है। एक वन‑क्लास SVM सामान्य डेटा के चारों ओर एक सीमा का अनुमान लगाता है और नवीनता पहचान का समर्थन कर सकता है। एक असामान्य बिंदु स्वचालित रूप से धोखाधड़ी या विफलता नहीं होता; यह फिट किए गए प्रतिनिधित्व के तहत असामान्य होता है।
व्यावहारिक आवश्यकताएँ
SVM दूरी और अंतरिक गुणनफल पर निर्भर होते हैं, इसलिए संख्यात्मक विशेषताओं को सामान्यतः स्केलिंग की आवश्यकता होती है। C, कर्नेल, gamma, और वर्ग वजन को वैधता के माध्यम से चुना जाना चाहिए। संभाव्यता अनुमान मार्जिन में अंतर्निहित नहीं होते और अक्सर कैलिब्रेशन की आवश्यकता होती है, जो लागत जोड़ता है और अलग से मूल्यांकन किया जाना चाहिए।
कर्नेल SVM प्रशिक्षण नमूनों की संख्या के अनुसार द्विघात से घनात्मक समय तक स्केल कर सकता है, यह डेटा और कार्यान्वयन पर निर्भर करता है। रैखिक SVM विविधताएँ या स्टोकेस्टिक रैखिक मॉडल बहुत बड़े डेटा सेटों के लिए अधिक उपयुक्त होते हैं। कच्ची छवियों, ऑडियो, या भाषा के लिए, डीप लर्निंग से प्राप्त प्रतिनिधित्व अधिक प्रभावी हो सकते हैं, जबकि SVM अभी भी एक स्थिर एम्बेडिंग को वर्गीकृत कर सकता है।
SVM की ताकत और सीमाएँ
SVM कई विशेषताओं के साथ अच्छी तरह काम कर सकते हैं, स्पष्ट नियमितीकृत उद्देश्य प्रदान करते हैं, और भविष्यवाणी समय पर मुख्यतः सपोर्ट वेक्टरों पर निर्भर होते हैं। सीमाओं में स्केलिंग और हाइपरपैरामीटरों के प्रति संवेदनशीलता, संभावित महंगा प्रशिक्षण, गैर‑रैखिक कर्नेल्स के तहत कम व्याख्यात्मकता, और संभाव्यता कैलिब्रेशन की आवश्यकताएँ शामिल हैं।
मार्जिन, कर्नेल और अनुकूलन उद्देश्य
एक सपोर्ट वेक्टर मशीन वर्गों के बीच बड़े मार्जिन के साथ एक विभाजक हाइपरप्लेन खोजती है। केवल मार्जिन पर या भीतर के सपोर्ट वेक्टर सीमा निर्धारित करते हैं। सॉफ्ट‑मार्जिन SVM ओवरलैप और गलत लेबल वाले बिंदुओं के लिए स्लैक पेश करते हैं; पैरामीटर C विस्तृत मार्जिन को प्रशिक्षण उल्लंघनों के विरुद्ध बदलता है। इनपुट को सामान्यतः स्केल किया जाना चाहिए क्योंकि दूरी और डॉट प्रोडक्ट समाधान को चलाते हैं। वर्ग वजन या पुनःसैंपलिंग मदद करते हैं जब त्रुटि लागत और प्रचलन असमान होते हैं, लेकिन थ्रेशोल्ड और संभावनाओं को अभी भी स्वतंत्र वैधता की आवश्यकता होती है।
कर्नेल ट्रिक समानता का मूल्यांकन करती है जैसे इनपुट को उच्च‑आयामी फीचर स्पेस में मैप किया गया हो। रैखिक, बहुपद, रेडियल‑बेसिस, और विशेषीकृत कर्नेल विभिन्न धारणाओं को एन्कोड करते हैं। RBF कर्नेल के लिए, gamma नियंत्रित करता है कि प्रत्येक बिंदु सीमा को कितनी स्थानीय रूप से प्रभावित करता है: उच्च gamma जटिल क्षेत्रों को बना सकता है और ओवरफ़िट कर सकता है, जबकि कम gamma अंडरफ़िट कर सकता है। कर्नेल मैट्रिक्स नमूना संख्या के साथ द्विघात रूप से बढ़ते हैं, जिससे बड़े डेटा सेटों पर गैर‑रैखिक SVM महंगे हो जाते हैं। स्केल पर रैखिक सॉल्वर या अनुमानित फीचर मैप अक्सर अधिक उपयुक्त होते हैं।
बहु‑वर्गीय उपयोग, कैलिब्रेशन, और परिचालन सीमाएँ
द्विआधारी SVMs one-vs-rest, one-vs-one, या संरचित रूपों के माध्यम से बहु‑वर्गीय में विस्तारित होते हैं। हाइपरपैरामीटर को क्रॉस‑वैलिडेशन के भीतर ट्यून किया जाना चाहिए, जहाँ आवश्यक हो समूहित या कालिक विभाजन के साथ। वर्ग‑विशिष्ट प्रिसिशन और रिकॉल, मार्जिन वितरण, कैलिब्रेशन, और शिफ्ट के तहत प्रदर्शन का मूल्यांकन करें। कच्चे निर्णय स्कोर संभावनाएँ नहीं होते; प्लैट स्केलिंग या आयसोतोनिक कैलिब्रेशन अलग डेटा का उपयोग करता है और यदि प्रचलन बदलता है तो घट सकता है। लॉजिस्टिक रिग्रेशन, ट्री, और आधुनिक प्रतिनिधित्व‑आधारित विधियों के साथ समान प्री‑प्रोसेसिंग और ट्यूनिंग प्रयास पर तुलना करें।
सर्विंग के लिए सटीक स्केलर, फीचर क्रम, कर्नेल पैरामीटर, सपोर्ट वेक्टर, और वर्ग मैपिंग की आवश्यकता होती है। कर्नेल SVM के लिए भविष्यवाणी लागत सपोर्ट वेक्टरों के साथ बढ़ती है, इसलिए वास्तविक बैचों पर लेटेंसी और मेमोरी मापें। प्रशिक्षण सपोर्ट से दूर इनपुट अभी भी विश्वसनीय लेबल प्राप्त कर सकते हैं; उपयुक्त होने पर आउट‑ऑफ़‑डिस्ट्रिब्यूशन जाँच या अस्वीकृति नीति जोड़ें। संवेदनशील प्रॉक्सी और डेटा सेट कलाकृतियों के लिए त्रुटियों का निरीक्षण करें। SVM मध्यम‑आकार, उच्च‑आयामी समस्याओं के लिए अभी भी मजबूत हैं, लेकिन अधिकतम ज्यामितीय मार्जिन कारणात्मक संरचना या सुरक्षा का प्रमाण नहीं है।
व्यावहारिक उदाहरण: दुर्लभ दस्तावेज़ रूटिंग के लिए एक SVM
एक कानूनी संचालन टीम TF–IDF विशेषताओं और रैखिक SVM का उपयोग करके छोटे फ़ाइलिंग को रूटिंग श्रेणियों में वर्गीकृत करती है। यह टेम्पलेट लीक को रोकने के लिए विषय और समय के आधार पर विभाजन करती है, समीक्षा किए गए त्रुटि लागत के आधार पर वर्ग वजन को स्केल करती है, और नेस्टेड वैधता के भीतर C को ट्यून करती है। रैखिक मॉडल की तुलना लॉजिस्टिक रिग्रेशन और ट्रांसफ़ॉर्मर से की जाती है। वर्ग‑वार प्रिसिशन, रिकॉल, कैलिब्रेशन, और समीक्षक कार्यभार समग्र शुद्धता से अधिक महत्वपूर्ण होते हैं।
निर्णय स्कोर अलग डेटा पर कैलिब्रेट किए जाते हैं, और कम‑मार्जिन या असमर्थित‑भाषा दस्तावेज़ मैन्युअल इनपुट की ओर जाते हैं। सर्विंग आर्टिफैक्ट में टोकनाइज़र, शब्दावली, वेटिंग, मॉडल, कैलिब्रेशन, और लेबल मैप शामिल होते हैं। मॉनिटरिंग नए शब्दों, वर्ग प्रचलन, मार्जिन, और सुधारे गए मार्गों को ट्रैक करती है। दस्तावेज़ और सपोर्ट वेक्टर संरक्षित होते हैं क्योंकि टेक्स्ट विशेषताएँ गोपनीय जानकारी उजागर कर सकती हैं। एक गैर‑रैखिक कर्नेल को तब अस्वीकार किया जाता है जब उसका छोटा गुणवत्ता लाभ लेटेंसी, मेमोरी, और व्याख्यात्मक लागत को उचित नहीं ठहराता।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय को सफल प्रदर्शन से अधिक चाहिए। इरादे वाले उपयोगकर्ताओं, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादनीय बेसलाइन और एक संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपलब्ध इनपुट, वितरण शिफ्ट, निर्भरता आउटेज, दुरुपयोग, और उन समूहों या वातावरणों का परीक्षण करें जो सबसे अधिक सेवा‑हीन हो सकते हैं। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक रूपांतरण और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनरुत्पादित कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक, और सेवानिवृत्ति के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित फॉलबैक बनाए रखें, और जानबूझकर डाली गई विफलताओं के साथ मॉनिटरिंग की पुष्टि करें। परिचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम दिखाने चाहिए बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑दुनिया के प्रमाण की समीक्षा करें बजाय यह मानने के कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियाँ, हार्डवेयर, या उद्देश्य बदलें, पुनर्मूल्यांकन करें। एक रखरखाव किया गया सिस्टम दस्तावेज़ीकृत पुनर्प्राप्ति, घटना सीखना, विलोपन और प्रतिधारण प्रक्रियाएँ, और एक स्पष्ट बिंदु चाहिए जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या SVM केवल वर्गीकरण करते हैं?
नहीं। सपोर्ट वेक्टर प्रतिगमन निरंतर लक्ष्य की भविष्यवाणी करता है, जबकि वन‑क्लास SVM नवीनता सीमा का अनुमान लगा सकता है। प्रत्येक संस्करण का उद्देश्य और हाइपरपैरामीटर सेट अलग होता है।
कब रैखिक SVM एक मजबूत विकल्प होता है?
रैखिक SVM अक्सर उच्च‑आयामी विरल विशेषताओं के लिए प्रभावी होते हैं, जिसमें पारंपरिक टेक्स्ट प्रतिनिधित्व शामिल है, जहाँ एक लचीला कर्नेल स्पष्ट लाभ के बिना लागत बढ़ा देगा।
प्राथमिक संदर्भ












