एआई की मूल बातें
व्याख्या योग्य एआई क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
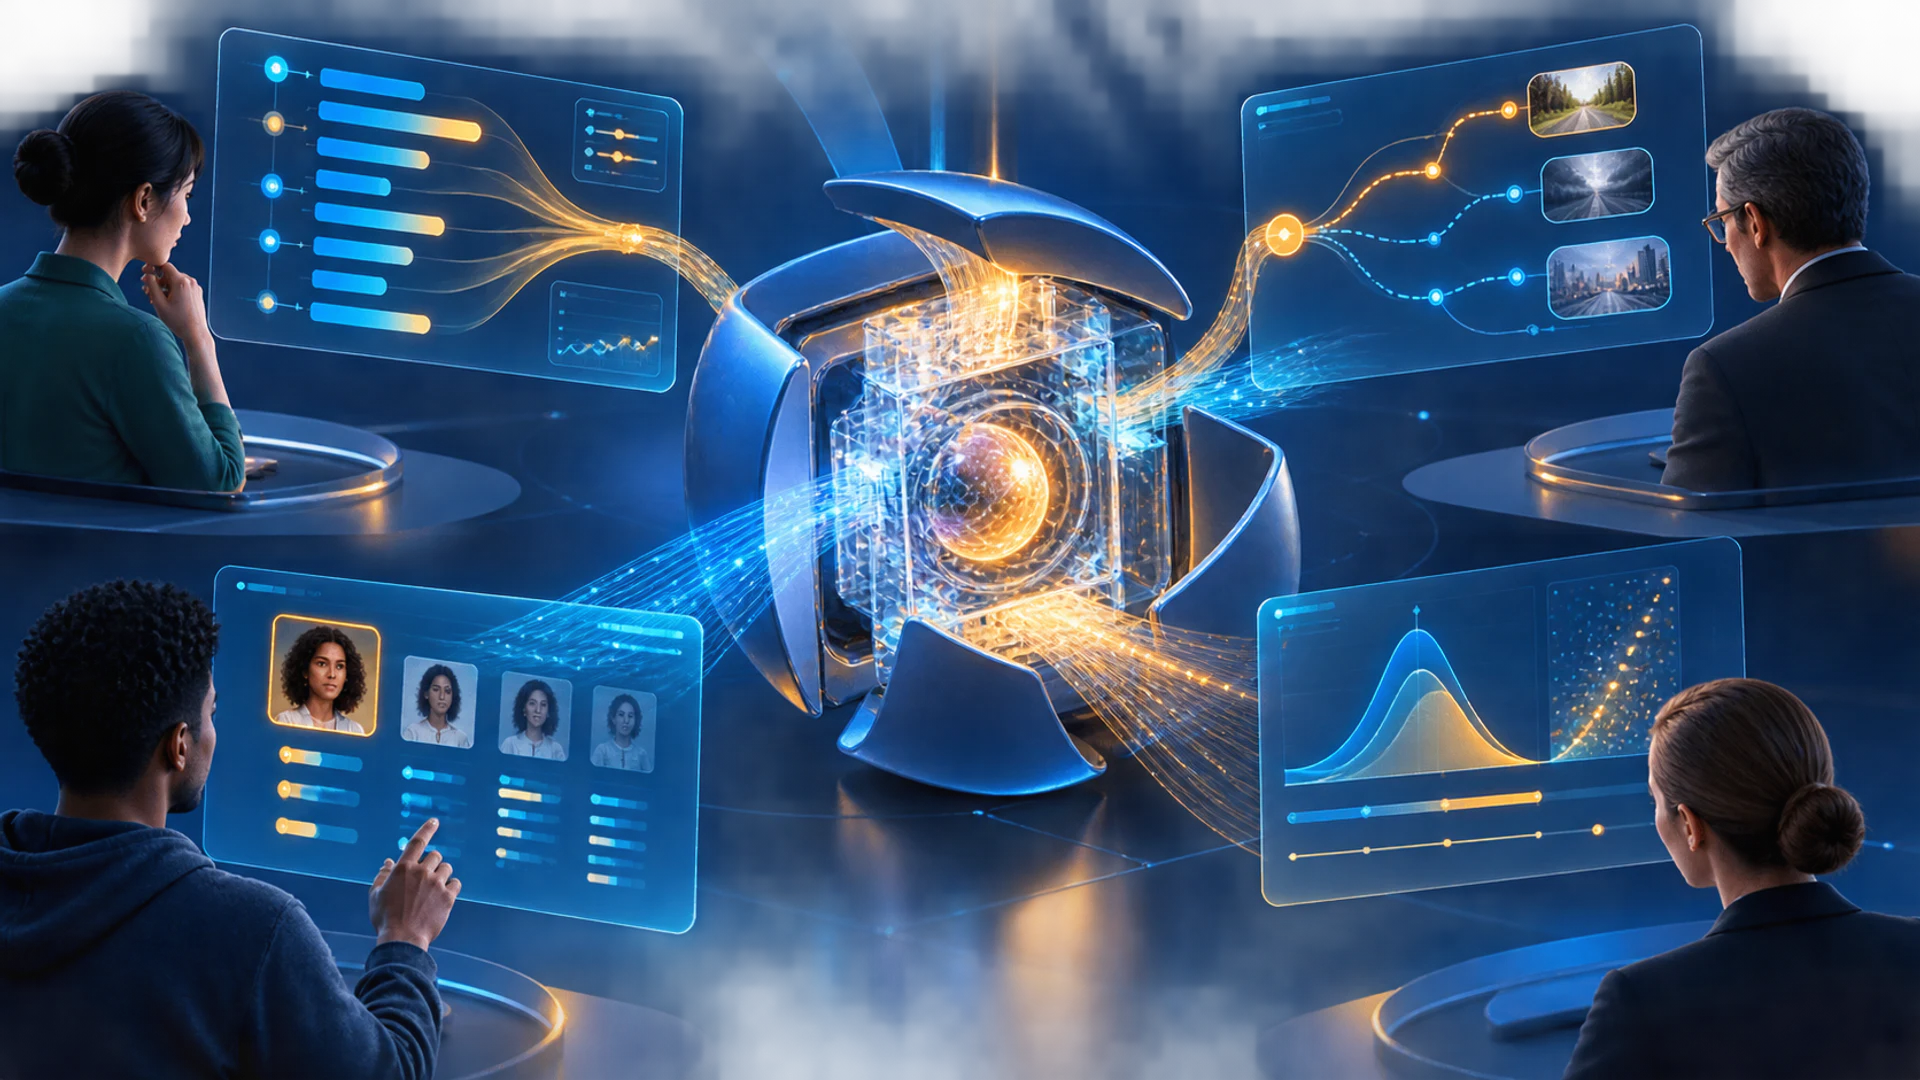
व्याख्या योग्य एआई (XAI) में ऐसी विधियाँ और प्रथाएँ शामिल हैं जो लोगों को AI सिस्टम के व्यवहार या आउटपुट को समझने में मदद करती हैं। एक व्याख्या प्रभावशाली इनपुट्स का वर्णन कर सकती है, समान उदाहरण दिखा सकती है, वैकल्पिक (counterfactual) परिवर्तन प्रस्तुत कर सकती है, एक समग्र नियम का सारांश दे सकती है या यह बताती है कि सिस्टम कब नहीं जानता।
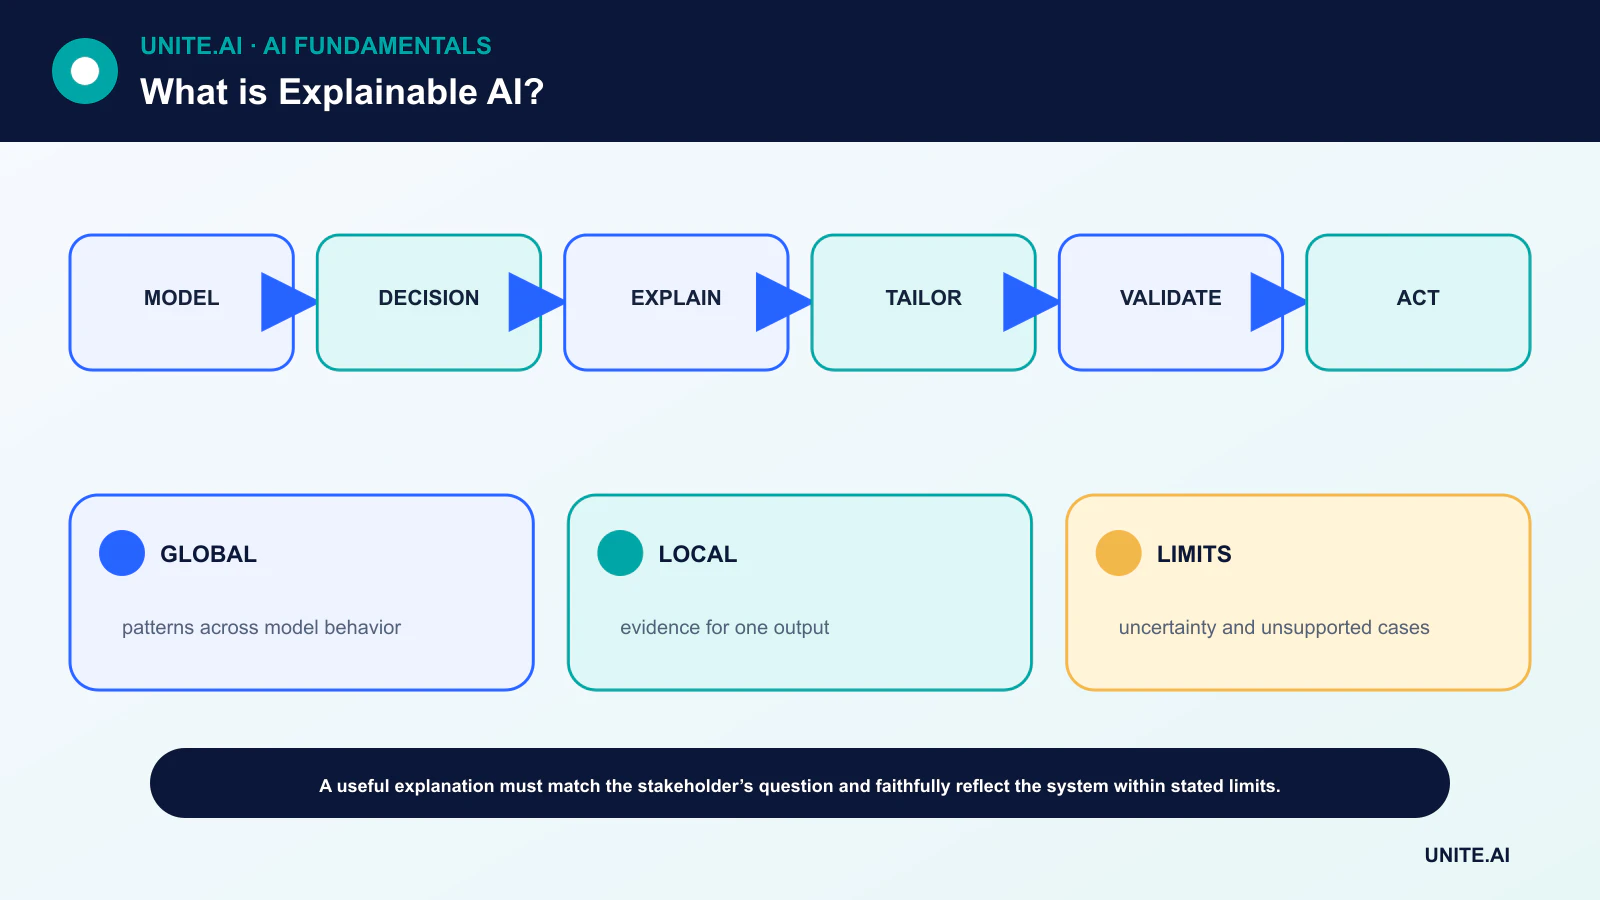
कोई भी व्याख्या सार्वभौमिक रूप से सर्वश्रेष्ठ नहीं होती। मॉडल को डिबग करने वाला डेवलपर, नीति अनुपालन की जाँच करने वाला ऑडिटर और निर्णय से प्रभावित व्यक्ति अलग-अलग प्रमाणों की आवश्यकता रखते हैं। इसलिए व्याख्याओं का मूल्यांकन सटीकता, अर्थ और इच्छित उपयोग के आधार पर किया जाना चाहिए—केवल दृश्य आकर्षण के आधार पर नहीं।
मुख्य बिंदु
- पारदर्शिता उपलब्ध जानकारी को दर्शाती है; व्याख्यात्मकता अर्थ से संबंधित है; व्याख्या प्रमाण या कारणों को संप्रेषित करती है।
- समग्र विधियाँ मॉडल का सार प्रस्तुत करती हैं, जबकि स्थानीय विधियाँ एक भविष्यवाणी या छोटे क्षेत्र को संबोधित करती हैं।
- पोस्ट-हॉक व्याख्याएँ उपयोगी हो सकती हैं लेकिन वे अस्थिर या मूल मॉडल के प्रति अविश्वसनीय हो सकती हैं।
- एक व्याख्या निष्पक्षता, कारणता, सुदृढ़ता या शुद्धता को सिद्ध नहीं करती।
उपयोगी व्याख्याओं के चार सिद्धांत
NIST प्रस्तावित करता है कि एक सिस्टम व्याख्या प्रदान करे, उसे लक्षित उपयोगकर्ता के लिए सार्थक बनाये, यह सुनिश्चित करे कि यह सिस्टम की प्रक्रिया को सटीक रूप से प्रतिबिंबित करे, और उसके ज्ञान सीमाओं को संप्रेषित करे। ये सिद्धांत व्याख्या की उपस्थिति को उसकी गुणवत्ता से अलग करते हैं।
अर्थ दर्शकों के अनुसार विशिष्ट होता है। एक संक्षिप्त कारण कोड आवेदक की मदद कर सकता है, जबकि मॉडल डेवलपर को वितरण, फीचर व्यवहार और विफलता समूहों की आवश्यकता हो सकती है। दोनों को एक ही दस्तावेज़ित सिस्टम और निर्णय संदर्भ से जोड़ा जाना चाहिए।
आंतरिक और पोस्ट-हॉक विधियाँ
एक विरल रैखिक मॉडल या प्रतिबंधित निर्णय वृक्ष अपनी वैध सीमा के भीतर सीधे व्याख्यात्मक हो सकता है। एक जटिल मॉडल इसके बजाय पोस्ट-हॉक फीचर एट्रिब्यूशन, स्थानीय सरोगेट, उदाहरण, सैलियंसी मैप या वैकल्पिक (counterfactual) विधियों का उपयोग कर सकता है।
जब फीचर खराब परिभाषित हों या पाइपलाइन छिपी हो, तो आंतरिक सरलता स्वचालित रूप से विश्वसनीय नहीं होती। पोस्ट-हॉक जटिलता भी स्वचालित रूप से भ्रामक नहीं होती। विधि को उस प्रश्न के विरुद्ध परीक्षण करना चाहिए जिसका उत्तर देने के लिए वह बनाई गई है।
फ़ीचर एट्रिब्यूशन और सहसंबंधित इनपुट
एट्रिब्यूशन विधियाँ स्पष्ट धारणाओं के तहत आउटपुट के हिस्से इनपुट फीचर्स को सौंपती हैं। LIME एक भविष्यवाणी के आसपास एक सरल स्थानीय सरोगेट फिट करता है; SHAP-संबंधित विधियाँ जोड़ात्मक एट्रिब्यूशन को Shapley मान अवधारणाओं से जोड़ती हैं।
सहसंबंधित फीचर एट्रिब्यूशन साझा या बदल सकते हैं, और उच्च एट्रिब्यूशन कारणात्मक प्रभाव नहीं होता। एक फीचर को अलग से बदलने से एक असंभव व्यक्ति, छवि या लेनदेन बन सकता है। व्याख्याओं को अपने बेसलाइन, सैंपलिंग और निर्भरता धारणाओं को स्पष्ट करना चाहिए।
वैकल्पिक (Counterfactual), उदाहरण और समग्र व्यवहार
एक वैकल्पिक (counterfactual) पूछता है कि कौन सा व्यावहारिक परिवर्तन परिणाम को बदल देगा। प्रतिबंध आवश्यक हैं: एक कार्यात्मक व्याख्या को अपरिवर्तनीय, अवैध या अवास्तविक परिवर्तन की सिफ़ारिश नहीं करनी चाहिए। उदाहरण-आधारित विधियाँ प्रोटोटाइप या प्रभावशाली प्रशिक्षण मामलों को दिखाती हैं लेकिन निजी डेटा को उजागर कर सकती हैं।
समग्र विश्लेषण प्रदर्शन, आंशिक निर्भरता, मोनोटोनिसिटी, इंटरैक्शन और उपसमूह व्यवहार की जांच करता है। gradient boosting जैसे एन्सेम्बल्स के लिए, सारांशों को स्थानीय साक्ष्य और अपेक्षित प्रतिबंधों के प्रत्यक्ष परीक्षणों के साथ मिलाएँ।
व्याख्या और सिस्टम का सत्यापन
फ़िडेलिटी, छोटे विक्षोभों के तहत स्थिरता, समतुल्य इनपुट्स में स्थिरता, उपयोगकर्ता समझ और क्या व्याख्या उचित निर्णय का समर्थन करती है, का परीक्षण करें। प्रतिकूल परीक्षणों को यह जांचना चाहिए कि क्या एक प्रभावशाली व्याख्या गलत या हेरफेर किए गए आउटपुट के साथ हो सकती है।
XAI व्यापक मूल्यांकन के भीतर आता है: प्रशिक्षण से अलग रखे गए डेटा पर गुणवत्ता, कैलिब्रेशन, निष्पक्षता, गोपनीयता, सुरक्षा, मॉनिटरिंग और अपील तंत्र। एक व्याख्या जवाबदेही को समर्थन दे सकती है, लेकिन वह जवाबदेह शासन का विकल्प नहीं बन सकती।
व्याख्या लक्ष्य और विधि परिवार
व्याख्या योग्य एआई को एक प्रश्न और दर्शक: एक निर्णय क्यों हुआ, मॉडल सामान्यतः कैसे व्यवहार करता है, किस प्रमाण ने इसे प्रभावित किया, परिणाम को क्या बदल सकता है, या क्या नीति का पालन किया गया, से शुरू होना चाहिए। स्थानीय व्याख्याएँ एक भविष्यवाणी को संबोधित करती हैं; समग्र व्याख्याएँ व्यापक व्यवहार का सार प्रस्तुत करती हैं। आंतरिक रूप से व्याख्यात्मक मॉडल गुणांक, नियम या संरचनाएँ उजागर करते हैं, जबकि पोस्ट-हॉक विधियाँ जटिल मॉडलों का अनुमान लगाती हैं। मॉडल व्यवहार की व्याख्या स्वचालित रूप से दुनिया की कारणात्मक व्याख्या या यह सिद्ध नहीं करती कि निर्णय निष्पक्ष है।
फ़ीचर एट्रिब्यूशन विधियों में ग्रेडिएंट्स, इंटीग्रेटेड ग्रेडिएंट्स, SHAP-शैली मान, परमीटेशन, और स्थानीय सरोगेट मॉडल शामिल हैं। उदाहरण-आधारित व्याख्याएँ प्रभावशाली या समान मामलों को पुनः प्राप्त करती हैं; वैकल्पिक (counterfactual) विभिन्न आउटपुट से जुड़े परिवर्तन प्रस्तावित करती हैं; अवधारणा विधियाँ आंतरिक प्रतिनिधित्व को मानव श्रेणियों से जोड़ती हैं। प्रत्येक की बेसलाइन, फीचर स्वतंत्रता, स्थानीय रैखिकता, या मॉडल एक्सेस के बारे में धारणाएँ होती हैं। सहसंबंधित चर, इंटरैक्शन और प्रीप्रोसेसिंग एट्रिब्यूशन को अस्थिर या भ्रामक बना सकते हैं। विधियों की तुलना करें और इनपुट को बदलकर देखें कि क्या व्याख्या व्यवहार की भविष्यवाणी करती है।
मूल्यांकन और मानव कारक
फ़िडेलिटी का मूल्यांकन करें—क्या व्याख्या मॉडल से मेल खाती है—किसी व्यक्ति को उसके विश्वसनीय लगने से अलग। स्थिरता, संवेदनशीलता, पूर्णता, विरलता, और डिबगिंग या अपील जैसे परिभाषित कार्य के लिए उपयोगिता का परीक्षण करें। मानव अध्ययन में प्रतिनिधिक प्रतिभागी चाहिए और उन्हें निर्णय गुणवत्ता, त्रुटि पहचान, निर्भरता, और समय को मापना चाहिए, न कि यह कि उपयोगकर्ता कहते हैं कि चार्ट स्पष्ट है। एक प्रभावशाली व्याख्या गलत मॉडल में भरोसा बढ़ा सकती है, इसलिए इंटरफ़ेस को अनिश्चितता, विकल्प, और सीमाएँ दिखानी चाहिए।
वैकल्पिक (counterfactual) व्यावहारिक, कार्यात्मक होने चाहिए और संरक्षित या अपरिवर्तनीय गुणों को बदलने की सिफ़ारिश नहीं करनी चाहिए। व्याख्याएँ मॉडल या व्यक्तिगत जानकारी लीक कर सकती हैं और हमलावरों को निर्णयों को रिवर्स इंजीनियर करने में मदद कर सकती हैं। एक्सेस कंट्रोल और आउटपुट न्यूनतमकरण लागू करें। नियामक या उच्च-प्रभाव वाले उपयोगों के लिए, डेटा उत्पत्ति, मॉडल संस्करण, थ्रेशोल्ड, और वास्तविक निर्णय तर्क को बनाए रखें; एक सामान्य फीचर-महत्व ग्राफिक कानूनी रूप से अर्थपूर्ण कारण या मानव समीक्षा का विकल्प नहीं बन सकता।
व्याख्याओं का जिम्मेदार उपयोग
ऐसा सबसे सरल मॉडल चुनें जो प्रदर्शन और संचालनात्मक जरूरतों को पूरा करता हो, लेकिन सतही व्याख्यात्मकता के लिए वैधता का बलिदान न करें। व्याख्याओं को उपसमूह परीक्षण, सुदृढ़ता की जाँच, जहाँ लागू हो कारणात्मक विश्लेषण, और परिणाम मॉनिटरिंग के साथ मिलाएँ। इच्छित दर्शकों और अमान्य निष्कर्षों को दस्तावेज़ करें। यदि एक व्याख्या हानिरहित विक्षोभ के बाद बदलती है, तो तैनाती से पहले जांचें। व्याख्या करने की क्षमता एक विधि के तहत सिस्टम के बारे में प्रमाण है; यह डिबगिंग, निगरानी, और संचार के लिए मूल्यवान है, लेकिन यह सत्य, निष्पक्षता, सुरक्षा, या समझ की गारंटी नहीं देता।
व्यावहारिक उदाहरण: क्रेडिट-रिस्क मॉडल की व्याख्या
एक ऋणदाता पहले दर्शकों और आवश्यक कारण को परिभाषित करता है: आवेदकों को सटीक निर्णय कारक और सुधार पथ चाहिए, जबकि डेवलपर्स को निदान चाहिए। एक कैलिब्रेटेड व्याख्यात्मक बेसलाइन को बूस्टेड मॉडल से तुलना की जाती है। स्थानीय एट्रिब्यूशन, वैकल्पिक (counterfactual) और समग्र त्रुटि विश्लेषण को फ़िडेलिटी, स्थिरता, सहसंबंधित-फ़ीचर व्यवहार, और उपयोगिता के लिए परीक्षण किया जाता है। व्याख्याएँ आयु, विकलांगता या अन्य अपरिवर्तनीय गुण को बदलने की सिफ़ारिश नहीं कर सकतीं, और उन्हें कारणात्मक प्रभाव के रूप में प्रस्तुत नहीं किया जाता।
वास्तविक उपयोग में लिए गए निर्णय रिकॉर्ड स्रोत डेटा, फीचर परिवर्तन, मॉडल, थ्रेशोल्ड, नीति, और मानव कार्रवाई को संरक्षित करता है। आवेदक गलत डेटा को चुनौती दे सकते हैं और एक सार्थक समीक्षा प्राप्त कर सकते हैं। मॉनिटरिंग समूहों और मॉडल अपडेट्स में परिणाम और व्याख्या स्थिरता की जाँच करती है। यदि एक संभावित व्याख्या हानिरहित फीचर विक्षोभ के तहत बदलती है या निर्णायक नीति नियम को छोड़ देती है, तो तैनाती रोक दी जाती है। व्याख्या करने की क्षमता सत्यापन और प्रक्रिया अधिकारों को पूरक करती है; यह अमान्य लक्ष्य, भेदभावपूर्ण परिणाम, या जवाबदेह मानवीय निर्णयाधिकार की कमी को सही नहीं ठहराती।
कार्यान्वयन प्रमाण और संचालन तत्परता
एक वास्तविक उपयोग में लिए गए निर्णय को केवल सफल प्रदर्शन से अधिक की आवश्यकता होती है। इरादे वाले उपयोगकर्ताओं, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादनीय बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपलब्ध इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग, और सबसे अधिक उपेक्षित समूहों या वातावरणों का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, विलंब, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुन: उत्पन्न कर सके और प्रमाण को आकर्षक प्रोटोटाइप से अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक, और रिटायरमेंट के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित बैकअप रखें, और जानबूझकर इंजेक्टेड विफलताओं के साथ मॉनिटरिंग को सत्यापित करें। संचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और अनावश्यक संवेदनशील डेटा एकत्र किए बिना पुष्टि किए गए परिणाम दिखाने चाहिए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑दुनिया के प्रमाण की समीक्षा करें, बजाय यह मानने के कि ऑफ़लाइन प्रदर्शन बना रहेगा। डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियों, हार्डवेयर, या उद्देश्यों में परिवर्तन होने पर पुनः मूल्यांकन करें। नियमित रखरखाव वाली प्रणाली को दस्तावेज़ित पुनर्प्राप्ति, घटना सीखना, डेटा मिटाने और बनाए रखने की प्रक्रियाएँ, और वह स्पष्ट बिंदु चाहिए जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या एटेन्शन मैप्स व्याख्याएँ हैं?
वे निदान संकेत हो सकते हैं, लेकिन केवल एटेन्शन वेट्स यह गारंटी नहीं देते कि वे मॉडल के आउटपुट के कारणों को सटीक रूप से दर्शाते हैं।
क्या व्याख्या योग्य एआई के लिए सरल मॉडल आवश्यक है?
हमेशा नहीं। जटिल मॉडलों का पोस्ट-हॉक विधियों से विश्लेषण किया जा सकता है, लेकिन उन व्याख्याओं को स्वतंत्र सत्यापन और स्पष्ट रूप से बताए गए सीमाओं की आवश्यकता होती है।
प्राथमिक संदर्भ