
एआई की मूल बातें
निर्णय वृक्ष क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
निर्णय वृक्ष एक सुपरवाइज़्ड-लर्निंग मॉडल है जो यदि‑तो नियमों की क्रमबद्ध श्रृंखला लागू करके भविष्यवाणी करता है। प्रत्येक आंतरिक नोड एक फीचर का परीक्षण करता है, प्रत्येक शाखा उस परीक्षण के परिणाम को दर्शाती है, और प्रत्येक पत्ती वर्ग भविष्यवाणी, संभावना, या संख्यात्मक मान उत्पन्न करती है।
निर्णय वृक्ष वर्गीकरण और प्रतिगमन दोनों के लिए उपयोग किए जाते हैं। उनका आकर्षण व्यावहारिक है: वे गैर‑रेखीय अंतःक्रियाओं को दर्शा सकते हैं, अपेक्षाकृत कम पूर्व‑प्रसंस्करण की आवश्यकता होती है, और एक ऐसा पथ उत्पन्न करते हैं जिसे कोई व्यक्ति निरीक्षण कर सकता है। उनकी कमजोरी अस्थिरता है—प्रशिक्षण डेटा में छोटे परिवर्तन भी अलग वृक्ष बना सकते हैं।
मुख्य बिंदु
- एक वृक्ष पुनरावर्ती रूप से फीचर स्पेस को विभाजित करता है; उसे प्रत्येक प्रशिक्षण अवलोकन को अलग‑अलग अलग करने की आवश्यकता नहीं होती।
- वर्गीकरण विभाजन आमतौर पर जिनी अशुद्धता या एंट्रोपी का उपयोग करते हैं, जबकि प्रतिगमन विभाजन भविष्यवाणी त्रुटि या वैरिएंस को कम करते हैं।
- गहराई, न्यूनतम पत्ती आकार, और प्रूनिंग जटिलता और ओवरफ़िटिंग को नियंत्रित करते हैं।
- रैंडम फॉरेस्ट और ग्रेडिएंट‑बूस्टेड ट्री कई वृक्षों को मिलाकर भविष्यवाणी शक्ति बढ़ाते हैं।
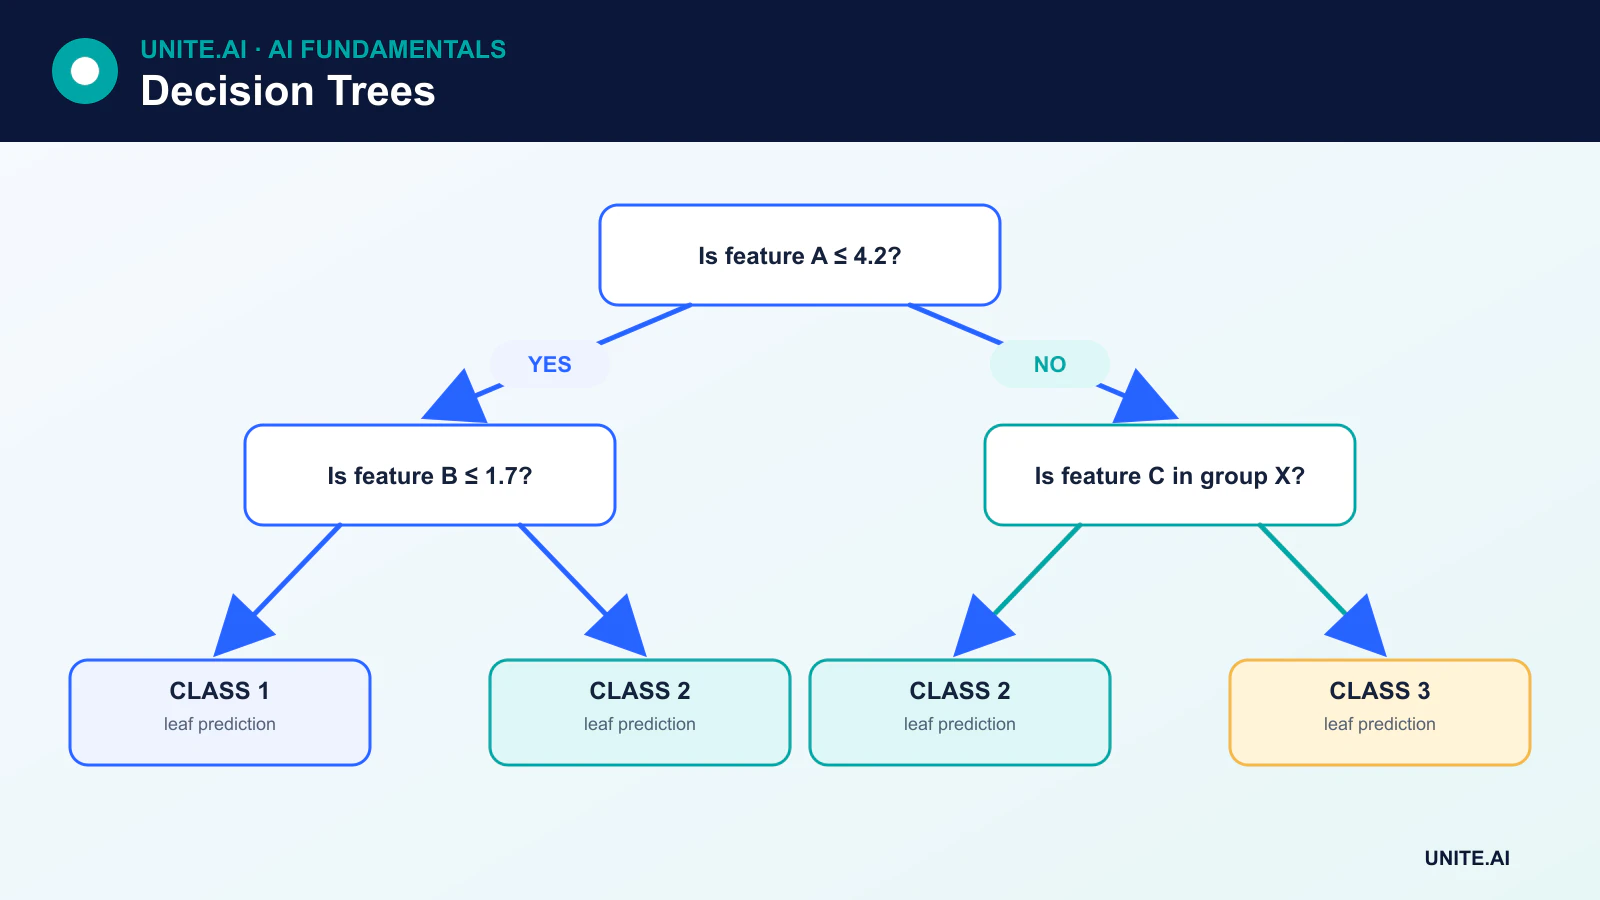
निर्णय वृक्ष कैसे भविष्यवाणी करता है
मान लीजिए एक मॉडल यह भविष्यवाणी करता है कि कोई मशीन विफल होने की संभावना रखती है या नहीं। मूल नोड यह पूछ सकता है कि कंपन एक सीखे हुए सीमा मान से अधिक है या नहीं। एक शाखा फिर संचालन तापमान का परीक्षण कर सकती है। अवलोकन उस पत्ती तक पहुँचता है जिसमें उसी पथ का अनुसरण करने वाले प्रशिक्षण उदाहरणों में अनुमानित विफलता संभावना होती है।
प्रतिगमन के लिए, पत्ती उस क्षेत्र में मौजूद अवलोकनों के औसत लक्ष्य मान को लौटाती है। वर्गीकरण के लिए, यह बहुसंख्यक वर्ग या वर्ग आवृत्तियों का वितरण लौटाती है। एक पत्ती में कई अवलोकन हो सकते हैं; प्रशिक्षण डेटा को पूरी तरह अलग‑अलग करना आमतौर पर अवांछनीय होता है क्योंकि इससे ओवरफ़िटेड वृक्ष बन सकता है।
वृक्ष विभाजन कैसे चुनता है
प्रशिक्षण संभावित फीचर और थ्रेशहोल्ड पर विचार करता है, फिर वह विभाजन चुनता है जो परिभाषित उद्देश्य को सबसे अधिक सुधारता है। सुधार को इस बात से भारित किया जाना चाहिए कि प्रत्येक चाइल्ड नोड में कितने अवलोकन जाते हैं।
जिनी अशुद्धता
वर्गीकरण के लिए, जिनी अशुद्धता मापती है कि नोड में वर्ग कितने मिश्रित हैं:
Gini = 1 - Σ p(k)²
एक नोड जिसमें केवल एक ही वर्ग हो, उसकी अशुद्धता शून्य होती है। एक संभावित विभाजन उपयोगी होता है जब उसके बच्चों की भारित अशुद्धता पैरेंट की अशुद्धता से कम हो।
एंट्रोपी और सूचना लाभ
एंट्रोपी वर्ग अनिश्चितता का एक अन्य माप है:
Entropy = -Σ p(k) log₂ p(k)
सूचना लाभ पैरेंट एंट्रोपी माइनस भारित चाइल्ड एंट्रोपी है। जिनी और एंट्रोपी अक्सर समान वृक्ष उत्पन्न करते हैं, हालांकि हमेशा समान नहीं होते।
प्रतिगमन हानि
प्रतिगमन वृक्ष आमतौर पर ऐसे विभाजन चुनते हैं जो वर्गीकृत त्रुटि, निरपेक्ष त्रुटि, या किसी अन्य प्रतिगमन मानदंड को कम करते हैं। प्रत्येक पत्ती फिर उस क्षेत्र के भीतर प्रशिक्षण लक्ष्यों के आधार पर एक मान भविष्यवाणी करती है।
CART और अन्य वृक्ष एल्गोरिदम
CART, अर्थात् क्लासिफिकेशन एंड रिग्रेशन ट्रीज़, द्विआधारी विभाजनों का उपयोग करता है और scikit-learn के निर्णय वृक्षों जैसी सामान्य कार्यान्वयनों के पीछे आधार है। अन्य एल्गोरिदम में ID3, C4.5, और C5.0 शामिल हैं। कार्यान्वयन उनके समर्थित विभाजन प्रकारों, लापता मानों के संभाल, प्रूनिंग, और उद्देश्यों में भिन्न होते हैं।
श्रेणीबद्ध चर को एन्कोडिंग, प्रत्यक्ष उपसमुच्चय विभाजन, या कार्यान्वयन‑विशिष्ट संभाल की आवश्यकता हो सकती है। लापता मानों को इम्प्यूट किया जा सकता है या सीखे हुए डिफ़ॉल्ट दिशा या सरोगेट विभाजन के माध्यम से संभाला जा सकता है। यह समझना महत्वपूर्ण है कि विशिष्ट लाइब्रेरी का व्यवहार क्या है, न कि यह मान लेना कि सभी वृक्ष कार्यान्वयन समान कार्य करते हैं।
वृक्ष जटिलता को नियंत्रित करना
एक गहरा वृक्ष शोर को याद कर सकता है। सामान्य नियंत्रण शामिल हैं:
- अधिकतम गहराई: भविष्यवाणी पथ की लंबाई को सीमित करता है।
- प्रति विभाजन या पत्ती न्यूनतम नमूने: बहुत छोटे क्षेत्रों को रोकता है।
- न्यूनतम अशुद्धता कमी: विभाजन को पर्याप्त लाभ प्रदान करना आवश्यक बनाता है।
- अधिकतम पत्तियों की संख्या: कुल जटिलता को सीमित करता है।
- लागत‑जटिलता प्रूनिंग: उन शाखाओं को हटाता है जिनका सुधार अतिरिक्त जटिलता को उचित नहीं ठहराता।
प्रूनिंग एक संरचित अनुकूलन प्रक्रिया है, यादृच्छिक हटाना नहीं। हाइपरपैरामीटर को वैलिडेशन डेटा या क्रॉस‑वैलिडेशन के साथ चुना जाना चाहिए, जबकि अंतिम परीक्षण सेट अपरिवर्तित रहना चाहिए।
ताकत और सीमाएँ
निर्णय वृक्ष इंटरैक्शन और थ्रेशहोल्ड प्रभावों को बिना फीचर स्केलिंग के मॉडल कर सकते हैं। वे संख्यात्मक और, कार्यान्वयन पर निर्भर करते हुए, श्रेणीबद्ध इनपुट स्वीकार करते हैं। भविष्यवाणी तेज़ होती है, और एक छोटा वृक्ष दृश्यात्मक रूप से समझना आसान होता है।
हालाँकि, एकल वृक्ष में उच्च वैरिएंस हो सकता है, विभाजन के निकट अचानक भविष्यवाणी परिवर्तन हो सकते हैं, और कई संभावित विभाजन बिंदुओं वाले फीचर को प्राथमिकता दे सकता है। प्रतिगमन में वृक्ष का विस्तार खराब होता है; अवलोकित क्षेत्रों के बाहर, पत्ती अभी भी अपने प्रशिक्षण नमूनों से सीखा मान लौटाती है। एक बड़ा वृक्ष समझने में एक जटिल मॉडल जितना ही कठिन हो सकता है।
एक वृक्ष से एन्सेम्बल तक
एन्सेम्बल लर्निंग कई मॉडलों को मिलाता है। एक रैंडम फॉरेस्ट कई वृक्षों को पुनः‑सैंपल किए गए अवलोकनों और फीचर उपसमुच्चयों पर प्रशिक्षित करता है, फिर उनकी भविष्यवाणियों का औसत लेता है। ग्रेडिएंट बूस्टिंग क्रमिक रूप से वृक्ष बनाता है ताकि प्रत्येक नया वृक्ष शेष त्रुटि को कम करे। ये दृष्टिकोण आमतौर पर एकल वृक्ष से बेहतर प्रदर्शन करते हैं, लेकिन कुछ व्याख्यात्मकता का बलिदान करते हैं और गणनात्मक लागत बढ़ाते हैं।
वृक्ष या एन्सेम्बल से प्राप्त फीचर महत्व को सावधानीपूर्वक व्याख्यायित करना चाहिए। अशुद्धता‑आधारित महत्व पक्षपाती हो सकता है, और किसी फीचर का महत्व कारणता सिद्ध नहीं करता। परमीटेशन इम्पोर्टेंस, पार्टियल‑डिपेंडेंस टूल, और डोमेन समीक्षा अतिरिक्त संदर्भ प्रदान करती हैं।
वृक्ष विभाजन और भविष्यवाणियों को कैसे सीखता है
एक निर्णय वृक्ष पुनरावर्ती रूप से फीचर स्पेस को विभाजित करता है। प्रत्येक नोड पर, प्रशिक्षण एल्गोरिद्म संभावित फीचर थ्रेशहोल्ड या श्रेणी विभाजन का मूल्यांकन करता है और वह विभाजन चुनता है जो अशुद्धता को सबसे अधिक घटाता है, जैसे वर्गीकरण के लिए जिनी या एंट्रोपी और प्रतिगमन के लिए वर्गीकृत त्रुटि। पत्तियाँ प्रशिक्षण अवलोकनों के आधार पर वर्ग वितरण या संख्यात्मक भविष्यवाणी संग्रहीत करती हैं जो उनमें पहुँचते हैं। लालची विभाजन व्यावहारिक रूप से तेज़ है लेकिन यह वैश्विक रूप से सर्वश्रेष्ठ वृक्ष की गारंटी नहीं देता, और विभिन्न नमूनों या टाई‑ब्रेकिंग से अलग संरचनाएँ बन सकती हैं।
सतत, क्रमिक, श्रेणीबद्ध, और लापता फीचर को स्पष्ट रूप से संभालना आवश्यक है। वन‑हॉट एन्कोडिंग कई संभावित विभाजन बना सकती है; मूल श्रेणीबद्ध विधियाँ क्रमिक आँकड़े उपयोग कर सकती हैं लेकिन लीक‑सुरक्षित कार्यान्वयन चाहिए। वृक्ष स्केलिंग की आवश्यकता नहीं रखते, फिर भी वे उच्च‑कार्डिनैलिटी वाले चर को प्राथमिकता दे सकते हैं और छोटे समूहों को अलग‑अलग कर सकते हैं। गहराई, न्यूनतम पत्ती आकार, न्यूनतम अशुद्धता कमी, और लागत‑जटिलता प्रूनिंग वैरिएंस को नियंत्रित करती हैं। इन्हें वैलिडेशन डेटा के साथ चुनें और कैलिब्रेशन का मूल्यांकन करें, क्योंकि कुछ मामलों में कम डेटा पर आधारित पत्ती संभावना अत्यधिक और अस्थिर हो सकती है।
व्याख्या, विफलता मोड, और उत्पादन उपयोग
मूल नोड से पत्ती तक का पथ एक मॉडल भविष्यवाणी के लिए सटीक नियम है, लेकिन यह स्वचालित रूप से कारणात्मक व्याख्या नहीं है। सहसंबद्ध चर एक‑दूसरे की जगह ले सकते हैं, छोटे डेटा परिवर्तन ऊपरी विभाजन को बदल सकते हैं, और सरल दिखने वाला पथ पक्षपाती लेबल पर निर्भर हो सकता है। अशुद्धता‑आधारित वैश्विक फीचर महत्व भ्रामक हो सकता है; परमीटेशन इम्पोर्टेंस, पार्टियल‑डिपेंडेंस, और काउंटरफ़ैक्चुअल जाँच संदर्भ जोड़ती हैं लेकिन उनके भी मान्यताएँ होती हैं। अनिश्चितता रिपोर्ट करें और जांचें कि क्या कोई कथित नियम स्वतंत्र डेटा और संबंधित उपसमूहों पर टिकता है।
एकल वृक्ष तब उपयोगी होते हैं जब पारदर्शिता, कम लेटेंसी, और मध्यम गैर‑रेखीय संरचना महत्वपूर्ण हो, लेकिन एन्सेम्बल आमतौर पर अधिक भविष्यवाणी शक्ति प्रदान करते हैं। सीमा व्यवहार, दुर्लभ श्रेणियाँ, लापता मान, और प्रशिक्षण रेंज के बाहर के इनपुट का मूल्यांकन करें। निर्यातित नियमों को प्रशिक्षण पूर्व‑प्रसंस्करण और संख्यात्मक तुलना को बिल्कुल समान रूप से पुनः उत्पन्न करना चाहिए। पत्ती अधिभोग, आउटपुट वितरण, त्रुटि, और उभरती श्रेणियों की निगरानी करें। यदि कोई वृक्ष कई नए मामलों को एक छोटे या पहले खाली क्षेत्र में ले जाता है, तो समग्र ड्रिफ्ट छोटा दिखे भी समीक्षा ट्रिगर करनी चाहिए। अमान्य स्कीमा के लिए फॉलबैक रखें और प्रत्येक प्रूनिंग या थ्रेशहोल्ड निर्णय का दस्तावेज़ीकरण करें।
व्यावहारिक उदाहरण: एक व्याख्यात्मक ऋण ट्रायेज़ वृक्ष
एक ऋणदाता केवल अधूरे आवेदन को मैन्युअल समीक्षा के लिए प्राथमिकता देने हेतु एक वृक्ष का उपयोग करता है, न कि क्रेडिट को स्वीकृत या अस्वीकृत करने के लिए। लक्ष्य एक दस्तावेज़ित पूर्णता परिणाम है, और प्रवेश पर उपलब्ध फीचर बाद के निर्णयों को बाहर रखते हैं। समूहित समय‑आधारित वैलिडेशन एक उथला प्रून्ड वृक्ष को नियमों और लॉजिस्टिक रिग्रेशन के साथ तुलना करता है। न्यूनतम पत्ती आकार कई आवेदकों पर आधारित नियमों को रोकता है, जबकि कैलिब्रेशन और वर्ग‑विशिष्ट त्रुटियों को चैनलों और संबंधित संरक्षित समूहों में रिपोर्ट किया जाता है।
समीक्षक सटीक पथ और स्रोत मान देखते हैं, लेकिन त्रुटिपूर्ण डेटा को सुधार सकते हैं और रूटिंग को ओवरराइड कर सकते हैं। संगठन सहसंबद्ध प्रॉक्सी और काउंटरफ़ैक्चुअल परिवर्तन का परीक्षण करता है, पत्ती अधिभोग और लापता मान की निगरानी करता है, और छोटे पत्ती में अचानक ट्रैफ़िक को डेटा‑गुणवत्ता घटना के रूप में मानता है। नीति परिवर्तन एक नया मॉडल संस्करण और वैलिडेशन बनाते हैं, न कि अनडॉक्यूमेंटेड विभाजन संपादन। क्योंकि उपयोग पहुँच और बोझ को प्रभावित करता है, आवेदकों को एक मानव चैनल मिलता है और वृक्ष को कभी भी क्रेडिट‑योग्यता के कारणात्मक स्पष्टीकरण के रूप में प्रस्तुत नहीं किया जाता।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय को सफल डेमो से अधिक चाहिए। इरादे वाले उपयोगकर्ता, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता का परिणाम परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादनीय बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या लापता इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग, और सबसे अधिक उपेक्षित समूहों या वातावरणों का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशहोल्ड को रिकॉर्ड करें ताकि स्वतंत्र समीक्षक परिणाम को पुनः उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले रिलीज़, अपवाद, परिवर्तन, रोलबैक, और सेवानिवृत्ति के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट, सुरक्षित फॉलबैक, और जानबूझकर इंजेक्टेड विफलताओं के साथ निगरानी सत्यापित करें। संचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम बिना अनावश्यक संवेदनशील डेटा एकत्र किए दिखाना चाहिए। अलर्ट थ्रेशहोल्ड और प्रतिक्रिया जिम्मेदार को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, न कि यह मानें कि ऑफ़लाइन प्रदर्शन बना रहेगा। डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियाँ, हार्डवेयर, या उद्देश्य बदलने पर पुनर्मूल्यांकन करें। एक रखरखाव‑योग्य प्रणाली को दस्तावेज़ित पुनर्प्राप्ति, घटना‑सीख, विलोपन और प्रतिधारण प्रक्रियाएँ, और एक स्पष्ट बिंदु चाहिए जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
प्राथमिक संदर्भ












