एआई की मूल बातें
ओवरफ़िटिंग क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
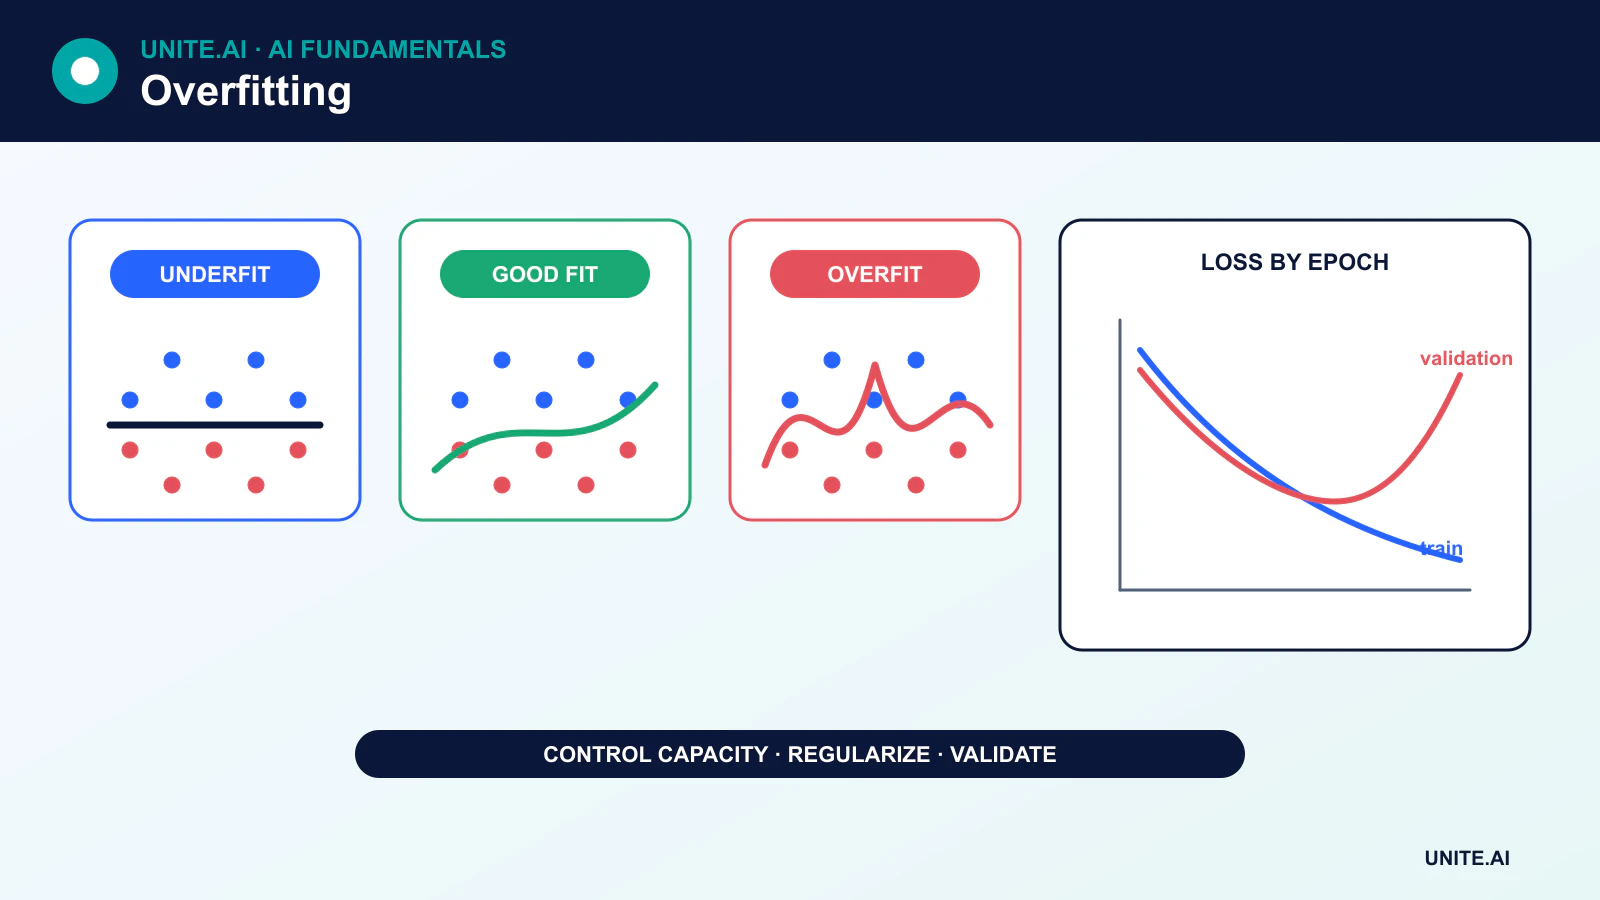
Overfitting तब होता है जब कोई मॉडल प्रशिक्षण डेटा पर अत्यधिक अच्छा काम करने वाले पैटर्न या शोर को पकड़ लेता है, लेकिन नए उदाहरणों पर सामान्यीकरण करने में विफल रहता है। एक ओवरफ़िट मॉडल में प्रशिक्षण त्रुटि बहुत कम हो सकती है जबकि सत्यापन या वास्तविक दुनिया में प्रदर्शन काफी खराब हो सकता है।
विपरीत समस्या underfitting: मॉडल या प्रशिक्षण प्रक्रिया प्रशिक्षण सेट पर भी पर्याप्त संकेत को पकड़ नहीं पाती। अच्छा मॉडलिंग फिट और सामान्यीकरण के बीच संतुलन बनाती है, न कि केवल पूर्ण प्रशिक्षण प्रदर्शन का पीछा करती है।
मुख्य बिंदु
- केवल प्रशिक्षण प्रदर्शन से सामान्यीकरण का निदान नहीं किया जा सकता।
- अर्ली स्टॉपिंग को सत्यापन व्यवहार के आधार पर होना चाहिए, अंतिम टेस्ट सेट पर दोहराए गए निर्णय नहीं।
- अधिक डेटा मदद कर सकता है, लेकिन अधिक फीचर या क्षमता ओवरफ़िटिंग को और बढ़ा सकती है।
- रेग्युलराइज़ेशन, ऑगमेंटेशन, क्रॉस‑वैलिडेशन, लीकेज रोकथाम, और उचित मूल्यांकन विभिन्न कारणों को संबोधित करते हैं।
फ़िट, अंडरफ़िटिंग और ओवरफ़िटिंग
जब मॉडल की धारणाएँ बहुत प्रतिबंधित होती हैं, उसके फीचर महत्वपूर्ण संकेत को छोड़ देते हैं, अनुकूलन अपर्याप्त होता है, या प्रशिक्षण अपर्याप्त होता है, तब मॉडल अंडरफ़िट करता है। प्रासंगिक फीचर या क्षमता जोड़ने से मदद मिल सकती है, लेकिन केवल मनमाने फीचर जोड़ने से शोर और ओवरफ़िटिंग बढ़ सकती है।
जब मॉडल की प्रभावी क्षमता प्रशिक्षण डेटा में मौजूद जानकारी की तुलना में बहुत अधिक होती है, तब मॉडल ओवरफ़िट करता है। उदाहरणों में एक गहरा decision tree जो बहुत छोटे लीव बनाता है, एक बहुपद जो यादृच्छिक उतार‑चढ़ाव का अनुसरण करता है, या एक न्यूरल नेटवर्क जो उदाहरणों को याद रखता है।
प्रशिक्षण, सत्यापन और परीक्षण डेटा की भूमिका
- Training data मॉडल पैरामीटर को फिट करता है।
- Validation data आर्किटेक्चर, हाइपरपैरामीटर, थ्रेशोल्ड और स्टॉपिंग समय चुनता है।
- Test data उन विकल्पों के पूर्ण होने के बाद अंतिम अनुमान प्रदान करता है।
यदि टेस्ट सेट बार‑बार निर्णयों को मार्गदर्शित करता है, तो वह विकास प्रक्रिया का हिस्सा बन जाता है और अब एक निष्पक्ष अंतिम अनुमान नहीं देता। क्रॉस‑वैलिडेशन सीमित डेटा का अधिक कुशल उपयोग कर सकता है, लेकिन सभी प्री‑प्रोसेसिंग और फीचर चयन प्रत्येक प्रशिक्षण फोल्ड के भीतर होना चाहिए।
अर्ली स्टॉपिंग
प्रशिक्षण के दौरान, प्रशिक्षण लॉस आमतौर पर लगातार घटती रहती है। सत्यापन लॉस पहले घट सकती है और बाद में बढ़ सकती है क्योंकि मॉडल प्रशिक्षण शोर के प्रति विशेष हो जाता है। अर्ली स्टॉपिंग सबसे अच्छे सत्यापन उद्देश्य वाले चेकपॉइंट को सहेजती है या तब रुकती है जब सत्यापन एक निर्धारित धैर्य अवधि तक सुधार नहीं दिखाता।
सही चेकपॉइंट वह नहीं है जिसका प्रशिक्षण लॉस सबसे कम हो। अर्ली‑स्टॉपिंग और ट्यूनिंग निर्णय समाप्त होने के बाद एक अलग अंतिम टेस्ट सेट का मूल्यांकन किया जाता है।
रेग्युलराइज़ेशन विधियाँ
वज़न दंड
L2 रेग्युलराइज़ेशन या वज़न क्षय बड़े पैरामीटर मानों को हतोत्साहित करता है। L1 रेग्युलराइज़ेशन विरल गुणांक को प्रोत्साहित कर सकता है। उनका प्रभाव मॉडल और ऑप्टिमाइज़र पर निर्भर करता है; उदाहरण के लिए, AdamW वज़न क्षय को अनुकूलन अपडेट से अलग करता है।
ड्रॉपआउट और स्टोकेस्टिक रेग्युलराइज़ेशन
ड्रॉपआउट प्रशिक्षण के दौरान सक्रियण को यादृच्छिक रूप से मास्क करता है। अन्य विधियाँ पाथ को ड्रॉप करती हैं, फीचर को बाधित करती हैं, या लेबल को स्मूद करती हैं। ये तकनीकें प्रशिक्षण उद्देश्य को बदलती हैं और इन्हें इनफ़रेंस पर निष्क्रिय या उचित रूप से संभालना आवश्यक है।
डेटा ऑगमेंटेशन
ऑगमेंटेशन वास्तविक परिवर्तनों को बनाता है—जैसे क्रॉप, रोटेशन, शोर या पैराफ्रेज़—जो लक्ष्य को बनाए रखना चाहिए। अमान्य रूपांतरण लेबल बदल सकते हैं और मॉडल को नुकसान पहुँचा सकते हैं। विज़न के लिए, Albumentations जैसे टूल नियंत्रित पाइपलाइन को लागू करने में मदद करते हैं।
क्षमता नियंत्रण
उथले ट्री, कम पैरामीटर, फीचर चयन, प्रूनिंग, और सरल हाइपोथीसिस क्लास वैरिएंस को कम कर सकते हैं। ट्री प्रूनिंग मानदंड‑आधारित होती है, न कि सीखे गए विवरण को यादृच्छिक रूप से हटाना।
डेटा लीकेज असाधारण प्रदर्शन जैसा दिख सकता है
लीकेज तब होता है जब भविष्यवाणी समय पर उपलब्ध नहीं होने वाली जानकारी प्रशिक्षण या मूल्यांकन में प्रवेश करती है। सामान्य उदाहरणों में पूरे डेटासेट पर नॉर्मलाइज़ेशन फिट करना, दोहराए गए रिकॉर्ड को फोल्ड्स में विभाजित करना, भविष्य के डेटा का उपयोग करके अतीत की भविष्यवाणी करना, या लक्ष्य से निकाले गए फीचर को शामिल करना शामिल हैं।
लीकेज सामान्य ओवरफ़िटिंग नहीं है, लेकिन यह ऑफ़लाइन परिणामों और उत्पादन के बीच वही भ्रामक अंतर बनाता है। विभाजन रणनीति को समय, पहचान, स्थान और डेटा‑जनरेशन प्रक्रियाओं का सम्मान करना चाहिए।
वितरण शिफ्ट एक अलग समस्या है
एक मॉडल अपने टेस्ट वितरण पर सामान्यीकरण कर सकता है और फिर भी उत्पादन डेटा में बदलाव के कारण विफल हो सकता है। नए डिवाइस, नीतियाँ, जनसंख्या, मौसम, या प्रतिकूल व्यवहार इनपुट या लक्ष्य संबंध को बदल सकते हैं। मॉनिटरिंग और आवधिक पुनः‑मूल्यांकन आवश्यक हैं, भले ही मूल मॉडल ओवरफ़िट नहीं हुआ हो।
ओवरफ़िटिंग का निदान
लर्निंग कर्व, क्रॉस‑वैलिडेशन वैरिएंस, सबग्रुप मीट्रिक, कैलिब्रेशन और त्रुटि निरीक्षण का उपयोग करें। यदि प्रशिक्षण और सत्यापन दोनों का प्रदर्शन खराब है, तो अंडरफ़िटिंग, फीचर, लेबल या ऑप्टिमाइज़ेशन पर ध्यान दें। यदि प्रशिक्षण मजबूत है और सत्यापन कमजोर, तो अधिक डेटा एकत्र करने से पहले क्षमता, लीकेज, रेग्युलराइज़ेशन और प्रतिनिधित्व की जाँच करें।
ओवरफ़िटिंग क्यों होता है और इसे कैसे पहचानें
ओवरफ़िटिंग तब होता है जब मॉडल ऐसे पैटर्न सीखता है जो प्रशिक्षण त्रुटि को कम करते हैं लेकिन लक्ष्य जनसंख्या पर सामान्यीकरण नहीं करते। कारणों में प्रभावी डेटा की तुलना में अत्यधिक क्षमता, लेबल शोर, दोहराए गए इकाइयाँ, लचीला फीचर चयन, लीकेज, और समान सत्यापन सेट पर ट्यूनिंग शामिल हैं। प्रशिक्षण और सत्यापन प्रदर्शन के बीच बढ़ता अंतर सामान्य संकेत है, लेकिन यदि दोनों सेट में दूषितता साझा है या उत्पादन से अलग हैं तो छोटा अंतर भी ओवरफ़िटिंग को बाहर नहीं करता। डेटा मात्रा और क्षमता के across लर्निंग कर्व वैरिएंस और बायस को अलग करने में मदद करते हैं।
लीकेज विशेष रूप से धोखा देने वाला होता है: भविष्य की जानकारी, डुप्लिकेट, विषय ओवरलैप, सभी डेटा पर प्री‑प्रोसेसिंग फिट करना, या मेटाडेटा में एन्कोडेड लेबल उत्कृष्ट होल्ड‑आउट स्कोर दे सकते हैं। परिवर्तन या ऑगमेंटेशन फिट करने से पहले उस इकाई के आधार पर विभाजन करें जो उत्पादन में नया होगा—मरीज, ग्राहक, मशीन, स्थान, या समय। फीचर, आर्किटेक्चर और थ्रेशोल्ड चुनते समय अंतिम टेस्ट सेट को सील रखें। यदि टीमें बार‑बार टेस्ट परिणामों की जाँच करती हैं, तो टेस्ट सेट एक और सत्यापन सेट बन जाता है और उसे बदलना या औपचारिक सुधार की आवश्यकता होती है।
रेग्युलराइज़ेशन, मॉडल चयन और प्रोडक्शन ड्रिफ्ट
अधिक प्रतिनिधि डेटा, कम क्षमता, वज़न क्षय, ड्रॉपआउट, अर्ली स्टॉपिंग, ऑगमेंटेशन, एन्सेम्बलिंग, या डोमेन संरचना को प्रतिबिंबित करने वाले प्रतिबंधों से ओवरफ़िटिंग कम करें। प्रत्येक विधि के अपने ट्रेड‑ऑफ़ होते हैं: ऑगमेंटेशन लेबल को विकृत कर सकता है, ड्रॉपआउट ऑप्टिमाइज़ेशन को बदलता है, और एन्सेम्बलिंग सर्विंग लागत बढ़ाता है। क्रॉस‑वैलिडेशन चयन वैरिएबिलिटी का अनुमान लगाता है, लेकिन समूहित या समय‑सचेत फोल्ड्स को डिप्लॉयमेंट सीमा को बनाए रखना चाहिए। एक सरल मॉडल के साथ तुलना करें और सबसे अनुकूल रन चुनने के बजाय फोल्ड्स या सीड्स में अनिश्चितता रिपोर्ट करें।
उत्पादन तब एक अलग प्रकार की सामान्यीकरण विफलता प्रकट कर सकता है जब इनपुट, उपयोगकर्ता, प्रोत्साहन या माप बदलते हैं। फीचर और प्रेडिक्शन वितरण, कैलिब्रेशन, सबग्रुप परिणाम, और विलंबित ग्राउंड ट्रुथ की निगरानी करें। बिना समीक्षा के फीडबैक पर स्वचालित रूप से पुनः‑ट्रेन न करें; मॉडल के अपने निर्णय बाद में देखे जाने वाले लेबल को आकार दे सकते हैं। पहचानें कि विफलता ड्रिफ्ट, डेटा पाइपलाइन, नीति परिवर्तन या अमान्य लक्ष्य से आती है या नहीं। ओवरफ़िटिंग प्रयोगात्मक डिजाइन और लाइफ़साइकल अनुशासन द्वारा नियंत्रित होती है, न कि एकल रेग्युलराइज़ेशन सेटिंग द्वारा।
व्यावहारिक उदाहरण: धोखाधड़ी मॉडल में लीकेज को समाप्त करना
एक प्रारंभिक धोखाधड़ी वर्गीकर्ता अत्यधिक अच्छा स्कोर देता है क्योंकि दोहराए गए कार्ड और व्यापारी घटनाएँ यादृच्छिक प्रशिक्षण और परीक्षण पंक्तियों में दिखाई देती हैं, और कई हफ़्तों बाद दर्ज चार्जबैक जानकारी को एक फीचर के रूप में शामिल किया जाता है। टीम प्रत्येक फीचर की उपलब्धता समय को पुनः निर्मित करती है, निर्णय‑के‑बाद के फ़ील्ड हटाती है, खाते के अनुसार समूह बनाती है, और आगे की समय विभाजन का उपयोग करती है। प्रदर्शन तेज़ी से गिरता है लेकिन अब वास्तविक निर्णय का अनुमान लगाता है। एक सरल नियम बेसलाइन और लर्निंग कर्व आवश्यक मॉडल जटिलता का मार्गदर्शन करते हैं।
रेग्युलराइज़ेशन और अर्ली स्टॉपिंग केवल ऐतिहासिक फोल्ड्स के भीतर ट्यून किए जाते हैं। अंतिम मूल्यांकन समीक्षा क्षमता पर प्रिसिशन, रिकॉल, कैलिब्रेशन, और धोखाधड़ी प्रकार तथा ग्राहक खंड के अनुसार लागत रिपोर्ट करता है। उत्पादन में, पुष्टि किए गए लेबल देर से आते हैं और यह इस बात से पक्षपाती होते हैं कि कौन‑से लेन‑देन समीक्षा किए गए, इसलिए मॉनिटरिंग स्कोर ड्रिफ्ट को परिणाम अनुमान से अलग करती है। पुनः‑ट्रेनिंग में न्यायिक मामलों का उपयोग किया जाता है और वर्तमान नीति के विरुद्ध पुनः‑प्ले किया जाता है। परियोजना एक कम ईमानदार स्कोर को उच्च लीकेज वाले स्कोर से अधिक प्राथमिकता देती है जो उत्पादन में टिक नहीं सकता।
कार्यान्वयन प्रमाण और संचालन तत्परता
एक उत्पादन निर्णय को सफल प्रदर्शन से अधिक की आवश्यकता होती है। इच्छित उपयोगकर्ताओं, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादक बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपस्थित इनपुट, वितरण शिफ्ट, निर्भरता आउटेज, दुरुपयोग, और उन समूहों या वातावरणों का परीक्षण करें जो सबसे अधिक सेवा‑हीन हो सकते हैं। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनः उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक और रिटायरमेंट के लिए अधिकार सौंपें। एक चरणबद्ध रोलआउट उपयोग करें, एक सुरक्षित फॉलबैक बनाए रखें, और जानबूझकर डाली गई विफलताओं के साथ मॉनिटरिंग सत्यापित करें। ऑपरेशनल टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर उत्पादन के बाद वास्तविक‑दुनिया के प्रमाण की समीक्षा करें, न कि यह मानते हुए कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियाँ, हार्डवेयर, या उद्देश्यों में बदलाव हो, पुनः‑मूल्यांकन करें। एक रखरखाव प्रणाली को दस्तावेज़ीकृत पुनर्प्राप्ति, घटना सीखना, हटाना और प्रतिधारण प्रक्रियाएँ, और एक स्पष्ट बिंदु चाहिए जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या एक सरल मॉडल ओवरफ़िट कर सकता है?
हां। दोहराया गया फीचर चयन, थ्रेशोल्ड ट्यूनिंग, या समान होल्ड‑आउट पर मूल्यांकन विकास प्रक्रिया को ओवरफ़िट कर सकता है, भले ही अंतिम मॉडल सरल हो।
क्या अधिक प्रशिक्षण डेटा हमेशा ओवरफ़िटिंग को हल करता है?
नहीं। अधिक प्रतिनिधि, सही लेबल वाला डेटा मदद कर सकता है, लेकिन डुप्लिकेट, पक्षपाती, लीकेज वाला या डोमेन से बाहर का डेटा मदद नहीं कर सकता। लर्निंग उद्देश्य और मूल्यांकन डिजाइन अभी भी महत्वपूर्ण हैं।
प्राथमिक संदर्भ