
एआई की मूल बातें
ट्रांसफ़र लर्निंग क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
Transfer learning एक समस्या के लिए सीखे गए ज्ञान को पुनः उपयोग करता है ताकि संबंधित समस्या पर सीखने में सुधार हो सके। हर पैरामीटर को यादृच्छिक रूप से प्रारंभ करने के बजाय, प्रैक्टिशनर एक प्री‑ट्रेंड मॉडल या प्रतिनिधित्व से शुरू करता है और उसे लक्ष्य कार्य के लिए अनुकूलित करता है।
यह विधि विशेष रूप से उपयोगी होती है जब लक्ष्य डेटासेट छोटा हो, लेबलिंग महंगी हो, या प्री‑ट्रेनिंग के लिए आवश्यक गणना लक्ष्य टीम द्वारा उचित नहीं मानी जा सके। मॉडल को शून्य से प्रशिक्षण देना ट्रांसफ़र लर्निंग का विकल्प है—ट्रांसफ़र लर्निंग का एक प्रकार नहीं।
मुख्य बिंदु
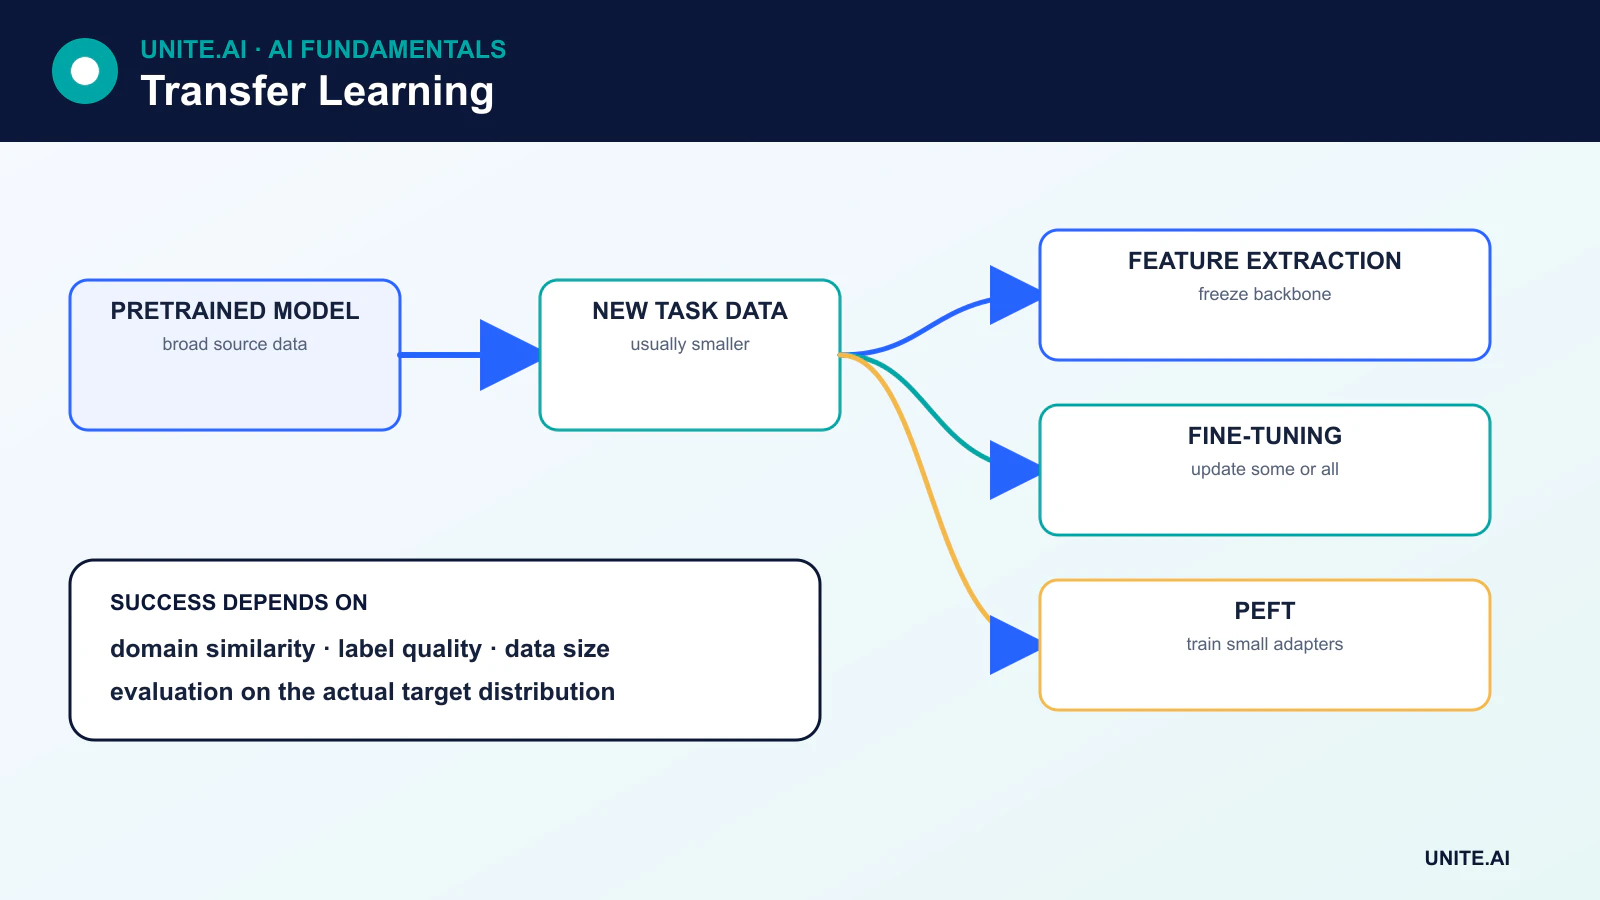
- फ़ीचर एक्सट्रैक्शन प्री‑ट्रेंड बेस को स्थिर रखता है और एक नया कार्य‑विशिष्ट हेड प्रशिक्षित करता है।
- फ़ाइन‑ट्यूनिंग लक्ष्य‑डोमेन डेटा का उपयोग करके कुछ या सभी प्री‑ट्रेंड पैरामीटर को अपडेट करता है।
- एडाप्टर और LoRA जैसी पैरामीटर‑कुशल विधियाँ मॉडल के छोटे हिस्से को अपडेट करती हैं।
- स्रोत और लक्ष्य डोमेनों में अंतर, लाइसेंस टकराव, या स्रोत मॉडल में अनुचित पक्षपात होने पर ट्रांसफ़र विफल हो सकता है।
ट्रांसफ़र लर्निंग क्यों काम करती है
मॉडल अक्सर ऐसी प्रतिनिधित्व सीखते हैं जो उनके प्रशिक्षित किए गए सटीक डेटा से परे उपयोगी होते हैं। एक इमेज मॉडल की शुरुआती परतें पुनः उपयोग योग्य स्थानीय पैटर्न को पकड़ सकती हैं; एक भाषा मॉडल स्वयं‑सुपरवाइज़्ड प्रेडिक्शन से वाक्यविन्यास, अर्थविज्ञान और व्यापक संबन्ध सीख सकता है। लक्ष्य कार्य इन प्रतिनिधित्वों पर निर्माण कर सकता है बजाय सीमित उदाहरणों से सब कुछ फिर से सीखने के।
लाभ स्रोत और लक्ष्य कार्यों के बीच समानता, प्री‑ट्रेनिंग के पैमाने और गुणवत्ता, तथा मॉडल के अनुकूलन के तरीके पर निर्भर करता है। पुनः उपयोग की कोई गारंटी नहीं है: स्थानांतरित फ़ीचर अप्रासंगिक या सक्रिय रूप से हानिकारक हो सकते हैं।
फ़ीचर एक्सट्रैक्शन
फ़ीचर एक्सट्रैक्शन में, प्री‑ट्रेंड बेस को स्थिर किया जाता है ताकि उसके पैरामीटर न बदलें। उसका आउटपुट एक नए वर्गीकार, रिग्रेसर, या अन्य कार्य‑विशिष्ट हेड का इनपुट बन जाता है। केवल नया हेड प्रशिक्षित किया जाता है।
यह तेज़ और डेटा‑कुशल है, तथा उपयोगी प्री‑ट्रेंड प्रतिनिधित्व को नष्ट होने के जोखिम को कम करता है। जब लक्ष्य डोमेन प्री‑ट्रेनिंग से काफी अलग हो तो यह अंडरफ़िट भी कर सकता है। बैच नॉर्मलाइज़ेशन जैसी परतों को विशेष देखभाल की आवश्यकता होती है क्योंकि उनके संग्रहीत आँकड़े और प्रशिक्षण व्यवहार अनुकूलन को प्रभावित कर सकते हैं, भले ही अधिकांश वज़न स्थिर हों।
फ़ाइन‑ट्यूनिंग
फ़ाइन‑ट्यूनिंग लक्ष्य डेटा पर प्री‑ट्रेंड पैरामीटर को अपडेट करता है। एक सामान्य कार्यप्रवाह है:
- प्री‑ट्रेंड मॉडल लोड करें और आउटपुट हेड को बदलें या जोड़ें।
- बेस को स्थिर रखें और नए हेड को प्रशिक्षित करें।
- चयनित परतों—या पूरे मॉडल—को अनफ़्रीज़ करें और छोटे लर्निंग रेट के साथ जारी रखें।
- ओवरफ़िटिंग, फ़रगेटिंग, और लक्ष्य‑डोमेन प्रदर्शन के लिए वैलिडेशन करें।
ऐसा कोई सार्वभौमिक नियम नहीं है कि केवल अंतिम परतों को ट्यून किया जाए। सर्वोत्तम विकल्प आर्किटेक्चर, लक्ष्य‑डेटा आकार, डोमेन समानता, नॉर्मलाइज़ेशन परतें, मेमोरी और कंप्यूट पर निर्भर करता है। पूर्ण फ़ाइन‑ट्यूनिंग अधिक क्षमता प्रदान कर सकती है लेकिन अधिक संसाधनों की आवश्यकता होती है और यह विनाशकारी फ़रगेटिंग का कारण बन सकती है।
पैरामीटर‑कुशल फ़ाइन‑ट्यूनिंग
बड़े ट्रांसफ़ॉर्मर पूर्ण फ़ाइन‑ट्यूनिंग को महँगा बनाते हैं। पैरामीटर‑कुशल फ़ाइन‑ट्यूनिंग (PEFT) छोटे सेट के पैरामीटर को संशोधित या जोड़ता है जबकि बेस मॉडल के अधिकांश हिस्से को स्थिर रखता है।
- एडाप्टर नेटवर्क में छोटे ट्रेनएबल मॉड्यूल डालते हैं।
- LoRA वज़न अपडेट को लो‑रैंक मैट्रिक्स के साथ दर्शाता है, जिससे ट्रेनएबल पैरामीटर और ऑप्टिमाइज़र मेमोरी कम होती है।
- प्रॉम्प्ट और प्रीफ़िक्स ट्यूनिंग निरंतर कार्य‑विशिष्ट इनपुट या आंतरिक प्रीफ़िक्स सीखते हैं।
PEFT एक बेस मॉडल के चारों ओर कई कार्य अनुकूलन संग्रहीत कर सकता है, हालांकि इनफ़रेंस सर्विंग, एडाप्टर संगतता, और मर्ज्ड‑वेट प्रबंधन को अभी भी सावधानीपूर्वक इंजीनियरिंग की आवश्यकता होती है।
डेटा प्रकारों के बीच ट्रांसफ़र लर्निंग
इमेज क्लासिफ़ायर अक्सर बड़े इमेज डेटासेट पर प्री‑ट्रेंड मॉडल से शुरू होते हैं। भाषा प्रणालियाँ एक फाउंडेशन मॉडल से शुरू होती हैं और इसे सुपरवाइज़्ड फ़ाइन‑ट्यूनिंग, प्रेफ़रेंस ऑप्टिमाइज़ेशन, रिट्रीवल, या टूल उपयोग के माध्यम से अनुकूलित करती हैं। स्पीच, ऑडियो, प्रोटीन, और मल्टीमॉडल मॉडल समान पैटर्न का अनुसरण करते हैं।
ट्रांसफ़र मूल मॉडल को बदले बिना भी हो सकता है। एक स्थिर मॉडल डाउनस्ट्रीम क्लासिफ़ायर, एक वेक्टर सिमिलैरिटी सर्च सिस्टम, या एक रिट्रीवल पाइपलाइन के लिए एम्बेडिंग उत्पन्न कर सकता है।
डोमेन शिफ्ट और नकारात्मक ट्रांसफ़र
डोमेन शिफ्ट तब होता है जब लक्ष्य इनपुट स्रोत डेटा से भिन्न होते हैं। उदाहरण के लिए, एक मेडिकल इमेज मॉडल को ऐसे उपकरण, जनसंख्या, या अधिग्रहण प्रोटोकॉल मिल सकते हैं जो प्री‑ट्रेनिंग में नहीं थे। नकारात्मक ट्रांसफ़र का अर्थ है कि पुनः उपयोग लक्ष्य प्रदर्शन को उचित शून्य‑से‑शुरू बेसलाइन से भी खराब बना देता है।
टीमों को अनुकूलन रणनीतियों की तुलना करनी चाहिए, अर्थपूर्ण उपसमूहों का मूल्यांकन करना चाहिए, और लक्ष्य‑डोमेन टेस्ट सेट रखना चाहिए। यदि स्रोत कार्य खराब मेल खाता है, तो एक छोटा डोमेन‑विशिष्ट मॉडल बड़े सामान्य मॉडल से बेहतर प्रदर्शन कर सकता है।
लाइसेंसिंग, उत्पत्ति, और सुरक्षा
डाउनलोड करने योग्य मॉडल को स्वचालित रूप से तैनात करने के लिए सुरक्षित नहीं माना जाता। लाइसेंस, अनुमत उपयोग, प्रशिक्षण‑डेटा खुलासे, मॉडल‑कार्ड सीमाएँ, और निर्भरता श्रृंखला की समीक्षा करें। मॉडल पक्षपात को दोहरा सकते हैं, संवेदनशील डेटा को याद रख सकते हैं, या दुर्भावनापूर्ण सीरियलाइज़्ड कोड शामिल कर सकते हैं। भरोसेमंद फ़ॉर्मेट का उपयोग करें, आर्टिफ़ैक्ट स्कैन करें, और अनविश्वसनीय वज़न को अलगाव वाले वातावरण में लोड करें।
ट्रांसफ़र लर्निंग कब उपयोग करें
जब एक प्रासंगिक प्री‑ट्रेंड मॉडल उपलब्ध हो और लक्ष्य डेटा सीमित हो, तो ट्रांसफ़र लर्निंग एक मजबूत डिफ़ॉल्ट विकल्प है। जब डोमेन अत्यधिक विशिष्ट हो, लाइसेंस असंगत हो, मॉडल आकार तैनाती सीमाओं से अधिक हो, या एक सरल कार्य बड़े प्री‑ट्रेंड प्रतिनिधित्व से लाभ नहीं उठाता, तो शून्य से प्रशिक्षण अधिक उपयुक्त हो सकता है। निर्णय को मॉडल के पैमाने से अनुमानित करने के बजाय व्यावहारिक रूप से सत्यापित किया जाना चाहिए।
क्या ट्रांसफ़र होता है और इसे कैसे अनुकूलित करें
ट्रांसफ़र लर्निंग स्रोत कार्य या डेटासेट पर सीखे गए प्रतिनिधित्व को लक्ष्य कार्य के लिए पुनः उपयोग करता है। विज़न में, शुरुआती फ़ीचर अक्सर किनारों और बनावटों को पकड़ते हैं; भाषा में, प्री‑ट्रेंड मॉडल टोकन और संदर्भों में सांख्यिकीय पैटर्न को एन्कोड करते हैं। ट्रांसफ़र तब काम करता है जब स्रोत प्रतिनिधित्व में लक्ष्य के लिए प्रासंगिक जानकारी होती है, लेकिन डोमेन, लेबल, मोडैलिटी, और अधिग्रहण अंतर नकारात्मक ट्रांसफ़र उत्पन्न कर सकते हैं। एक प्री‑ट्रेंड बेसलाइन से शुरू करें, उसके प्रशिक्षण लाइसेंस और दस्तावेज़ीकरण की जाँच करें, और इसे शून्य से एक छोटा लक्ष्य‑विशिष्ट मॉडल प्रशिक्षण के साथ तुलना करें।
फ़ीचर एक्सट्रैक्शन बैकबोन को स्थिर करता है और नया हेड प्रशिक्षित करता है; आंशिक फ़ाइन‑ट्यूनिंग चयनित परतों को अनफ़्रीज़ करता है; पूर्ण फ़ाइन‑ट्यूनिंग पूरे मॉडल को अपडेट करता है। पैरामीटर‑कुशल विधियाँ एडाप्टर या लो‑रैंक अपडेट जोड़ती हैं, जिससे ट्रेनएबल पैरामीटर कम होते हैं लेकिन अनिवार्य रूप से इनफ़रेंस मेमोरी नहीं घटती। प्री‑ट्रेंड वज़न के लिए कम लर्निंग रेट उपयोग करें, नॉर्मलाइज़ेशन व्यवहार को बनाए रखें, और आवश्यकतानुसार शेड्यूल, रेग्युलराइज़ेशन, रिहर्सल, या प्रतिबंधित अपडेट के साथ विनाशकारी फ़रगेटिंग से बचें। लक्ष्य वैलिडेशन डेटा पर चेकपॉइंट चुनें और कई सीड्स का परीक्षण करें क्योंकि छोटे लक्ष्य डेटासेट में उच्च वैरिएंस उत्पन्न होता है।
डेटा, मूल्यांकन, और तैनाती के समझौते
लक्ष्य डेटा को तैनाती स्थितियों और महत्वपूर्ण उपसमूहों का प्रतिनिधित्व करना चाहिए, न कि केवल एक सुविधाजनक लेबल्ड नमूना होना चाहिए। विषय, स्रोत, समय, या स्थान के आधार पर विभाजन करें ताकि संबंधित उदाहरण विभाजनों को पार न करें। इन‑डोमेन और शिफ्टेड स्थितियों दोनों का परीक्षण करें। गुणवत्ता, कैलिब्रेशन, प्रशिक्षण लागत, लेटेंसी, और मजबूती के आधार पर स्थिर, आंशिक‑ट्यून्ड, और पूर्ण‑ट्यून्ड वैरिएंट्स की तुलना करें। औसत स्कोर में सुधार स्रोत पक्षपात से विरासत में मिली दुर्लभ वर्गों पर नुकसान को छिपा सकता है। स्रोत‑विशिष्ट शॉर्टकट, शब्दावली अंतर, या सेंसर अंतर के लिए विफलता उदाहरणों की समीक्षा करें।
बेस मॉडल, वज़न, टोकनाइज़र या प्री‑प्रोसेसिंग, एडाप्टर, डेटा, और लाइसेंस को एक निर्भरता ग्राफ़ के रूप में ट्रैक करें। होस्टेड बेस मॉडल व्यवहार बदल सकते हैं; ओपन वज़न आपूर्ति‑श्रृंखला और पैचिंग जिम्मेदारियाँ ला सकते हैं। मर्ज्ड या एक्सपोर्टेड आर्टिफ़ैक्ट को वैलिडेट करें और अनविश्वसनीय स्रोतों से मॉडल फ़ाइलों को स्कैन करें। प्रोडक्शन में, लक्ष्य ड्रिफ्ट और प्रदर्शन की निगरानी करें, और अनुकूलन तथा बेस संस्करण दोनों को रोल बैक करने की क्षमता रखें। ट्रांसफ़र आवश्यक लक्ष्य डेटा को घटाता है; यह लेबलिंग, मूल्यांकन, गोपनीयता, या डोमेन विशेषज्ञता को समाप्त नहीं करता।
व्यावहारिक उदाहरण: एक विज़न मॉडल को नई क्लिनिक में अनुकूलित करना
एक क्लिनिक प्री‑ट्रेंड इमेजिंग एन्कोडर को डायग्नोस्टिक रिव्यू से पहले इमेज गुणवत्ता वर्गीकृत करने के लिए अनुकूलित करता है। यह स्रोत मॉडल के लाइसेंस और इच्छित मोडैलिटी की पुष्टि करता है, स्थानीय उपकरणों और अधिग्रहण स्थितियों को एकत्र करता है, और रोगी के आधार पर विभाजन करता है। स्थिर‑फ़ीचर, एडाप्टर, आंशिक, और पूर्ण फ़ाइन‑ट्यूनिंग वैरिएंट्स को एक छोटे स्थानीय बेसलाइन के साथ तुलना की जाती है। मेट्रिक्स में क्लास रिकॉल, कैलिब्रेशन, उपसमूह व्यवहार, कंप्यूट, और उपकरण, साइट, तथा दुर्लभ आर्टिफ़ैक्ट्स के प्रति संवेदनशीलता शामिल हैं।
अनुकूलित मॉडल निदान नहीं कर सकता और कम‑विश्वास या असमर्थित इमेज को तकनीशियनों को भेजता है। एक्सपोर्ट वैलिडेशन स्थानीय प्री‑प्रोसेसिंग और संख्यात्मक समानता की पुष्टि करता है। मॉडल, एडाप्टर, डिवाइस, और डेटासेट संस्करण रिकॉर्ड में जुड़े होते हैं। मॉनिटरिंग नए स्कैनर, प्रोटोकॉल परिवर्तन, और आउटपुट ड्रिफ्ट का पता लगाती है, जबकि आवधिक समीक्षा किए गए नमूने वास्तविक प्रदर्शन का अनुमान लगाते हैं। स्रोत‑मॉडल अपग्रेड को एक नई निर्भरता माना जाता है जिसके लिए वैलिडेशन आवश्यक है; ट्रांसफ़र लर्निंग स्वचालित रूप से पुराने साक्ष्य को पुनः उपयोग करने को उचित नहीं ठहराता।
कार्यान्वयन साक्ष्य और परिचालन तत्परता
एक प्रोडक्शन निर्णय को सफल प्रदर्शन से अधिक की आवश्यकता होती है। इरादे वाले उपयोगकर्ताओं, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादक बेसलाइन और संस्करणीकृत मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपलब्ध इनपुट, वितरण शिफ्ट, निर्भरता आउटेज, दुरुपयोग, और सबसे अधिक उपेक्षित समूहों या वातावरण का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनः उत्पन्न कर सके और आकर्षक प्रोटोटाइप से साक्ष्य को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक, और रिटायरमेंट के लिए अधिकार सौंपें। एक चरणबद्ध रोलआउट उपयोग करें, एक सुरक्षित फ़ॉलबैक बनाए रखें, और जानबूझकर इंजेक्ट किए गए विफलताओं के साथ मॉनिटरिंग को सत्यापित करें। ऑपरेशनल टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑विश्व साक्ष्य की समीक्षा करें, न कि यह मानते हुए कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियाँ, हार्डवेयर, या लक्ष्य बदलें, पुनः मूल्यांकन करें। एक रखरखाव किया गया सिस्टम दस्तावेज़ीकृत पुनर्प्राप्ति, घटना सीखना, हटाने और रखरखाव प्रक्रियाएँ, और एक स्पष्ट बिंदु चाहिए जहाँ इसे निष्क्रिय या बदलना चाहिए।
प्राथमिक संदर्भ











