
एआई की मूल बातें
बैकप्रोपेगेशन क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
Backpropagation वह एल्गोरिद्म है जो यह गणना करता है कि एक न्यूरल नेटवर्क का लॉस उसके ट्रेन करने योग्य पैरामीटरों के सापेक्ष कैसे बदलता है। यह फॉरवर्ड पास के दौरान रिकॉर्ड किए गए ऑपरेशनों के माध्यम से चेन रूल को पीछे की ओर लागू करता है।
Backpropagation ग्रेडिएंट्स की गणना करता है; यह स्वयं अपडेट तय नहीं करता। stochastic gradient descent या AdamW जैसे ऑप्टिमाइज़र इन ग्रेडिएंट्स का उपयोग वज़न, बायस और अन्य ट्रेन करने योग्य पैरामीटरों को बदलने के लिए करता है।
मुख्य बिंदु
- फॉरवर्ड पास मध्यवर्ती मान बनाता है और एक भविष्यवाणी उत्पन्न करता है।
- लॉस फ़ंक्शन भविष्यवाणी और लक्ष्य को एक स्केलर प्रशिक्षण उद्देश्य में परिवर्तित करता है।
- Backpropagation स्थानीय अवकलज और चेन रूल का उपयोग करके पैरामीटर ग्रेडिएंट्स को कुशलतापूर्वक गणना करता है।
- आधुनिक फ्रेमवर्क कम्प्यूटेशनल ग्राफ़ पर रिवर्स-मोड ऑटोमैटिक डिफरेंशिएशन को लागू करते हैं।
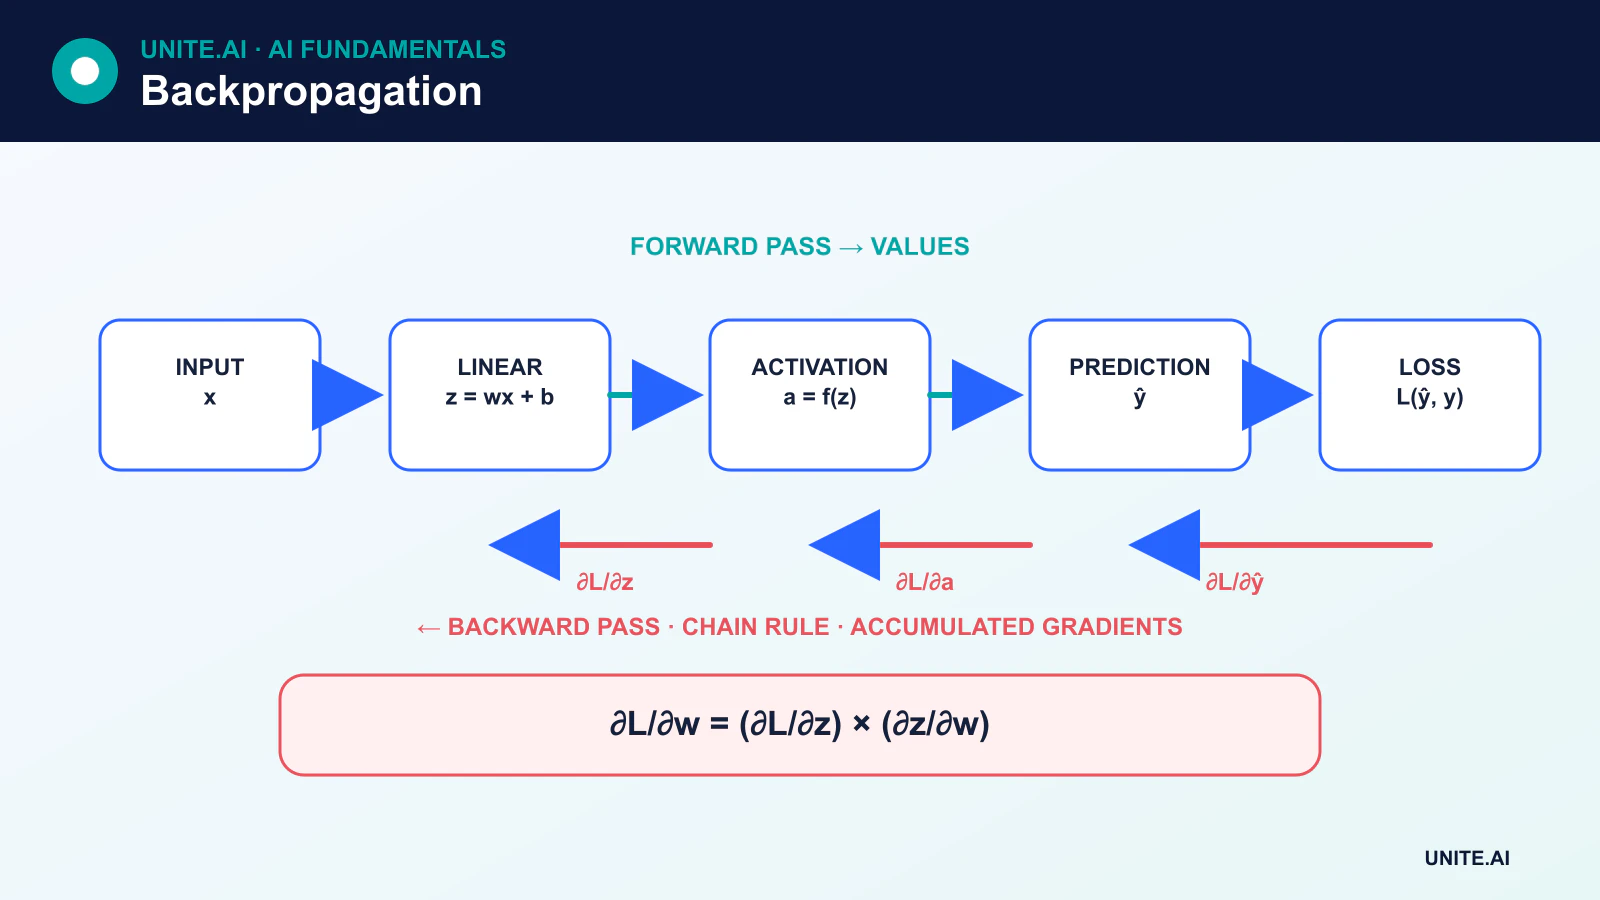
फ़ॉरवर्ड पास
एक सरल इकाई पर विचार करें:
z = wx + bŷ = activation(z)
इनपुट x है, जबकि w और b ट्रेन करने योग्य वज़न और बायस पैरामीटर हैं। बायस आमतौर पर प्रशिक्षण के दौरान वज़न की तरह बदलते हैं। एक नेटवर्क कई ऐसे ऑपरेशनों को, साथ ही नॉर्मलाइज़ेशन, अटेंशन, कॉन्वॉल्यूशन, रेजिडुअल कनेक्शन या अन्य डिफ़रेंशिएबल ब्लॉक्स को मिलाकर उपयोग करता है।
फ़ॉरवर्ड पास इन ऑपरेशनों का मूल्यांकन करता है और एक भविष्यवाणी उत्पन्न करता है। क्रॉस‑एंट्रॉपी या मीन स्क्वेर्ड एरर जैसी लॉस फ़ंक्शन उद्देश्य को मापती है। सर्वश्रेष्ठ लॉस कार्य और आउटपुट की व्याख्या पर निर्भर करता है।
चेन रूल
यदि लॉस L किसी मध्यवर्ती मान z पर निर्भर करता है, और z पैरामीटर w पर निर्भर करता है, तो चेन रूल देता है:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
एक गहरा नेटवर्क कई पाथ रखता है। Backpropagation कम्प्यूटेशनल ग्राफ़ को उल्टे क्रम में पार करता है, उन योगदानों को जोड़ता है जहाँ कोई मान कई पाथ के माध्यम से लॉस को प्रभावित करता है। परिणामस्वरूप प्रत्येक ट्रेन करने योग्य पैरामीटर के लिए एक ग्रेडिएंट प्राप्त होता है जिसने फ़ॉरवर्ड गणना में भाग लिया था।
एक छोटा संख्यात्मक उदाहरण
मान लीजिए ŷ = wx + b, जहाँ x = 2, w = 3, और b = 1 है। भविष्यवाणी 7 है। यदि लक्ष्य 5 है और लॉस L = ½(ŷ - y)² है, तो:
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
ऑप्टिमाइज़र तब w और b को नकारात्मक‑ग्रेडिएंट दिशा में ले जा सकता है। यह सूत्र चुनी हुई रैखिक इकाई और वर्ग‑त्रुटि लॉस के लिए विशिष्ट है; एक सार्वभौमिक बैकप्रोपेगेशन नियम वास्तविक ग्राफ़ पर चेन रूल है, न कि कोई स्थिर “त्रुटि” समीकरण।
Backpropagation बनाम Gradient Descent
Gradient descent एक अनुकूलन विधि है। Backpropagation उसे आवश्यक ग्रेडिएंट्स प्रदान करता है। एक प्रशिक्षण चरण आमतौर पर इस क्रम में होता है:
- सहेजे गए ग्रेडिएंट्स को साफ़ या रीसेट करें।
- फ़ॉरवर्ड पास चलाएँ।
- लॉस की गणना करें।
- बैकवर्ड पास चलाएँ।
- ऑप्टिमाइज़र अपडेट लागू करें।
इन अवधारणाओं को अलग‑अलग समझने से मोमेंटम, AdamW, ग्रेडिएंट एग्रीगेशन और मिश्रित‑प्रेसिशन प्रशिक्षण को समझना आसान हो जाता है।
ऑटोमैटिक डिफरेंशिएशन
PyTorch जैसे फ्रेमवर्क ऑपरेशनों को रिकॉर्ड करते हैं और फ़ॉरवर्ड पास के दौरान एक ग्राफ़ बनाते हैं। रिवर्स‑मोड ऑटोमैटिक डिफरेंशिएशन फिर आउटपुट से पैरामीटरों तक वेक्टर‑जैकॉबियन उत्पादों की कुशल गणना करता है। यह स्थिर नेटवर्क के लिए मैन्युअल रूप से अवकलज कोड करने से अधिक सामान्य है और आधुनिक डीप लर्निंग फ्रेमवर्क का आधार है।
कुछ ऑपरेशनों के डिफरेंशिएबल नहीं होते या उनके अवकलज अस्थिर होते हैं। फ्रेमवर्क कुछ मामलों में सबग्रेडिएंट या प्रलेखित सम्मेलनों को परिभाषित करते हैं, लेकिन प्रैक्टिशनरों को फिर भी डिटैच्ड टेंसर, इन‑प्लेस ऑपरेशनों और संख्यात्मक प्रिसीजन को समझना आवश्यक है।
वैनिशिंग और एक्स्प्लोडिंग ग्रेडिएंट्स
कई लेयर या टाइम‑स्टेप्स के माध्यम से पुनरावृत्त गुणा ग्रेडिएंट्स को अत्यधिक छोटा या बड़ा बना सकता है। वैनिशिंग ग्रेडिएंट्स शुरुआती लेयरों में सीखने को धीमा कर देते हैं; एक्स्प्लोडिंग ग्रेडिएंट्स अपडेट को अस्थिर कर देते हैं। ReLU‑परिवार की एक्टिवेशन, सावधानीपूर्वक इनिशियलाइज़ेशन, रेजिडुअल कनेक्शन, नॉर्मलाइज़ेशन, गेटेड रिकर्रेंस, और ग्रेडिएंट क्लिपिंग मदद करते हैं, लेकिन कोई भी सार्वभौमिक समाधान नहीं है।
ग्रेडिएंट्स की जाँच
फ़ाइनाइट‑डिफरेंस ग्रेडिएंट चेकिंग विश्लेषणात्मक या ऑटोमैटिक ग्रेडिएंट को संख्यात्मक अनुमान के साथ तुलना करती है। यह धीमा है लेकिन कस्टम ऑपरेशनों के डिबगिंग के लिए उपयोगी है। ग्रेडिएंट नॉर्म की निगरानी और NaN या अनंत मानों का पता लगाना प्रशिक्षण के दौरान अस्थिरता को उजागर कर सकता है।
कम्प्यूटेशनल ग्राफ़ के माध्यम से चेन रूल
Backpropagation स्केलर लॉस के संबंध में प्रत्येक डिफ़रेंशिएबल पैरामीटर के ग्रेडिएंट को कुशलतापूर्वक गणना करता है। फ़ॉरवर्ड पास कम्प्यूटेशनल ग्राफ़ में मध्यवर्ती मानों को रिकॉर्ड करता है। लॉस से शुरू होकर, रिवर्स‑मोड ऑटोमैटिक डिफरेंशिएशन चेन रूल लागू करता है, स्थानीय अवकलजों को गुणा करता है और जहाँ पाथ मिलते हैं वहाँ योगदानों को जोड़ता है। किसी लेयर y=f(x,w) के लिए, y के प्रति अपस्ट्रीम सेंसिटिविटी को आंशिक अवकलजों के साथ मिलाकर x और w के लिए सेंसिटिविटी प्राप्त की जाती है। Backpropagation ग्रेडिएंट्स की गणना करता है; ऑप्टिमाइज़र तय करता है कि पैरामीटर कैसे बदलेंगे।
एक साधारण अफ़ाइन लेयर y=Wx+b उत्पन्न करती है। W के लिए ग्रेडिएंट अपस्ट्रीम ग्रेडिएंट और इनपुट का बाहरी गुणनफल होता है, b के लिए ग्रेडिएंट अपस्ट्रीम मानों का योग होता है, और इनपुट ग्रेडिएंट ट्रांसपोज़्ड वज़न मैट्रिक्स से गुणा होता है। एक्टिवेशन एलिमेंट‑वाइज़ अवकलज जोड़ते हैं। कॉन्वॉल्यूशन, नॉर्मलाइज़ेशन, अटेंशन, और रिकर्रेंट पुन: उपयोग समान ग्राफ़ सिद्धांत का पालन करते हैं लेकिन सही टेंसर आकार, ब्रॉडकास्टिंग, मास्किंग, और पैरामीटर शेयरिंग की आवश्यकता होती है। फ्रेमवर्क बैकवर्ड के बाद सहेजे गए एक्टिवेशन को तब तक मुक्त कर देते हैं जब तक कि उन्हें रखे न जाए, इसलिए मेमोरी अक्सर बैच, गहराई और सीक्वेंस लंबाई के साथ बढ़ती है।
ग्रेडिएंट विफलताएँ, सत्यापन, और इंजीनियरिंग प्रैक्टिस
कई अवकलजों का गुणन वैनिश या एक्स्प्लोड हो सकता है। ReLU‑समान एक्टिवेशन, सावधान इनिशियलाइज़ेशन, नॉर्मलाइज़ेशन, रेजिडुअल कनेक्शन, गेटिंग, और ग्रेडिएंट क्लिपिंग विभिन्न तंत्रों को संबोधित करते हैं। सैचुरेटेड एक्टिवेशन और नॉन‑डिफ़रेंशिएबल ऑपरेशन्स उपयोगी संकेतों को ब्लॉक कर सकते हैं; ट्रंकेटेड बैकप्रोपेगेशन सीक्वेंस इतिहास को सीमित करता है; मिश्रित प्रिसिशन बिना लॉस स्केलिंग के अंडरफ़्लो कर सकता है। एक्स्प्लोडिंग ग्रेडिएंट्स एक लक्षण हैं, इसलिए क्लिपिंग को लर्निंग रेट, डेटा, आर्किटेक्चर, और संख्यात्मक त्रुटियों की जाँच के साथ किया जाना चाहिए, न कि उन्हें छिपाने के लिए।
कस्टम ऑपरेशनों को छोटे डबल‑प्रिसिशन इनपुट पर फ़ाइनाइट‑डिफरेंस ग्रेडिएंट चेक से सत्यापित करें, नॉन‑डिफ़रेंशिएबल बिंदुओं से बचें। ग्रेडिएंट नॉर्म, NaN, निष्क्रिय पैरामीटर, और क्या ग्रेडिएंट अपेक्षित मॉड्यूल तक पहुँच रहे हैं, की जाँच करें। ड्रॉपआउट और नॉर्मलाइज़ेशन के लिए प्रशिक्षण और मूल्यांकन व्यवहार को स्पष्ट रूप से अलग रखें और ग्रेडिएंट्स को जानबूझकर साफ़ करें। चेकपॉइंटिंग मेमोरी बचाने के लिए एक्टिवेशन को पुनः गणना करता है; वितरित प्रशिक्षण को ग्रेडिएंट्स को सुसंगत रूप से एग्रीगेट करना चाहिए। घटता हुआ प्रशिक्षण लॉस दर्शाता है कि अनुकूलन पथ मौजूद है, न कि ग्रेडिएंट अवधारणात्मक रूप से सही हैं, डेटा लीक‑फ़्री है, या मॉडल सामान्यीकृत करता है।
व्यावहारिक उदाहरण: एक कस्टम न्यूरल लेयर का सत्यापन
एक इंजीनियर ऑडियो नेटवर्क के लिए एक डिफ़रेंशिएबल स्पेक्ट्रल लेयर लागू करता है। एक छोटा डबल‑प्रिसिशन टेस्ट ऑटोमैटिक ग्रेडिएंट को इनपुट और पैरामीटरों के बीच केंद्रीय फ़ाइनाइट डिफरेंस के साथ तुलना करता है, उन बिंदुओं को छोड़कर जहाँ ऑपरेशन जानबूझकर नॉन‑डिफ़रेंशिएबल है। आकार, ब्रॉडकास्टिंग, पैडिंग, और कॉम्प्लेक्स‑टू‑रियल रूपांतरण के लिए अलग‑अलग केस होते हैं। टेस्ट तब ग्रेडिएंट्स को इकट्ठा करता है जब पैरामीटर पुन: उपयोग होता है और पुष्टि करता है कि मास्क्ड ऑडियो फ्रेम कोई ग्रेडिएंट उत्पन्न नहीं करते।
प्रशिक्षण के दौरान, डैशबोर्ड ग्रेडिएंट और एक्टिवेशन नॉर्म, NaN, निष्क्रिय पैरामीटर, और लॉस स्केलिंग को ट्रैक करता है। जानबूझकर भ्रष्ट बैच यह पुष्टि करता है कि वैलिडेशन ऑप्टिमाइज़र अपडेट से पहले गैर‑फ़ाइनाइट आउटपुट को पकड़ लेता है। मिश्रित‑प्रिसिशन और निर्यातित इम्प्लीमेंटेशन को रेफ़रेंस के साथ तुलना किया जाता है। चेकपॉइंट रीसम टेस्ट में ऑप्टिमाइज़र स्टेट और रैंडम ऑर्डर शामिल होते हैं। लेयर केवल कुल लॉस घटने के कारण स्वीकार नहीं की जाती; यूनिट ग्रेडिएंट, संख्यात्मक स्थिरता, और डाउनस्ट्रीम जनरलाइज़ेशन को सभी सुसंगत साक्ष्य प्रदान करने चाहिए।
इम्प्लीमेंटेशन साक्ष्य और ऑपरेशनल रेडीनेस
एक प्रोडक्शन निर्णय सफल डेमॉन्स्ट्रेशन से अधिक की माँग करता है। इरादे वाले उपयोगकर्ता, ऑपरेटिंग वातावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादनीय बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपलब्ध इनपुट, वितरण शिफ्ट, निर्भरता आउटेज, दुरुपयोग, और सबसे अधिक अनदेखी किए जाने वाले समूहों या वातावरणों का परीक्षण करें। कार्य की गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, एक्सेसिबिलिटी, प्राइवेसी, और सुरक्षा के साथ मापें। प्रत्येक ट्रांसफ़ॉर्मेशन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को दोहरा सके और आकर्षक प्रोटोटाइप से साक्ष्य को अलग कर सके।
लॉन्च से पहले रिलीज़, अपवाद, परिवर्तन, रोलबैक, और रिटायरमेंट के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट, सुरक्षित फ़ॉलबैक को संरक्षित रखें, और जानबूझकर इंजेक्टेड विफलताओं के साथ मॉनिटरिंग को सत्यापित करें। ऑपरेशनल टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑विश्व साक्ष्य की समीक्षा करें, न कि यह मानें कि ऑफ़लाइन प्रदर्शन बना रहेगा। डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीति, हार्डवेयर, या लक्ष्य बदलने पर पुनर्मूल्यांकन करें। एक बनाए रखा सिस्टम दस्तावेज़ित रिकवरी, घटना सीख, डिलीशन और रिटेंशन प्रक्रियाएँ, और स्पष्ट बिंदु चाहिए जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या बैकप्रोपेगेशन वज़न को अपडेट करता है?
Backpropagation ग्रेडिएंट्स की गणना करता है। ऑप्टिमाइज़र उन ग्रेडिएंट्स, उसकी लर्निंग रेट, और संभवतः मोमेंटम या एडैप्टिव मोमेंट्स जैसी स्थिति का उपयोग करके अपडेट लागू करता है।
क्या बैकप्रोपेगेशन जैविक रूप से यथार्थवादी है?
मानक बैकप्रोपेगेशन एक इंजीनियरिंग एल्गोरिद्म है और इसे जैविक मस्तिष्क में सीखने के विस्तृत मॉडल के रूप में स्वीकार नहीं किया जाता। ऐतिहासिक न्यूरल समानता को जैविक समकक्षता के रूप में नहीं माना जाना चाहिए।
प्राथमिक संदर्भ












