
एआई की मूल बातें
डेटा विज्ञान क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
डेटा विज्ञान वह अभ्यास है जिसमें डेटा को प्रमाणित ज्ञान, भविष्यवाणियों या निर्णयों में परिवर्तित किया जाता है। यह डोमेन विशेषज्ञता, सांख्यिकी, कंप्यूटिंग, डेटा इंजीनियरिंग, दृश्यांकन और संचार को मिलाता है। मॉडल काम का हिस्सा हो सकता है, लेकिन यह discipline मॉडलिंग से पहले शुरू होती है और तैनाती के बाद भी जारी रहती है।
सबसे महत्वपूर्ण प्रश्न यह नहीं है कि “कौन सा एल्गोरिदम उपयोग करें?” बल्कि यह है कि “हम किस निर्णय का समर्थन कर रहे हैं, कौन सा प्रमाण इसे उत्तर देगा, और हम कैसे जानेंगे कि परिणाम उपयोगी बना रहे?”
मुख्य बिंदु
- डेटा विज्ञान एक अंत‑से‑अंत प्रमाण कार्यप्रवाह है, न कि मशीन लर्निंग का समानार्थी शब्द।
- समस्या परिभाषा, माप और डेटा गवर्नेंस अक्सर मॉडल जटिलता से अधिक सफलता निर्धारित करते हैं।
- पूर्वानुमानात्मक और कारणात्मक प्रश्नों के लिए अलग-अलग धारणाएँ और मूल्यांकन डिज़ाइन आवश्यक होते हैं।
- तैनात विश्लेषण को उसके उपयोगकर्ताओं के अनुसार मॉनिटरिंग, दस्तावेज़ीकरण और संचार की आवश्यकता होती है।
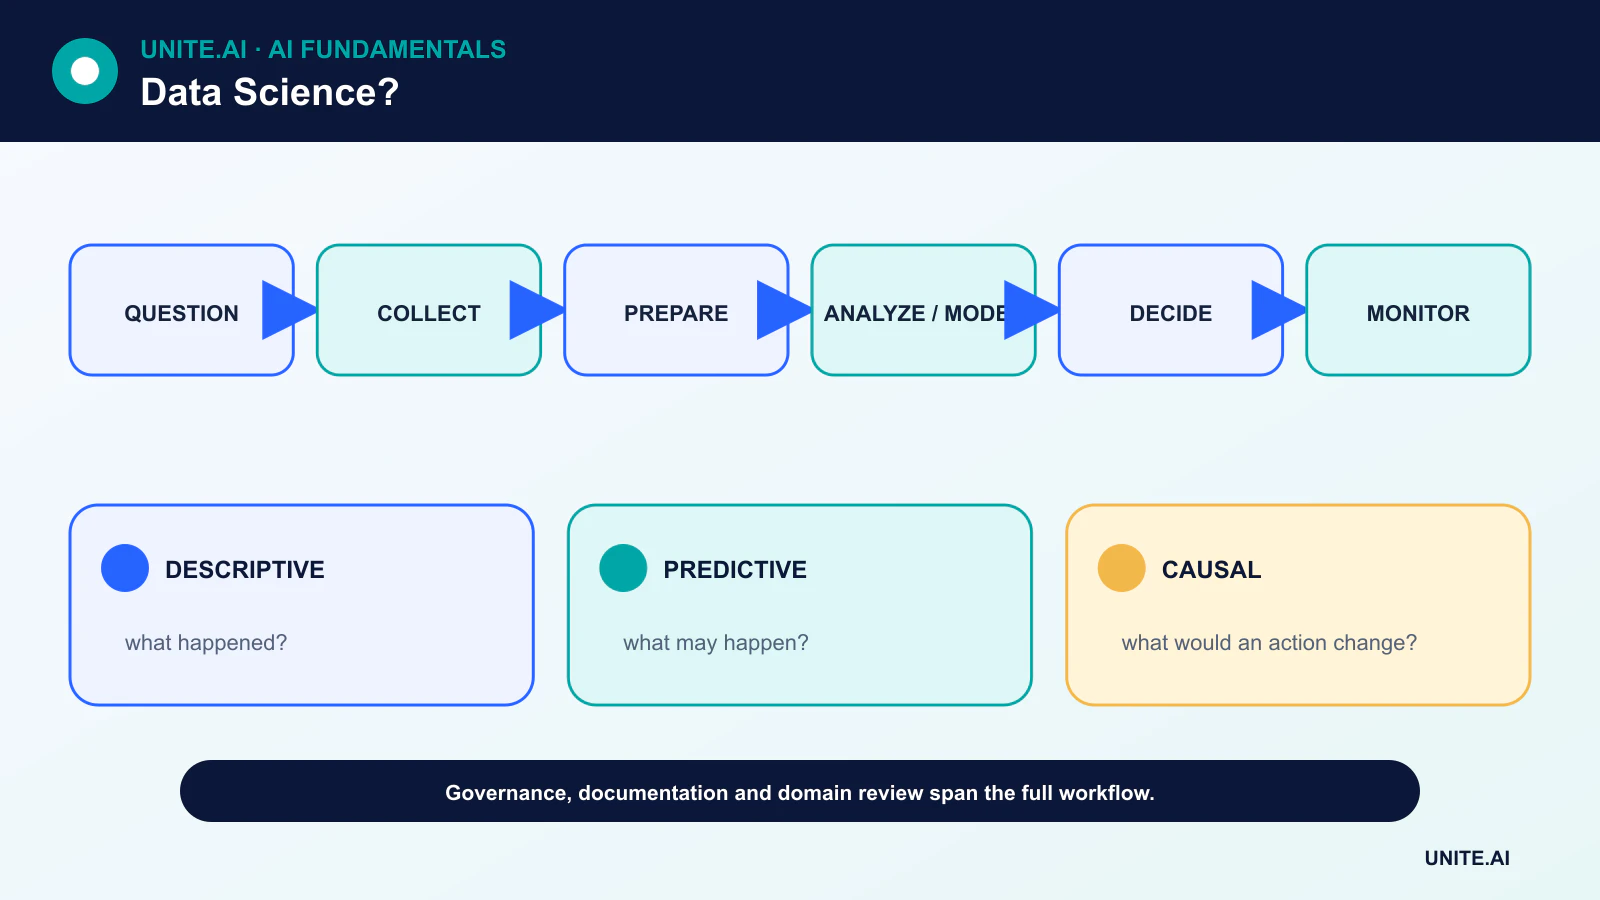
निर्णय और अनुमानक के साथ शुरू करें
किसी प्रोजेक्ट को उपयोगकर्ता, निर्णय, हस्तक्षेप और त्रुटि की लागत को पहचानना चाहिए। वर्णनात्मक प्रश्न के लिए लक्ष्य दर या प्रवृत्ति हो सकता है। भविष्यवाणी के लिए यह भविष्य की मांग या जोखिम हो सकता है। कारणात्मक प्रश्न के लिए, अनुमानक परिभाषित हस्तक्षेप के प्रभाव को निर्दिष्ट धारणाओं के तहत दर्शाता है।
“इनसाइट्स खोजें” जैसी अस्पष्ट लक्ष्य मूल्यांकन को असंभव बना देती हैं। एक मापनीय उद्देश्य डेटा संग्रह के लिए सीमा बनाता है और विश्लेषण को हर उपलब्ध फ़ील्ड में फैलने से रोकता है।
डेटा एकत्र करें, गवर्न करें और समझें
टीमें स्रोत, स्वामित्व, सहमति, रखरखाव, वंशावली और पहुँच का इन्वेंटरी बनाती हैं। वे संरचित और असंरचित डेटा में अंतर करती हैं, इकाइयों और टाइमस्टैम्प को परिभाषित करती हैं, और यह जांचती हैं कि रिकॉर्ड लक्षित जनसंख्या और समय अवधि का प्रतिनिधित्व करते हैं या नहीं।
साफ़ करना केवल अनुपलब्ध पंक्तियों को हटाना नहीं है। इसमें डुप्लिकेट, असंभव मान, लेबल अस्पष्टता, स्कीमा ड्रिफ्ट, सेंसरिंग और ऐसे जॉइन शामिल हैं जो विश्लेषण इकाई को बदल देते हैं। प्रत्येक परिवर्तन को पुनरुत्पादक और दस्तावेज़ीकृत होना चाहिए।
मॉडलिंग से पहले अन्वेषण करें
अन्वेषणात्मक विश्लेषण वितरण, अनुपलब्धता, संबंध और संभावित माप त्रुटियों का अध्ययन करता है। दृश्यांकन आउट्लायर और उपसमूह अंतर को उजागर कर सकता है जो औसत सारांश छिपा देता है। अन्वेषण को परिकल्पनाओं को सूचित करना चाहिए, न कि पुष्टि प्रमाण के रूप में ग़लत समझा जाना चाहिए।
फ़ीचर इंजीनियरिंग, आयामी घटाव और प्रतिनिधित्व शिक्षण मॉडलिंग को बेहतर बना सकते हैं, लेकिन परिवर्तन केवल प्रशिक्षण डेटा पर फ़िट किए जाने चाहिए ताकि लीकेज से बचा जा सके।
प्रश्न के अनुसार विधियों का चयन करें
सांख्यिकीय अनुमान रुचि के मात्राओं के आसपास अनिश्चितता को मापता है। मशीन लर्निंग तब उपयोगी होती है जब प्राथमिक लक्ष्य नए डेटा पर भविष्यवाणी प्रदर्शन हो। प्रयोग और कारणात्मक निष्कर्ष विधियों की आवश्यकता तब होती है जब लक्ष्य हस्तक्षेप प्रभाव का अनुमान लगाना हो।
एक बेसलाइन इतना सरल होना चाहिए कि समझा जा सके। अधिक जटिल मॉडलों को अपने अतिरिक्त लागत को बेहतर होल्ड‑आउट प्रदर्शन, कैलिब्रेटेड अनिश्चितता, परिचालन मूल्य या छवि या भाषा प्रोसेसिंग जैसी आवश्यक क्षमता के माध्यम से सिद्ध करना चाहिए।
मूल्यांकन, संचार और मॉनिटरिंग
मूल्यांकन को निर्णय के अनुरूप होना चाहिए। एक वर्गीकरणकर्ता को केवल सटीकता के बजाय प्रिसीजन, रीकॉल, कैलिब्रेशन और उपसमूह विश्लेषण की आवश्यकता हो सकती है; एक पूर्वानुमान प्रणाली को समय‑सचेत बैकटेस्टिंग चाहिए। ओवरफ़िटिंग और लीकेज प्रक्रिया विफलताएँ हैं, न कि केवल मॉडल गुणधर्म।
संचार में धारणाएँ, अनिश्चितता, सीमाएँ और अनुशंसित कार्य शामिल होते हैं। एक बार मॉडल या डैशबोर्ड उपयोग में आ जाए, टीमें इनपुट गुणवत्ता, आउटपुट ड्रिफ्ट, उपयोगकर्ता व्यवहार और डाउनस्ट्रीम प्रभाव की निगरानी करती हैं। एक समाप्त निर्णय प्रक्रिया को एक संग्रह और स्पष्ट स्वामित्व की आवश्यकता होती है, जैसे तैनात प्रक्रिया को एक ऑपरेटर की आवश्यकता होती है।
डेटा‑साइंस जीवनचक्र और विश्लेषणात्मक प्रश्न
डेटा साइंस डोमेन ज्ञान, सांख्यिकी, कंप्यूटिंग और संचार को मिलाकर डेटा को निर्णयों के लिए प्रमाण में बदलता है। वर्णन, निदान, भविष्यवाणी और कारणात्मक निष्कर्ष को अलग‑अलग पहचानें। एक डैशबोर्ड जो क्या हुआ दिखाता है, एक मॉडल जो भविष्यवाणी करता है कौन छोड़ देगा, और एक प्रयोग जो अनुमान लगाता है क्या हस्तक्षेप छोड़ने को बदलता है, ये सभी अलग प्रश्नों के उत्तर देते हैं। डेटा निकालने से पहले इकाई, जनसंख्या, समय विंडो, परिणाम, कार्रवाई और त्रुटि लागत को परिभाषित करें। कई विफल प्रोजेक्ट केवल एक मापनीय प्रॉक्सी को हल करते हैं जो इच्छित निर्णय का समर्थन नहीं कर सकता।
अधिग्रहण को स्रोत, अनुमतियाँ, सैंपलिंग डिज़ाइन और डेटा अनुबंध की आवश्यकता होती है। अन्वेषण वितरण, अनुपलब्धता, डुप्लिकेट, आउट्लायर, संबंध, माप परिवर्तन और संभावित लीकेज की जाँच करता है। सफ़ाई विकल्प विश्लेषणात्मक धारणाएँ हैं: अनुपलब्ध पंक्तियों को हटाना, मानों का इम्प्यूटेशन या आउट्लायर को सीमित करना जनसंख्या और निष्कर्ष को बदल सकता है। कच्चे डेटा को अपरिवर्तनीय रूप से संस्करणित करें और परिवर्तन को कोड के रूप में रखें, तथा इकाइयों और अर्थ के साथ एक डेटा शब्दकोश बनाएं। परिवर्तन सीखने या बार‑बार परिकल्पना परीक्षण से पहले मूल्यांकन डेटा को विभाजित करें।
मॉडलिंग, निष्कर्ष और पुनरुत्पादनशीलता
सांख्यिकीय निष्कर्ष धारणाओं के तहत अनिश्चितता को मापता है; भविष्यवाणी मॉडल आउट‑ऑफ़‑सैंपल प्रदर्शन का अनुमान लगाते हैं; कारणात्मक विश्लेषण को डिज़ाइन या प्रमाणित धारणाओं के माध्यम से पहचान की आवश्यकता होती है। प्रश्न और डेटा‑उत्पन्न प्रक्रिया से मेल खाने वाली विधियों का चयन करें। सरल बेसलाइन के साथ तुलना करें, समूहित या समय‑सचेत वैधता का उपयोग करें, और अनिश्चितता व संवेदनशीलता रिपोर्ट करें। उच्च सहसंबंध या फ़ीचर महत्व कारणता स्थापित नहीं करता। कई परीक्षण, शोधकर्ता की स्वतंत्रता और चयनात्मक रिपोर्टिंग प्रभावी पैटर्न बना सकते हैं, इसलिए प्री‑रजिस्ट्रेशन या स्पष्ट रूप से अलग‑अलग पुष्टि चरण मददगार होते हैं।
पुनरुत्पादनशीलता में कोड, पर्यावरण, डेटा स्नैपशॉट, रैंडम सीड, क्वेरी परिभाषाएँ और मैन्युअल निर्णयों का रिकॉर्ड शामिल है। स्वचालित परीक्षणों को स्कीमा, व्यावसायिक स्थिरता, परिवर्तन और मीट्रिक को कवर करना चाहिए। नोटबुक अन्वेषण के लिए मूल्यवान हैं, पर उत्पादन कार्य को मॉड्यूलर, समीक्षात्मक पाइपलाइन की आवश्यकता होती है। सहकर्मी समीक्षा को धारणाओं, लीकेज, लक्ष्य वैधता और परिणामों के सामान्यीकरण को चुनौती देनी चाहिए। प्रभाव आकार, अनिश्चितता, सीमाएँ और विरोधी प्रमाण को संप्रेषित करें, न कि केवल सांख्यिकीय महत्व या मॉडल स्कोर को।
तैनाती और निर्णय प्रभाव
यदि विश्लेषण एक आवर्ती प्रक्रिया को चलाता है, तो स्वामियों को नियुक्त करें, डेटा ताज़गी और परिणाम गुणवत्ता की निगरानी करें, और रोल‑बैक या रिटायरमेंट को परिभाषित करें। व्यक्तिगत और गोपनीय जानकारी को न्यूनतमकरण, पहुँच नियंत्रण, रखरखाव और सुरक्षित आउटपुट द्वारा सुरक्षित रखें। उपसमूह प्रभावों और उपयोगकर्ता मॉडल प्रतिक्रिया को मूल्यांकित करें; फीडबैक लूप भविष्य के डेटा को बदल सकते हैं। मापें कि निर्णय ने वास्तविक लक्ष्य को सुधारा या नहीं, केवल यह नहीं कि मॉडल तैनात हुआ। डेटा साइंस सफल तब होता है जब प्रमाण कार्रवाई को विश्वसनीय और पारदर्शी रूप से बदलता है—न कि जब कोई संगठन डैशबोर्ड, फीचर या प्रयोग को स्वामित्व के बिना जमा करता है।
व्यावहारिक उदाहरण: प्रतिधारण हस्तक्षेप का माप
एक प्रोडक्ट टीम कम प्रतिधारण देखती है और सक्रिय उपयोगकर्ता, कोहोर्ट, विंडो, बहिष्करण और निर्णय को परिभाषित करती है। विश्लेषक मॉडलिंग से पहले इन्स्ट्रूमेंटेशन, अनुपलब्ध घटनाओं और अधिग्रहण मिश्रण का ऑडिट करते हैं। वर्णनात्मक कोहोर्ट यह पहचानते हैं कि गिरावट कहाँ हो रही है, एक भविष्यवाणी मॉडल शोध प्रतिभागियों को प्राथमिकता देता है, और एक यादृच्छिक ऑन‑बोर्डिंग प्रयोग अनुमान लगाता है कि प्रस्तावित परिवर्तन प्रतिधारण में सुधार करता है या नहीं। ये तीन अलग‑अलग विश्लेषण हैं जिनके अलग‑अलग धारणाएँ और आउटपुट हैं।
नोटबुक, क्वेरी, डेटा स्नैपशॉट, मीट्रिक परिभाषा और प्रयोग योजना को संस्करणित और सहकर्मी‑समीक्षित किया जाता है। परिणाम प्रभाव आकार और अनिश्चितता को रिपोर्ट करते हैं, साथ ही समर्थन मांग और पहुँच के लिए गार्डरेल्स रखते हैं। एक डैशबोर्ड प्रयोग की निगरानी करता है लेकिन पूर्वनिर्धारित विश्लेषण का विकल्प नहीं बनता। यदि हस्तक्षेप सफल हो जाता है, तो रोल‑आउट चरणबद्ध रहता है और दीर्घकालिक व्यवहार की जाँच करता है। कार्य को केवल इस आधार पर मूल्यवान माना जाता है कि वह पुनरुत्पादक निर्णय का समर्थन करता है, न कि जटिल मॉडल या दृश्य रूप से आकर्षक चार्ट के कारण।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय केवल सफल प्रदर्शनी से अधिक की आवश्यकता रखता है। इरादा उपयोगकर्ता, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताएँ, स्वामी और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादक बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा शर्तों, ख़राब या अनुपलब्ध इनपुट, वितरण शिफ्ट, निर्भरता आउटेज, दुरुपयोग और सबसे अधिक उपेक्षित समूह या वातावरण का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, विलंब, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि स्वतंत्र समीक्षक परिणाम को पुनरुत्पादित कर सके और प्रमाण को आकर्षक प्रोटोटाइप से अलग कर सके।
लॉन्च से पहले रिलीज, अपवाद, परिवर्तन, रोल‑बैक और रिटायरमेंट के अधिकार को सौंपें। चरणबद्ध रोल‑आउट उपयोग करें, एक सुरक्षित फॉलबैक रखें, और जानबूझकर डाले गए विफलताओं के साथ मॉनिटरिंग सत्यापित करें। परिचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानवीय ओवरराइड और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया स्वामी को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, न कि यह मान कर कि ऑफ़लाइन प्रदर्शन बना रहेगा। डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीति, हार्डवेयर या लक्ष्य बदलते ही पुनर्मूल्यांकन करें। एक रखरखावित सिस्टम को भी दस्तावेज़ीकृत पुनर्प्राप्ति, घटना सीखना, हटाना और रखरखाव प्रक्रियाएँ, और एक स्पष्ट बिंदु चाहिए जहाँ इसे निष्क्रिय या बदलना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या डेटा विज्ञान डेटा एनालिटिक्स के समान है?
शब्दों में ओवरलैप है। डेटा विज्ञान अक्सर डेटा उत्पाद और भविष्यवाणी प्रणाली बनाने को शामिल करता है, जबकि एनालिटिक्स अधिक वर्णनात्मक और निदानात्मक निर्णय समर्थन पर केंद्रित हो सकता है। संगठनात्मक उपयोग अलग‑अलग हो सकता है।
क्या हर डेटा‑साइंस प्रोजेक्ट को एआई की जरूरत होती है?
नहीं। एक अच्छी तरह से डिज़ाइन किया गया क्वेरी, चार्ट, प्रयोग या सांख्यिकीय अनुमान एक जटिल मॉडल से अधिक उपयोगी और भरोसेमंद हो सकता है।
प्राथमिक संदर्भ











