
एआई की मूल बातें
मानव प्रतिक्रिया से सुदृढीकरण सीखना (RLHF) क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
मानव प्रतिक्रिया से सुदृढीकरण सीखना (RLHF) उन विधियों का एक समूह है जो मानव निर्णयों का उपयोग करके मॉडल को अनुकूलित करने में मदद करता है, जब वांछित व्यवहार को एक साधारण स्वचालित पुरस्कार से निर्दिष्ट करना कठिन होता है। भाषा मॉडल के लिए, लोग आमतौर पर उम्मीदवार प्रतिक्रियाओं की तुलना करते हैं और एक सीखा हुआ प्राथमिकता मॉडल उन तुलनाओं को प्रशिक्षण संकेत में बदल देता है।
RLHF एक पूर्व-प्रशिक्षित मॉडल को अधिक सहायक या लिखित नीति के साथ बेहतर मेल खाने वाला बना सकता है, लेकिन यह हर उपयोगकर्ता के साथ सत्यता या संरेखण की गारंटी नहीं देता। परिणाम इस बात पर निर्भर करता है कि प्रतिक्रिया कौन प्रदान करता है, प्रॉम्प्ट कैसे नमूना किए जाते हैं, पुरस्कार मॉडल क्या दर्शा सकता है, और अनुकूलन कैसे सीमित किया जाता है।
मुख्य बिंदु
- RLHF आमतौर पर पूर्व-प्रशिक्षण और पर्यवेक्षित निर्देश ट्यूनिंग के बाद आता है।
- युग्मात्मक प्राथमिकताएँ एक पुरस्कार या प्राथमिकता मॉडल को प्रशिक्षित करती हैं; नीति अनुकूलन तब उच्च स्कोर वाले आउटपुट को प्राथमिकता देता है।
- पुरस्कार हैकिंग, मूल्यांकनकर्ता असहमति, वितरण परिवर्तन, और अतिअनुकूलन अभी भी महत्वपूर्ण जोखिम बने हुए हैं।
- अंतिम नीति का सीधे कार्य की गुणवत्ता, सुरक्षा, कैलिब्रेशन, और उपसमूह प्रभावों के लिए मूल्यांकन करें।
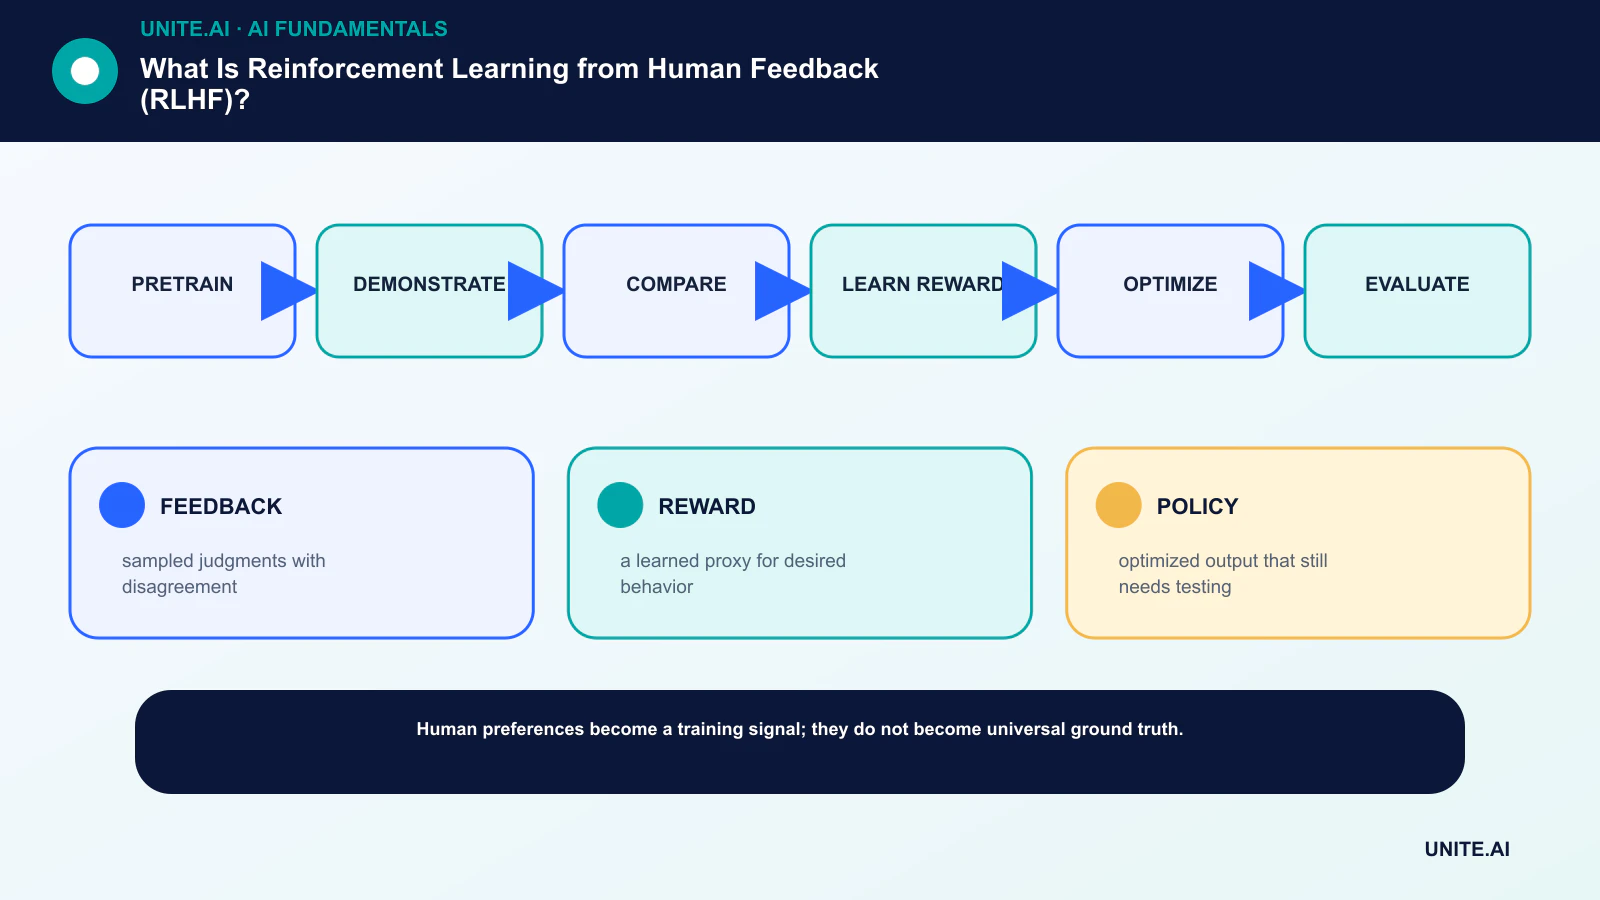
सामान्य RLHF पाइपलाइन
एक भाषा मॉडल पहले पूर्व-प्रशिक्षण के माध्यम से व्यापक सांख्यिकीय संरचना सीखता है। उसके बाद पर्यवेक्षित फाइन-ट्यूनिंग वांछित प्रतिक्रियाओं के उदाहरणों का उपयोग करती है। प्राथमिकता संग्रह के लिए, मूल्यांकनकर्ता समान प्रॉम्प्ट के आउटपुट को क्रमबद्ध या चुनते हैं।
एक पुरस्कार मॉडल इन तुलनाओं की भविष्यवाणी करना सीखता है। PPO जैसी सुदृढीकरण-सीख एल्गोरिदम सीखे हुए पुरस्कार के विरुद्ध भाषा मॉडल को अनुकूलित कर सकती है, जबकि एक दंड इसे संदर्भ नीति से बहुत अधिक भटकने से रोकता है।
प्रतिक्रिया माप है, न कि वास्तविक सत्य
निर्देश अस्पष्ट होने, विशेषज्ञता में अंतर या मूल्यों के वास्तविक टकराव के कारण मूल्यांकनकर्ता असहमत हो सकते हैं। स्थिति, शब्दावली, आत्मविश्वास और शैली प्राथमिकताओं को पक्षपाती बना सकते हैं। एक उच्च-गुणवत्ता वाला कार्यक्रम मूल्यांककों को प्रशिक्षित करता है, सहमति को मापता है, उदाहरणों का ऑडिट करता है, और अनिश्चितता को बरकरार रखता है।
नमूना लेना भी महत्वपूर्ण है। यदि प्राथमिकता सेट में कठिन भाषाएँ, डोमेन्स, या हानियां शामिल नहीं हैं, तो पुरस्कार मॉडल उन्हें विश्वसनीय रूप से पर्यवेक्षण नहीं कर सकता। डेटा-साइंस अनुशासन ऑप्टिमाइज़र जितना ही महत्वपूर्ण है।
विफलता मोड
नीति सीखे हुए पुरस्कार की कमजोरियों का फायदा उठा सकती है, ऐसे आउटपुट उत्पन्न कर सकती है जो उच्च अंक प्राप्त करते हैं लेकिन मूल इरादे को पूरा नहीं करते। अत्यधिक अनुकूलन विविधता को घटा सकता है, पसंदीदा शैली को बढ़ा सकता है, या मॉडल को आत्मविश्वासपूर्वक सहमत बना सकता है।
पुरस्कार मॉडल स्वयं अपने प्रशिक्षण वितरण के बाहर विफल हो सकता है। टीमों को एकत्रित प्राथमिकता जीत दर पर निर्भर रहने के बजाय प्रतिकूल प्रॉम्प्ट, तथ्यात्मक कार्य, अस्वीकार सीमा, कैलिब्रेशन, और विभिन्न अनुकूलन शक्ति पर व्यवहार का परीक्षण करना चाहिए।
विकल्प और पूरक
डायरेक्ट प्रेफ़रेंस ऑप्टिमाइज़ेशन प्राथमिकता जोड़ों से सीखता है बिना ऑनलाइन सुदृढीकरण-सीख लूप के माध्यम से अलग नीति को फिट किए। रिजेक्शन सैंपलिंग, पर्यवेक्षित प्राथमिकता फाइन-ट्यूनिंग, नियम-आधारित प्रतिक्रिया, और प्रक्रिया पर्यवेक्षण अन्य समझौते प्रदान करते हैं।
कोई भी विधि प्रॉम्प्ट, पुनः प्राप्ति, टूल, और एप्लिकेशन-स्तरीय नियंत्रणों की आवश्यकता को नहीं हटाती। पोस्ट-ट्रेनिंग व्यवहार को आकार देती है; तैनात सिस्टमों को अभी भी ठोस प्रमाण, अनुमतियों, निगरानी, और मानव एस्केलेशन की आवश्यकता होती है।
प्राथमिकता मॉडल कैसे प्रशिक्षित होते हैं
एक प्रॉम्प्ट x और दो प्रतिक्रियाएँ y₁ तथा y₂ के लिए, प्राथमिकता मॉडल स्केलर स्कोर असाइन करता है और इस प्रकार प्रशिक्षित किया जाता है कि पसंदीदा प्रतिक्रिया को उच्च स्कोर मिले। एक सामान्य हानि इस संभावना पर आधारित होती है कि एक स्कोर दूसरे से अधिक हो। यह कई युग्मात्मक निर्णयों को ऐसी फ़ंक्शन में बदल देता है जो नई उत्पन्न आउटपुट को स्कोर कर सके।
मॉडल उन संकेतों को सीखता है जो एकत्रित चयन की भविष्यवाणी करते हैं। यदि मूल्यांकक आत्मविश्वासी लेखन, लंबी उत्तर, विशिष्ट सांस्कृतिक मानदंड, या परिचित दृष्टिकोण को पसंद करते हैं, तो ये संबंध पुरस्कार विशेषताओं बन सकते हैं। संतुलित निर्देश, प्रतिलोम उदाहरण, विशेषज्ञ समीक्षा, और सतही प्राथमिकताओं के ऑडिट समस्या को घटाते हैं लेकिन पूरी तरह समाप्त नहीं करते।
प्राथमिकता डेटा में टाई, रैंकिंग, समीक्षाएँ, स्केलर लेबल, या डेमॉन्स्ट्रेशन शामिल हो सकते हैं। जोड़ी चयन महत्वपूर्ण है: स्पष्ट रूप से अलग उत्तरों के बीच तुलना सूक्ष्म गुणवत्ता सीमाओं के बारे में कम सिखाती है, जबकि केवल कठिन जोड़े प्रशिक्षण को अस्थिर बना सकते हैं। सक्रिय सैंपलिंग सूचनात्मक असहमति को लक्षित कर सकता है लेकिन डेटा वितरण को बदल सकता है।
नीति अनुकूलन और नियमितीकरण
PPO-आधारित RLHF वर्तमान नीति से प्रतिक्रियाएँ सैंपल करता है, उन्हें पुरस्कार मॉडल से स्कोर देता है, और अपेक्षित पुरस्कार बढ़ाने के लिए नीति को अपडेट करता है। कुल्बैक–लेबलर दंड या संबंधित प्रतिबंध नीति को पर्यवेक्षित संदर्भ के निकट रखता है, विनाशकारी ड्रिफ्ट को सीमित करता है और संकीर्ण पुरस्कार-मॉडल कमजोरियों के शोषण को हतोत्साहित करता है।
अनुकूलन शक्ति एक उत्पाद विकल्प है। बहुत कम होने पर वांछित व्यवहार अपरिवर्तित रहता है; बहुत अधिक होने पर पुरस्कार हैकिंग, दोहरावदार वाक्यांश, चापलूसी, या विविधता में कमी हो सकती है। केवल पुरस्कार के आधार पर चेकपॉइंट चुनने के बजाय प्रशिक्षण के दौरान गुणवत्ता और सुरक्षा मीट्रिक को पुरस्कार और विचलन के विरुद्ध प्लॉट करें।
डायरेक्ट प्रेफ़रेंस विधियाँ प्राथमिकता जोड़ों और एक संदर्भ मॉडल से उद्देश्य निकालती हैं बिना स्पष्ट ऑनलाइन RL लूप के। वे प्रशिक्षण को सरल बना सकती हैं, लेकिन फिर भी प्राथमिकता गुणवत्ता, कवरेज, और संदर्भ-नीति धारणाओं को विरासत में लेती हैं। संवैधानिक या AI-जनित प्रतिक्रिया लेबल प्रदान करने वाले को बदलती है; यह मानों और विफलताओं को लोगों के साथ सत्यापित करने की आवश्यकता नहीं हटाती।
मूल्यांकन और डेटा शासन
ब्लाइंड तुलना, कार्य-विशिष्ट परीक्षण, प्रतिकूल प्रॉम्प्ट, तथ्यता जांच, अस्वीकार की प्रिसीजन और रिकॉल, और उपसमूह समीक्षा का उपयोग करें। संभव हो तो मूल्यांकनकर्ताओं को प्रशिक्षण डेटा से अलग रखें। पुराने मॉडल के खिलाफ जीत दर दोनों उम्मीदवारों के खराब होने पर निरपेक्ष विफलताओं को छिपा सकती है।
मूल्यांकक भर्ती, मुआवजा, विशेषज्ञता, भौगोलिक स्थान, भाषा, निर्देश, हानिकारक सामग्री के संपर्क, असहमति, मध्यस्थता, और गुणवत्ता नियंत्रण का दस्तावेज़ीकरण करें। प्रतिक्रिया कार्य में मनोवैज्ञानिक जोखिम हो सकता है, और जिम्मेदार डेटा संचालन में कार्यकर्ता समर्थन और परेशान करने वाले कार्यों को अस्वीकार करने का अधिकार शामिल है।
तैनाती के बाद, प्राथमिकता ड्रिफ्ट और अतिसामान्यीकरण की निगरानी करें। आकस्मिक सहायता के लिए ट्यून की गई नीति चिकित्सा या कानूनी संदर्भों में बुरा व्यवहार कर सकती है। डोमेन सीमाओं, पुनः प्राप्ति, अनुमतियों, और एस्केलेशन को RLHF धारणाओं के बाहर रखें, और केवल तब पुनः प्रशिक्षण करें जब नया प्रमाण परिवर्तन को उचित ठहराता हो।
एक ठोस RLHF प्रशिक्षण और मूल्यांकन पाइपलाइन
एक सामान्य प्रोजेक्ट पूर्व-प्रशिक्षित भाषा मॉडल और एक निर्देश डेटासेट से शुरू होता है जिसका उपयोग पर्यवेक्षित फाइन-ट्यूनिंग के लिए किया जाता है। फिर मूल्यांकक लिखित रूब्रिक के तहत उम्मीदवार प्रतिक्रियाओं की तुलना करते हैं, जो शुद्धता, प्रासंगिकता, शैली, सुरक्षा, और अनिश्चितता को कवर करता है। युग्मात्मक प्राथमिकताएँ एक पुरस्कार मॉडल को प्रशिक्षित करती हैं या सीधे नीति को अनुकूलित करती हैं। सैंपलिंग में सामान्य कार्य, कठिन किनारे के मामलों, प्रतिकूल प्रॉम्प्ट, कई भाषाएँ, और वे क्षेत्र शामिल होने चाहिए जहाँ मूल्यांकक वैध रूप से असहमत होते हैं।
होल्ड‑आउट तुलना पर पुरस्कार‑मॉडल की शुद्धता आवश्यक है लेकिन पर्याप्त नहीं। अनुकूलित नीति सीखे हुए पुरस्कार में त्रुटियों का फायदा उठा सकती है, अत्यधिक शब्दाडंबर हो सकता है, हानिरहित अनुरोधों को अस्वीकार कर सकता है, या क्षमताएँ खो सकता है। प्रशिक्षण के दौरान कार्य बेंचमार्क, मानव प्राथमिकता, कैलिब्रेशन, सुरक्षा, विविधता, और संदर्भ मॉडल से विचलन को ट्रैक करें। समय‑समय पर बदलती नीति से नई तुलना एकत्र करें ताकि प्राथमिकता डेटा उन आउटपुट को कवर करे जो मॉडल वास्तव में उत्पन्न करता है।
कौन प्राथमिकताएँ प्रदान करता है, उनके निर्देश, मुआवजा, असहमति, गुणवत्ता नियंत्रण, और सांस्कृतिक या डोमेन सीमाओं का दस्तावेज़ीकरण करें। जहाँ त्रुटियों से विशिष्ट नुकसान हो सकता है, वहाँ विशेषज्ञ समीक्षक उपयोग करें। पुरस्कार मॉडल और अंतिम नीति दोनों की रेड‑टीम करें, व्यवहारिक प्रतिगमन परीक्षण बनाए रखें, और तैनाती को चरणबद्ध करें। RLHF मापी गई प्राथमिकताओं के अनुसार व्यवहार को आकार देता है; यह सत्यता की गारंटी नहीं देता, पक्षपात को समाप्त नहीं करता, या यह व्यापक समस्या का समाधान नहीं करता कि प्रत्येक संदर्भ में मॉडल को क्या करना चाहिए।
व्यावहारिक कार्यान्वयन चेकलिस्ट
धारणा को एक सीमित, परीक्षण योग्य कार्यप्रवाह में बदलें: पूर्व‑प्रशिक्षण → प्रदर्शन → तुलना → पुरस्कार सीखना → अनुकूलन → मूल्यांकन। एक उत्तरदायी मालिक को नाम दें, डेटा और निर्भरताओं का दस्तावेज़ बनाएं, एक सरल बेसलाइन स्थापित करें, स्वीकृति और रोक मानदंड निर्धारित करें, प्रतिनिधि विफलताओं का परीक्षण करें, और दायरे का विस्तार करने से पहले निगरानी, रोलबैक, और समीक्षा को परिभाषित करें। संस्करणों और धारणाओं को रिकॉर्ड करें ताकि दूसरी टीम परिणाम को दोहरा सके और समझ सके कि क्या बदला।
लॉन्च से पहले, निर्माण, संचालन, सुरक्षा, और सिस्टम से प्रभावित लोगों के साथ एक दस्तावेज़ित तत्परता समीक्षा चलाएँ। सामान्य मामलों, सीमा शर्तों, निर्भरता विफलताओं, और दुरुपयोग का परीक्षण करें; साक्ष्य और अनसुलझे जोखिमों को सुरक्षित रखें। निर्धारित करें कि रिलीज़ को कौन मंजूरी दे सकता है, थ्रेशहोल्ड बदल सकता है, आउटपुट को ओवरराइड कर सकता है, या संचालन को रोक सकता है। वास्तविक‑विश्व डेटा आने के बाद निर्णय को पुनः देखें, क्योंकि तकनीकी रूप से सफल पायलट व्यापक पैमाने पर विश्वसनीय प्रदर्शन की गारंटी नहीं देता।
- फ़ीडबैक: असहमति के साथ सैंपल किए गए निर्णय।
- रिवॉर्ड: वांछित व्यवहार के लिए सीखा हुआ प्रॉक्सी।
- पॉलिसी: अनुकूलित आउटपुट जिसे अभी परीक्षण की आवश्यकता है।
अक्सर पूछे जाने वाले प्रश्न
क्या RLHF फाइन‑ट्यूनिंग के समान है?
RLHF एक पोस्ट‑ट्रेनिंग रूप है जो प्राथमिकता‑आधारित पुरस्कारों का उपयोग करता है। पर्यवेक्षित फाइन‑ट्यूनिंग सीधे लक्ष्य आउटपुट पर प्रशिक्षण देती है; कई पाइपलाइन दोनों का उपयोग करती हैं।
क्या RLHF मॉडल को सत्य बनाता है?
यह प्रतिक्रिया प्रक्रिया द्वारा मापे गए व्यवहार को सुधार सकता है, लेकिन मॉडल अभी भी गलत, प्रभावशाली, या रणनीतिक रूप से पुरस्कार का शोषण कर सकता है। सत्यता के लिए सीधे मूल्यांकन और आधारभूत प्रमाण आवश्यक हैं।
प्राथमिक संदर्भ












