एआई की मूल बातें
NPU क्या है? न्यूरल प्रोसेसिंग यूनिट्स की व्याख्या

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
न्यूरल प्रोसेसिंग यूनिट (NPU) एक विशेष त्वरक है जिसे सामान्य न्यूरल‑नेटवर्क संचालन को कुशलता से निष्पादित करने के लिए डिज़ाइन किया गया है। फ़ोन, पीसी, वाहन, कैमरा और एम्बेडेड सिस्टम में यह समर्थित AI कार्यभार को कम ऊर्जा के साथ चला सकता है या CPU और GPU को अन्य कार्यों के लिए मुक्त कर सकता है।
NPU एक व्यापक उद्योग शब्द है न कि एक एकल सार्वभौमिक आर्किटेक्चर। प्रदर्शन समर्थित ऑपरेटरों, संख्यात्मक स्वरूपों, मेमोरी, कंपाइलर और रनटाइम, थर्मल सीमाओं, तथा अनुप्रयोग के कितने हिस्से को त्वरक पर रखा जा सकता है, इन सब पर निर्भर करता है।
मुख्य बिंदु
- NPUs मैट्रिक्स, वेक्टर और टेंसर संचालन पर उच्च डेटा पुन: उपयोग और कम ऊर्जा के साथ जोर देते हैं।
- पीक TOPS एक अंत‑से‑अंत अनुप्रयोग बेंचमार्क नहीं है और यह विशिष्ट सटीकता या विरलता मान सकता है।
- किसी मॉडल को असमर्थित संचालन के लिए रूपांतरण, क्वांटाइज़ेशन, ग्राफ विभाजन और फॉलबैक की आवश्यकता हो सकती है।
- वास्तविक कार्यभार पर लेटेंसी, थ्रूपुट, ऊर्जा, मेमोरी, गुणवत्ता, गोपनीयता और पोर्टेबिलिटी की तुलना करें।
CPU, GPU, और NPU की भूमिकाएँ
CPU सामान्य नियंत्रण प्रवाह और व्यापक संगतता में उत्कृष्ट होते हैं। GPU प्रोग्रामेबल समानांतर थ्रूपुट और बड़े सॉफ़्टवेयर इकोसिस्टम प्रदान करते हैं। NPU दोहराए जाने वाले टेंसर संचालन में विशेषज्ञ होते हैं और इसमें स्थानीय मेमोरी, मल्टिप्लाई‑एक्यूमुलेट ऐरे और अनुमान के लिए अनुकूलित डेटा‑फ़्लो शामिल हो सकता है।
विविध प्रणालियाँ विभिन्न भागों को उनकी सबसे उपयुक्त जगह पर निर्धारित करती हैं। यह एज AI के लिए महत्वपूर्ण है, जहाँ निरंतर शक्ति और प्रतिक्रिया समय पीक डेटा‑सेंटर थ्रूपुट से अधिक महत्वपूर्ण हो सकते हैं।
मॉडल संकलन और निष्पादन
एक फ़्रेमवर्क ग्राफ को मध्यवर्ती प्रतिनिधित्व में परिवर्तित किया जाता है, अनुकूलित किया जाता है, जहाँ उपयुक्त हो वहाँ क्वांटाइज़ किया जाता है, और समर्थित ऑपरेटरों के लिए संकलित किया जाता है। रनटाइम ग्राफ को विभाजित कर सकता है ताकि असमर्थित लेयर CPU या GPU पर चलें।
प्रोसेसरों के बीच स्थानांतरण त्वरक के लाभों को नष्ट कर सकते हैं। स्थिर आकार, लेआउट, सटीकता, बैचिंग और मेमोरी पुन: उपयोग प्रदर्शन को प्रभावित करते हैं। संकलित आर्टिफैक्ट का परीक्षण करें क्योंकि डीप‑लर्निंग मॉडल की गुणवत्ता रूपांतरण के बाद बदल सकती है।
TOPS और दक्षता दावों को समझें
TOPS परिभाषित मान्यताओं के तहत प्रति सेकंड ट्रिलियन संचालन की रिपोर्ट करता है। विक्रेता गुणा और जोड़ को अलग-अलग गिन सकते हैं, कम‑बिट पूर्णांक सटीकता का उपयोग कर सकते हैं, या विरलता मान सकते हैं। उच्च संख्या किसी विशेष मॉडल के लिए कम लेटेंसी की गारंटी नहीं देती।
कोल्ड और वार्म स्टार्ट, प्रति‑क्वेरी लेटेंसी, थ्रूपुट, ऊर्जा, पीक मेमोरी, थर्मल थ्रॉटलिंग, समर्थित संदर्भ या छवि आकार, और ग्राफ के तेज़ी से चलने वाले हिस्से का अनुपात मापें। समान सटीकता और सॉफ़्टवेयर संस्करणों का उपयोग करें।
डिवाइस‑पर AI के समझौते
स्थानीय निष्पादन नेटवर्क निर्भरता को कम कर सकता है और कच्चे इनपुट को डिवाइस पर रख सकता है, लेकिन डाउनलोड किए गए मॉडल, लॉग, बैकअप और क्लाउड फॉलबैक अभी भी डेटा प्रवाह बनाते हैं। सुरक्षित मॉडल डिलीवरी और प्लेटफ़ॉर्म अपडेट आवश्यक बने रहते हैं।
NPU विज़न, ऑडियो, भाषा और सेंसर अनुप्रयोगों को समर्थन दे सकते हैं, जिसमें TinyML-संबंधित कार्यभार शामिल हैं। डेवलपर्स को सहज फॉलबैक डिजाइन करना चाहिए और यह सूचित करना चाहिए कि कब प्रोसेसिंग डिवाइस से बाहर जाती है।
NPU आर्किटेक्चर और समर्थित संचालन
NPU टेंसर संचालन को मल्टिप्लाई‑एक्यूमुलेट इकाइयों, स्थानीय मेमोरी, डेटा‑फ़्लो शेड्यूलिंग और विशेष संख्यात्मक स्वरूपों की ऐरे का उपयोग करके तेज़ करता है। वज़न और सक्रियण को गणना के निकट रखना महंगे डेटा स्थानांतरण को कम करता है। वास्तविक डिवाइस ऑपरेटर समर्थन, मेमोरी पदानुक्रम, सटीकता, विरलता, प्रोग्रामेबिलिटी, और CPU व GPU के साथ कार्य साझा करने के तरीके में भिन्न होते हैं।
पीक प्रदर्शन अक्सर TOPS में विज्ञापित किया जाता है, लेकिन TOPS सटीकता, उपयोग, मेमोरी सीमाएँ, ऑपरेटर कवरेज या अंत‑से‑अंत लेटेंसी निर्दिष्ट नहीं करता। दो प्रोसेसर समान हेडलाइन संख्या के साथ भी एक ही मॉडल पर अलग प्रदर्शन कर सकते हैं। संकलित मॉडल, वास्तविक बैच और अनुक्रम आकार, प्री‑प्रोसेसिंग, स्थानांतरण और पावर मोड का बेंचमार्क करें।
NPU विज़न, स्पीच, डीनॉइज़िंग, बैकग्राउंड इफ़ेक्ट्स और कॉम्पैक्ट भाषा मॉडलों जैसे समर्थित न्यूरल कार्यभार के लिए प्रभावी होते हैं। असमर्थित ऑपरेटर CPU या GPU पर फॉलबैक हो सकते हैं, जिससे स्थानांतरण और अप्रत्याशित लेटेंसी बनती है। यह मानने के बजाय कि पूरा ग्राफ त्वरक का उपयोग करता है, कंपाइलर रिपोर्ट और रनटाइम ट्रेस की जांच करके प्लेसमेंट की पुष्टि करें।
मॉडल रूपांतरण, क्वांटाइज़ेशन और तैनाती
तैनाती आमतौर पर प्रशिक्षण फ़्रेमवर्क से निर्यात, ग्राफ अनुकूलन, क्वांटाइज़ेशन, विक्रेता संकलन और रनटाइम इंटीग्रेशन तक जाती है। स्थिर आकार और सामान्य ऑपरेटर तेज़ी से त्वरित किए जा सकते हैं। डायनेमिक कंट्रोल फ्लो, कस्टम कर्नेल, बड़े मध्यवर्ती टेंसर, और असमर्थित नॉर्मलाइज़ेशन या अटेंशन पैटर्न ग्राफ परिवर्तन या हाइब्रिड निष्पादन की आवश्यकता कर सकते हैं।
इंटीजर और निम्न‑सटीकता स्वरूप मॉडल आकार, बैंडविड्थ, ऊर्जा और लेटेंसी को कम करते हैं, लेकिन कैलिब्रेशन डेटा को वास्तविक इनपुट का प्रतिनिधित्व करना चाहिए। जब गुणवत्ता संवेदनशील हो तो पोस्ट‑ट्रेनिंग क्वांटाइज़ेशन की तुलना क्वांटाइज़ेशन‑अवेयर ट्रेनिंग से करें। प्रति‑क्लास और सबसे खराब स्थिति के व्यवहार का मूल्यांकन करें क्योंकि औसत सटीकता दुर्लभ या सुरक्षा‑संबंधी मामलों में गिरावट को छिपा सकती है।
डिवाइस‑पर इनफ़रेंस लेटेंसी, ऑफ़लाइन संचालन और गोपनीयता को डेटा ट्रांसफ़र सीमित करके सुधारता है, लेकिन डिवाइस को अभी भी सुरक्षित मॉडल, अनुमति‑सजग डेटा एक्सेस और अपडेट तंत्र की आवश्यकता होती है। जहाँ आवश्यक हो मॉडल फ़ाइलों की सुरक्षा करें, अपडेट पर हस्ताक्षर करें, क्लाउड फॉलबैक का खुलासा करें, और यह सुनिश्चित करें कि टेलीमेट्री वह गोपनीयता जोखिम न दोहराए जिसे स्थानीय आर्किटेक्चर कम करने के लिए बनाया गया था।
प्रदर्शन मूल्यांकन और सिस्टम‑स्तर के समझौते
कोल्ड‑स्टार्ट और स्थिर‑स्थिति लेटेंसी, थ्रूपुट, प्रति‑इनफ़रेंस ऊर्जा, मेमोरी, थर्मल व्यवहार, सटीकता और बैटरी प्रभाव को मापें। लंबे परीक्षण थ्रॉटलिंग को उजागर करते हैं जो छोटे बेंचमार्क नहीं दिखाते। प्री‑प्रोसेसिंग और पोस्ट‑प्रोसेसिंग को शामिल करें क्योंकि री‑साइज़िंग, टोकनाइज़ेशन, डिकोडिंग या डेटा कॉपीज़ अन्यथा तेज़ त्वरक पर हावी हो सकती हैं।
शेड्यूलिंग एक सिस्टम समस्या है। CPU अनुप्रयोग लॉजिक प्रबंधित करता है, GPU असमर्थित लेयर को रेंडर या निष्पादित कर सकता है, और NPU संगत ग्राफ चलाता है। एक साथ कैमरा, ऑडियो, डिस्प्ले और AI कार्यभार मेमोरी बैंडविड्थ और पावर के लिए प्रतिस्पर्धा करते हैं। विक्रेता टूल में अलग‑अलग मॉडल के बजाय पूर्ण उपयोगकर्ता परिदृश्य का परीक्षण करें।
कम्पाइलर और रनटाइम के बीच पोर्टेबिलिटी सीमित रहती है। जहाँ संभव हो मानक मॉडल प्रतिनिधित्व को प्राथमिकता दें, विक्रेता‑विशिष्ट कोड को इंटरफ़ेस के पीछे अलग रखें, रेफ़रेंस आउटपुट को संरक्षित रखें, और डिवाइस परीक्षण कवरेज बनाए रखें। हार्डवेयर का चयन मान्य कार्यभार, सॉफ़्टवेयर समर्थन, अपडेट क्षितिज और कुल सिस्टम लागत के आधार पर करें—एकल त्वरक विनिर्देश के आधार पर नहीं।
व्यावहारिक उदाहरण: एक विज़न मॉडल को NPU लैपटॉप पर तैनात करना
एक टीम बैकग्राउंड इफ़ेक्ट्स के लिए सेगमेंटेशन मॉडल को प्रशिक्षित करती है, इसे समर्थित इंटरचेंज फ़ॉर्मेट में निर्यात करती है, असमर्थित ऑपरेटरों को बदलती है, और प्रतिनिधि कैमरों, प्रकाश, त्वचा टोन, कपड़े और पृष्ठभूमियों के साथ इंटीजर क्वांटाइज़ेशन को कैलिब्रेट करती है। विक्रेता कंपाइलर यह रिपोर्ट करता है कि कौन से नोड NPU पर चलते हैं और कौन से फॉलबैक होते हैं। टीम किसी भी फॉलबैक को सिस्टम लागत मानती है, क्योंकि टेंसर स्थानांतरण एक तेज़ व्यक्तिगत कर्नेल को हावी कर सकते हैं।
बेंचमार्किंग वास्तविक वीडियो कॉल के दौरान कैमरा प्री‑प्रोसेसिंग, मॉडल निष्पादन, कॉम्पोज़िटिंग, मेमोरी, कोल्ड स्टार्ट, स्थिर‑स्थिति लेटेंसी, फ्रेम स्थिरता, पावर और थर्मल थ्रॉटलिंग को मापता है। परिणाम समान आउटपुट गुणवत्ता पर CPU और GPU पाथ के साथ तुलना किए जाते हैं। एप्लिकेशन क्षमता पहचान और परीक्षणित फॉलबैक का उपयोग करता है, न कि यह मानते हुए कि त्वरक मौजूद है या ड्राइवर अपडेट के बाद समान ग्राफ का समर्थन करता है।
रिलीज़ परीक्षण डिवाइस मॉडल, ऑपरेटिंग‑सिस्टम और ड्राइवर संस्करण, समवर्ती कार्यभार, बैटरी मोड और खराब इनपुट को कवर करता है। मॉडल पैकेज पर हस्ताक्षर किए जाते हैं और संस्करणित होते हैं; टेलीमेट्री प्रदर्शन और विफलताओं को रिकॉर्ड करती है बिना अनावश्यक वीडियो एकत्र किए। उत्पाद यह बताता है कि कब प्रोसेसिंग डिवाइस पर रहती है और कब क्लाउड सुविधाएँ उपयोग होती हैं। NPU अपना स्थान वास्तविक प्रतिबंधों के तहत संपूर्ण अनुभव को बेहतर बनाकर हासिल करता है, न कि केवल एक अलग TOPS या कर्नेल बेंचमार्क से।
व्यावहारिक कार्यान्वयन चेकलिस्ट
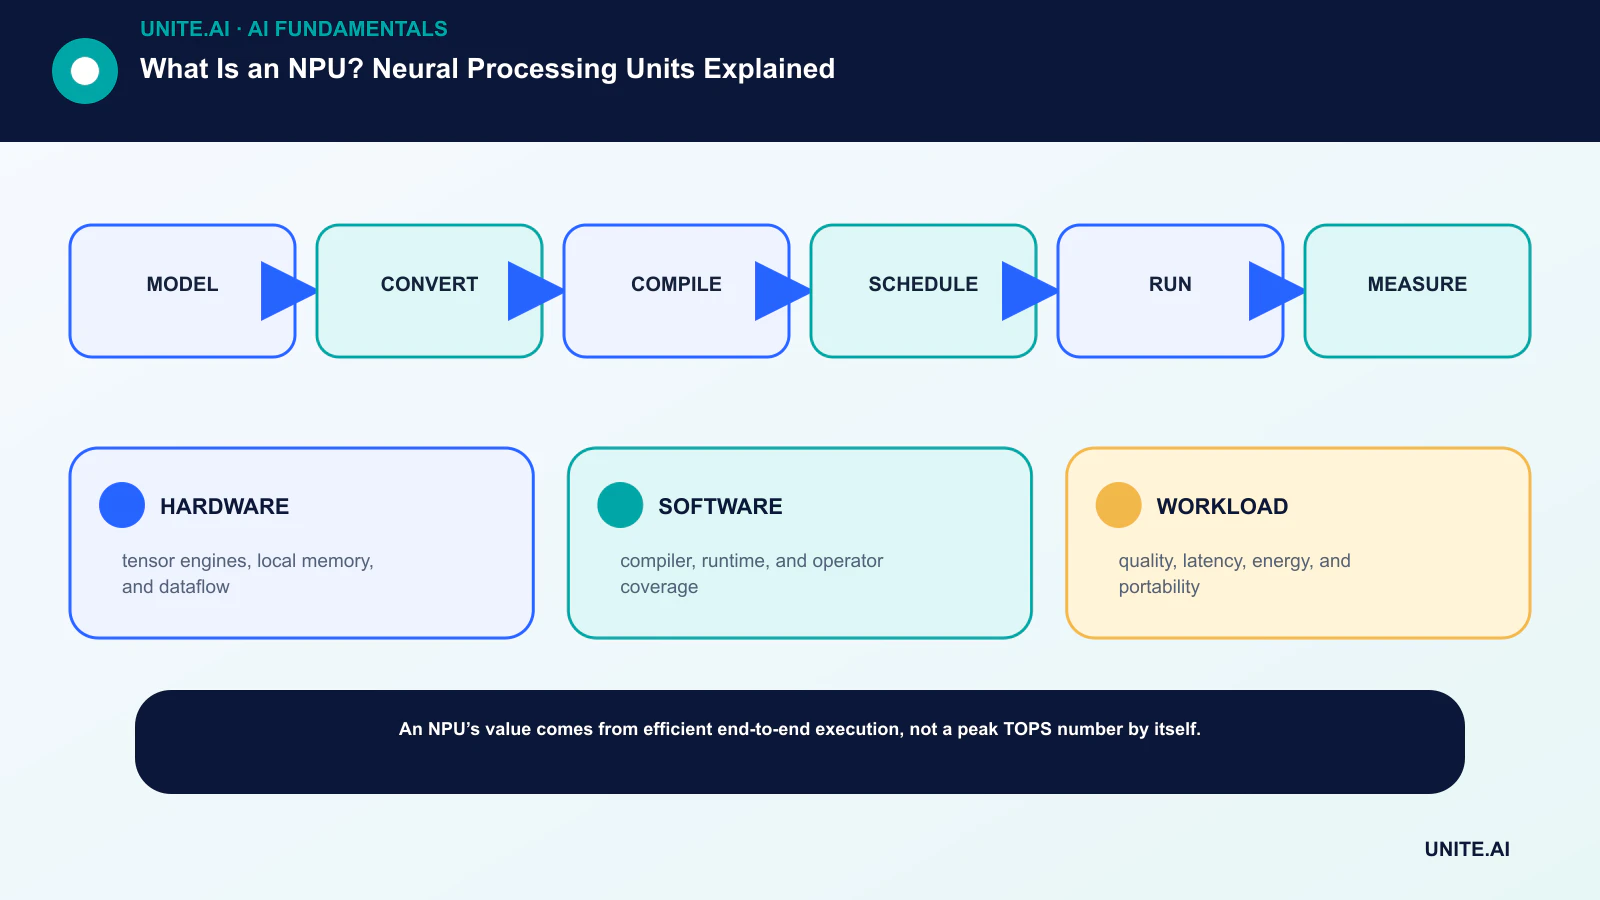
धारणा को सीमित, परीक्षण योग्य वर्कफ़्लो में बदलें: मॉडल → रूपांतरण → संकलन → शेड्यूल → चलाना → मापना। एक जिम्मेदार मालिक को नाम दें, डेटा और निर्भरताओं को दस्तावेज़ित करें, एक सरल बेसलाइन स्थापित करें, स्वीकृति और रोक मानदंड निर्धारित करें, प्रतिनिधि विफलताओं का परीक्षण करें, और दायरे को विस्तारित करने से पहले मॉनिटरिंग, रोलबैक और समीक्षा को परिभाषित करें। संस्करण और धारणाओं को रिकॉर्ड करें ताकि दूसरी टीम परिणाम को पुनः उत्पन्न कर सके और समझ सके कि क्या बदला।
लॉन्च से पहले, निर्माण, संचालन, सुरक्षा और सिस्टम से प्रभावित लोगों के साथ दस्तावेज़ित रेडीनेस रिव्यू चलाएँ। सामान्य मामलों, सीमा स्थितियों, निर्भरता विफलताओं और दुरुपयोग का परीक्षण करें; साक्ष्य और अनसुलझे जोखिमों को संरक्षित रखें। निर्धारित करें कि रिलीज़ को कौन मंजूर कर सकता है, थ्रेशोल्ड बदल सकता है, आउटपुट को ओवरराइड कर सकता है, या संचालन को रोक सकता है। वास्तविक‑दुनिया डेटा आने पर निर्णय को पुनः देखें, क्योंकि तकनीकी रूप से सफल पायलट व्यापक पैमाने पर विश्वसनीय प्रदर्शन की गारंटी नहीं देता।
- HARDWARE: टेंसर इंजन, स्थानीय मेमोरी, और डेटा‑फ़्लो।
- SOFTWARE: कंपाइलर, रनटाइम, और ऑपरेटर कवरेज।
- WORKLOAD: गुणवत्ता, लेटेंसी, ऊर्जा, और पोर्टेबिलिटी।
अक्सर पूछे जाने वाले प्रश्न
क्या NPU GPU से तेज़ है?
यह मॉडल, सटीकता, ऑपरेटर समर्थन, बैच आकार, पावर सीमा और सॉफ़्टवेयर पर निर्भर करता है। एक NPU समर्थित डिवाइस‑पर कार्यभार के लिए अधिक कुशल हो सकता है, जबकि GPU कहीं और तेज़ या अधिक लचीला हो सकता है।
क्या NPU सभी AI डेटा को निजी रखता है?
नहीं। यह स्थानीय प्रोसेसिंग सक्षम करता है, लेकिन एप्लिकेशन अभी भी डेटा या आउटपुट को क्लाउड सेवाओं को भेज सकता है। गोपनीयता पूरी आर्किटेक्चर और नीति पर निर्भर करती है।
प्राथमिक संदर्भ