
एआई की मूल बातें
न्यूरल नेटवर्क क्या हैं?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
एक कृत्रिम न्यूरल नेटवर्क परतों में जुड़े ऑपरेशनों से बना एक पैरामीटरयुक्त गणितीय मॉडल है। प्रशिक्षण के दौरान, नेटवर्क अपने पैरामीटर को इस प्रकार समायोजित करता है कि इनपुट उपयोगी आउटपुट में मैप हो जाएँ। न्यूरल नेटवर्क जटिल गैर‑रेखीय संबंधों का अनुमान लगा सकते हैं और पाठ, छवियों, ऑडियो, समय श्रृंखला और अन्य डेटा से सीधे प्रतिनिधित्व सीख सकते हैं।
नाम ऐतिहासिक रूप से जैविक न्यूरॉनों से प्रेरित है, लेकिन आधुनिक नेटवर्क इंजीनियरिंग सिस्टम हैं, न कि मस्तिष्क के वास्तविक सिमुलेशन। “न्यूरॉन” और “लर्निंग” जैसे शब्द सहायक संक्षिप्त रूप हैं और इन्हें मानव‑समान चेतना के प्रमाण के रूप में नहीं लेना चाहिए।
मुख्य बिंदु
- एक न्यूरॉन भारित योग की गणना करता है, एक प्रशिक्षण योग्य बायस जोड़ता है, और एक सक्रियण फ़ंक्शन लागू करता है।
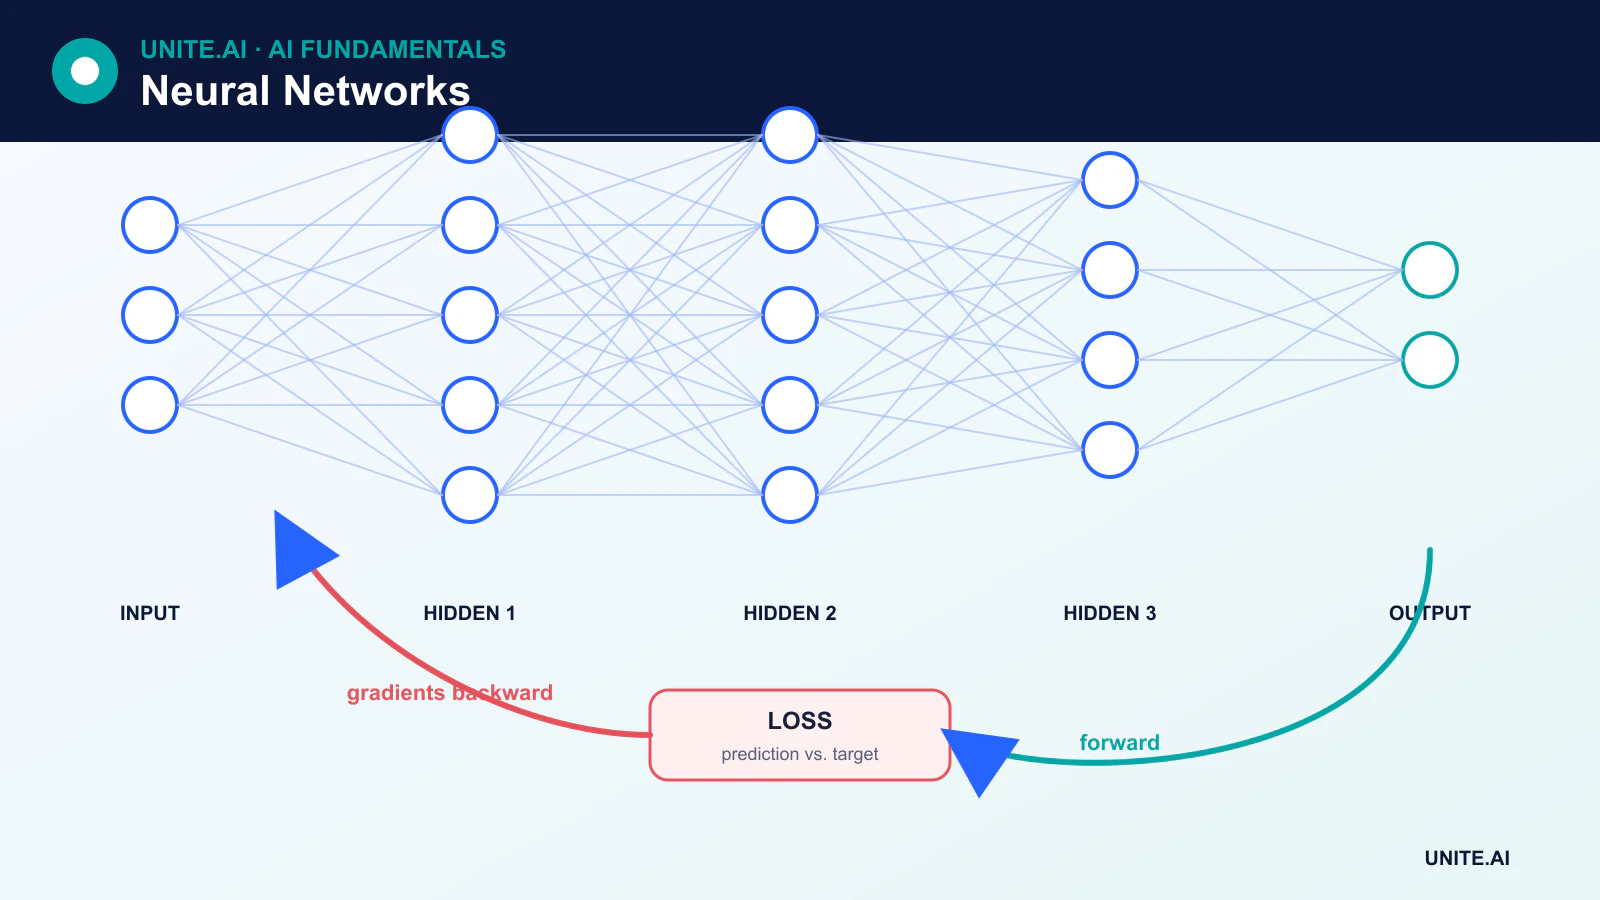
- एक फॉरवर्ड पास भविष्यवाणियाँ बनाता है; लॉस त्रुटि को मापता है; बैकप्रोपेगेशन ग्रेडिएंट्स की गणना करता है; एक ऑप्टिमाइज़र पैरामीटर अपडेट करता है।
- MLP, CNN, RNN और ट्रांसफ़ॉर्मर कनेक्शनों को अलग‑अलग तरीके से व्यवस्थित करते हैं।
- अधिक परतें या पैरामीटर स्वचालित रूप से बेहतर या अधिक विश्वसनीय मॉडल नहीं बनाते।
एकल कृत्रिम न्यूरॉन से नेटवर्क तक
एक इनपुट वेक्टर x के लिए, एक बुनियादी इकाई गणना करती है:
z = Wx + boutput = activation(z)
W में प्रशिक्षण योग्य वज़न होते हैं और b एक प्रशिक्षण योग्य बायस है। सक्रियण फ़ंक्शन गैर‑रेखीयता लाता है। वज़न स्वयं सक्रियण से “गुज़रते” नहीं हैं; सक्रियण को भारित योग और बायस पर लागू किया जाता है।
एक मल्टीलेयर पर्सेप्ट्रॉन (MLP) घनी परतों को स्टैक करता है। इनपुट लेयर फीचर्स को दर्शाती है, हिडन लेयर्स उन्हें रूपांतरित करती हैं, और आउटपुट लेयर कार्य के लिए डिज़ाइन की गई होती है—उदाहरण के लिए, क्लास लॉजिट्स या रिग्रेशन मान।
न्यूरल नेटवर्क कैसे सीखते हैं
- मॉडल प्रशिक्षण योग्य पैरामीटर को प्रारंभ करता है।
- एक फॉरवर्ड पास बैच को प्रोसेस करता है और भविष्यवाणियाँ उत्पन्न करता है।
- एक लॉस फ़ंक्शन भविष्यवाणियों की तुलना प्रशिक्षण लक्ष्य से करता है।
- Backpropagation चेन नियम का उपयोग करके ग्रेडिएंट्स की गणना करता है।
- एक ऑप्टिमाइज़र जैसे स्टोकेस्टिक ग्रेडिएंट डिसेंट या AdamW वज़न और बायस को अपडेट करता है।
बैकप्रोपेगेशन कई दशकों में विकसित और लोकप्रिय किए गए कार्य के माध्यम से न्यूरल‑नेटवर्क प्रशिक्षण का केंद्रीय हिस्सा बन गया; यह हालिया डीप‑लर्निंग युग में पहली बार नहीं बनाया गया था। आधुनिक फ्रेमवर्क रिवर्स‑मोड ऑटोमैटिक डिफरेंशिएशन को लागू करते हैं ताकि प्रैक्टिशनर को हर ग्रेडिएंट मैन्युअली डेरिवेटिव करने की आवश्यकता न पड़े।
सक्रियण फ़ंक्शन क्यों महत्वपूर्ण हैं
गैर‑रेखीय सक्रियणों के बिना, कई साधारण रैखिक परतें एक ही रैखिक रूपांतरण में समाहित हो जाती हैं। ReLU व्यापक रूप से उपयोग किया जाता है क्योंकि यह सरल और कुशल है। GELU और SiLU आधुनिक आर्किटेक्चर में सामान्य हैं। सिग्मॉइड और सॉफ्टमैक्स विशेष आउटपुट व्याख्याओं के लिए उपयोगी रहते हैं, लेकिन सिग्मॉइड हिडन लेयर्स में संतृप्त हो सकता है और ग्रेडिएंट्स के लुप्त होने में योगदान दे सकता है।
मुख्य न्यूरल‑नेटवर्क आर्किटेक्चर
कन्वॉल्यूशनल न्यूरल नेटवर्क
CNNs सीखे हुए फ़िल्टर को स्थानीय पड़ोस में लागू करते हैं और स्थितियों में पैरामीटर साझा करते हैं। ये गुण उन्हें छवियों और अन्य ग्रिड‑समान संकेतों के लिए कुशल बनाते हैं।
रिकरेंट नेटवर्क
RNNs, LSTMs, और GRUs क्रम में एक हिडन स्टेट को अपडेट करते हैं। वे स्ट्रीमिंग और टाइम‑सीरीज़ कार्यों के लिए उपयोगी रहते हैं, हालांकि रिकरेंस समानांतर प्रोसेसिंग को सीमित करता है और लंबी निर्भरताओं में संघर्ष कर सकता है।
ट्रांसफ़ॉर्मर
Transformers संदर्भ‑निर्भर प्रतिनिधित्व बनाने के लिए अटेंशन का उपयोग करते हैं। रेजिडुअल कनेक्शन, नॉर्मलाइज़ेशन, पोज़िशन जानकारी, और फीड‑फ़ॉरवर्ड ब्लॉक्स आर्किटेक्चर के मुख्य भाग हैं। ट्रांसफ़ॉर्मर अब कई बड़े भाषा और मल्टीमॉडल मॉडलों की नींव हैं।
ऑटोएन्कोडर और जेनरेटिव नेटवर्क
Autoencoders पुनर्निर्माण के माध्यम से प्रतिनिधित्व सीखते हैं। GANs, डिफ्यूज़न मॉडल, और ऑटोरिग्रेसिव नेटवर्क विभिन्न उद्देश्यों और प्रशिक्षण प्रक्रियाओं का उपयोग करके नए नमूने उत्पन्न करते हैं।
गहरी नेटवर्क को प्रशिक्षित करने योग्य बनाने वाले घटक
आधुनिक सिस्टम केवल परतों और सक्रियणों से अधिक उपयोग करते हैं। रेजिडुअल कनेक्शन जानकारी और ग्रेडिएंट्स को ब्लॉक्स के आसपास बायपास करने देते हैं। नॉर्मलाइज़ेशन सक्रियणों को स्थिर करता है। रेग्युलराइज़ेशन, डेटा ऑग्मेंटेशन, ड्रॉपआउट, और वज़न डिके overfitting को कम कर सकते हैं। एम्बेडिंग लेयर्स टोकन जैसे डिस्क्रीट आइटम को वेक्टर में मैप करती हैं। अटेंशन एक प्रतिनिधित्व को अन्य तत्वों पर गतिशील रूप से निर्भर बनाता है।
ताकत और सीमाएँ
न्यूरल नेटवर्क उच्च‑आयामी कच्चे डेटा से फीचर सीख सकते हैं और डेटा व कंप्यूट के साथ स्केल होते हैं। वे बड़े डेटासेट, विशेष हार्डवेयर, और सावधानीपूर्ण ट्यूनिंग की भी आवश्यकता कर सकते हैं। उनकी भविष्यवाणियाँ खराब कैलिब्रेटेड, वितरण परिवर्तन पर नाज़ुक, विरोधी हेरफेर के प्रति संवेदनशील, या समझाने में कठिन हो सकती हैं।
आर्किटेक्चर को कार्य और डिप्लॉयमेंट प्रतिबंधों के अनुसार होना चाहिए। कई टेबलर समस्याओं के लिए, ट्री एन्सेम्बल या रैखिक मॉडल तेज़ और सत्यापन में आसान हो सकते हैं। उच्च‑स्तरीय अनुप्रयोगों के लिए, मॉडल प्रदर्शन को केवल समग्र बेंचमार्क से नहीं, बल्कि उप‑समूह और विफलता मोड के आधार पर मूल्यांकन करना चाहिए।
परतें, सक्रियण, और सूचना प्रवाह
एक न्यूरल नेटवर्क पैरामीटरयुक्त फ़ंक्शनों को संयोजित करता है। प्रत्येक इकाई इनपुट का भारित संयोजन बनाती है, बायस जोड़ती है, और परिणाम को ReLU, सिग्मॉइड, tanh, या GELU जैसे सक्रियण से पास करती है। परतों को स्टैक करने से पदानुक्रमित फीचर और गैर‑रेखीय निर्णय सीमा मिलती है। चौड़ाई प्रति परत इकाइयों को नियंत्रित करती है; गहराई क्रमिक रूपांतरणों को नियंत्रित करती है; कनेक्टिविटी और वज़न शेयरिंग आर्किटेक्चर को एन्कोड करती है। नेटवर्क का आउटपुट प्री‑प्रोसेसिंग, पैरामीटर, नॉर्मलाइज़ेशन, और इन्फ़रेंस मोड पर निर्भर करता है। एक न्यूरॉन एक गणितीय ऑपरेशन है, न कि शाब्दिक जैविक न्यूरॉन या स्वतंत्र रूप से अर्थपूर्ण अवधारणा।
फ़ॉरवर्ड प्रोपेगेशन भविष्यवाणियाँ गणना करता है; लॉस त्रुटि को मापता है; बैकप्रोपेगेशन ग्रेडिएंट्स पर चेन नियम लागू करता है; एक ऑप्टिमाइज़र पैरामीटर अपडेट करता है। इनिशियलाइज़ेशन, लर्निंग रेट, बैच सांख्यिकी, रेजिडुअल पाथ, और नॉर्मलाइज़ेशन यह निर्धारित करते हैं कि ग्रेडिएंट्स लुप्त हों, विस्फोटित हों, या उपयोगी रहें। रेग्युलराइज़ेशन में वज़न डिके, ड्रॉपआउट, ऑग्मेंटेशन, अर्ली स्टॉपिंग, और आर्किटेक्चरल प्रतिबंध शामिल हैं। प्रशिक्षण और वैलिडेशन व्यवहार को प्लॉट करें, ग्रेडिएंट और सक्रियण सांख्यिकी की जाँच करें, और दोहराए गए रन की तुलना करें। एक बड़ा नेटवर्क प्रशिक्षण डेटा को याद रख सकता है, जबकि एक छोटा नेटवर्क अंडरफ़िट या आवश्यक संरचना को मिस कर सकता है।
आर्किटेक्चर चयन, मूल्यांकन, और डिप्लॉयमेंट
मल्टीलेयर पर्सेप्ट्रॉन स्थिर वेक्टर प्रोसेस करते हैं; कन्वॉल्यूशनल नेटवर्क स्थानीय संरचना का फायदा उठाते हैं; रिकरेंट और स्टेट‑स्पेस मॉडल क्रमों को प्रोसेस करते हैं; ट्रांसफ़ॉर्मर अटेंशन का उपयोग करते हैं; ग्राफ नेटवर्क किनारों के साथ जानकारी का आदान‑प्रदान करते हैं। हाइब्रिड सामान्य हैं। चयन इंडक्टिव बायस, डेटा, क्रम या छवि आकार, लेटेंसी, मेमोरी, व्याख्यात्मकता, और उपलब्ध हार्डवेयर के आधार पर करें। एक रैखिक या ट्री बेसलाइन के खिलाफ मूल्यांकन करें और एब्लेशन करके समझें कि कौन सी जटिलता मायने रखती है। केवल पैरामीटर गिनती गुणवत्ता, इन्फ़रेंस लागत, या डेटा आवश्यकता का पूर्वानुमान नहीं देती।
सर्विंग के लिए फ्रीज़्ड प्री‑प्रोसेसिंग, निर्यातित या संकलित ग्राफ, संख्यात्मक वैलिडेशन, और वास्तविक लोड पर संसाधन परीक्षण आवश्यक हैं। क्वांटाइज़ेशन और प्रूनिंग आकार घटा सकते हैं लेकिन दुर्लभ‑क्लास व्यवहार को बदल सकते हैं। इनपुट, आउटपुट, कैलिब्रेशन, लेटेंसी, और पुष्टि किए गए परिणामों की निगरानी करें; विरोधी और शिफ्टेड डेटा का परीक्षण करें। मॉडल, निर्भरताएँ, और डेटा को साइन किए गए आर्टिफैक्ट, एक्सेस कंट्रोल, और सप्लाई‑चेन रिव्यू के माध्यम से सुरक्षित रखें। व्यक्तिगत सक्रियण या सैलिएंसी से प्राप्त व्याख्याओं को कारणात्मक और व्यवहारिक सत्यापन की आवश्यकता होती है। न्यूरल नेटवर्क लचीले फ़ंक्शन एप्रॉक्सिमेटर हैं, न कि समझ, सत्य, या मजबूती की गारंटी।
व्यावहारिक उदाहरण: एक न्यूरल डिमांड फोरकास्टर
एक रिटेलर बिक्री, प्रमोशन, कीमत, छुट्टियों, उपलब्धता, और मौसम से साप्ताहिक आइटम डिमांड की भविष्यवाणी करता है। नेटवर्क को मौसमी‑नैव, रैखिक, और ट्री बेसलाइन के साथ रोलिंग टाइम स्प्लिट्स का उपयोग करके तुलना की जाती है। भविष्य के प्रमोशन केवल तब शामिल किए जाते हैं जब फोरकास्ट समय पर वास्तव में ज्ञात हों, जबकि स्टॉक‑आउट को मॉडल किया जाता है क्योंकि देखी गई बिक्री डिमांड को कम दिखा सकती है। मूल्यांकन में वेटेड एब्सोल्यूट एरर, बायस, इंटरवल कवरेज, और आइटम वेग व स्टोर के आधार पर परिणाम शामिल हैं।
सर्विंग पाइपलाइन संस्करण फीचर उपलब्धता, मॉडल, और क्षितिज को दर्शाते हैं और जब आवश्यक इनपुट पुराना हो तो फोरकास्ट को अस्वीकार करते हैं। प्लानर इंटरवल देखते हैं और रिकॉर्ड किए गए कारणों के साथ ओवरराइड कर सकते हैं। मॉनिटरिंग गायब फ़ीड, बदलते एरर, बायस, और असामान्य फोरकास्ट का पता लगाती है; व्यावसायिक परिणाम फोरकास्ट सटीकता से अलग होते हैं क्योंकि ऑर्डर नीति भी इन्वेंट्री को प्रभावित करती है। एक मॉडल अपडेट कई चक्रों में शैडो किया जाता है, और पूर्व फोरकास्टर मौसमी या सप्लायर विघटन के दौरान रोलबैक के लिए उपलब्ध रहता है।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक प्रोडक्शन निर्णय को सफल डेमोंस्ट्रेशन से अधिक की आवश्यकता होती है। इच्छित उपयोगकर्ता, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादक बेसलाइन और एक संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या गायब इनपुट, वितरण शिफ्ट, निर्भरता आउटेज, दुरुपयोग, और सबसे अधिक अंडरसर्व्ड समूहों या वातावरण का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता, और सुरक्षा के साथ मापें। हर परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनरुत्पादित कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक, और रिटायरमेंट के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित फॉलबैक रखें, और जानबूझकर इंजेक्ट किए गए फेल्योर के साथ मॉनिटरिंग को सत्यापित करें। ऑपरेशनल टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर डिप्लॉयमेंट के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, न कि मानें कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियाँ, हार्डवेयर, या उद्देश्य बदलें, पुनर्मूल्यांकन करें। एक रखरखाव किया गया सिस्टम को दस्तावेज़ित रिकवरी, घटना सीखना, हटाने और रखरखाव प्रक्रियाओं, और एक स्पष्ट बिंदु चाहिए जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या हर न्यूरल नेटवर्क डीप लर्निंग है?
नहीं। एक छोटा नेटवर्क जिसमें एक हिडन लेयर हो, वह न्यूरल नेटवर्क है, जबकि डीप लर्निंग आमतौर पर कई सीखित प्रोसेसिंग चरणों वाली आर्किटेक्चर को दर्शाता है। यह सीमा पारंपरिक है, न कि कोई कठोर वैज्ञानिक सीमा।
क्या न्यूरल नेटवर्क अपने प्रशिक्षण डेटा को संग्रहीत करते हैं?
वे सीखे हुए पैरामीटर संग्रहीत करते हैं, न कि डेटासेट की सामान्य खोज योग्य प्रति। फिर भी, बड़े मॉडल व्यक्तिगत प्रशिक्षण उदाहरणों को याद रख सकते हैं और पुन: उत्पन्न कर सकते हैं, जिससे गोपनीयता और कॉपीराइट जोखिम उत्पन्न होते हैं जिन्हें परीक्षण करना आवश्यक है।
प्राथमिक संदर्भ












