
एआई की मूल बातें
K-Nearest Neighbors (KNN) क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
K-nearest neighbors (KNN) निकटतम लेबल वाले प्रशिक्षण उदाहरणों से जो क्वेरी बिंदु के सबसे करीब होते हैं, एक परिणाम की भविष्यवाणी करता है। वर्गीकरण के लिए, पड़ोसी वर्ग पर वोट देते हैं। प्रतिगमन के लिए, उनके लक्ष्य मानों का औसत लिया जाता है या अन्य तरीके से संयोजित किया जाता है।
KNN एक उदाहरण-आधारित, गैर-जनरलाइज़िंग विधि है: फिटिंग मुख्यतः प्रशिक्षण उदाहरणों और वैकल्पिक खोज इंडेक्स को संग्रहीत करता है। यह प्रशिक्षण, सत्यापन और परीक्षण विभाजन की आवश्यकता को नहीं हटाता। अलग रखे डेटा पर मूल्यांकन k, दूरी मीट्रिक, फीचर प्रोसेसिंग और वोटिंग नियम चुनने के लिए आवश्यक है।
मुख्य बिंदु
- KNN स्थानीय स्तर पर भविष्यवाणी करता है; यह डेटा सेट को पहले क्लस्टर में विभाजित नहीं करता।
- फ़ीचर स्केलिंग महत्वपूर्ण है क्योंकि दूरी निर्धारित करती है कि कौन से उदाहरण पड़ोसी माने जाएंगे।
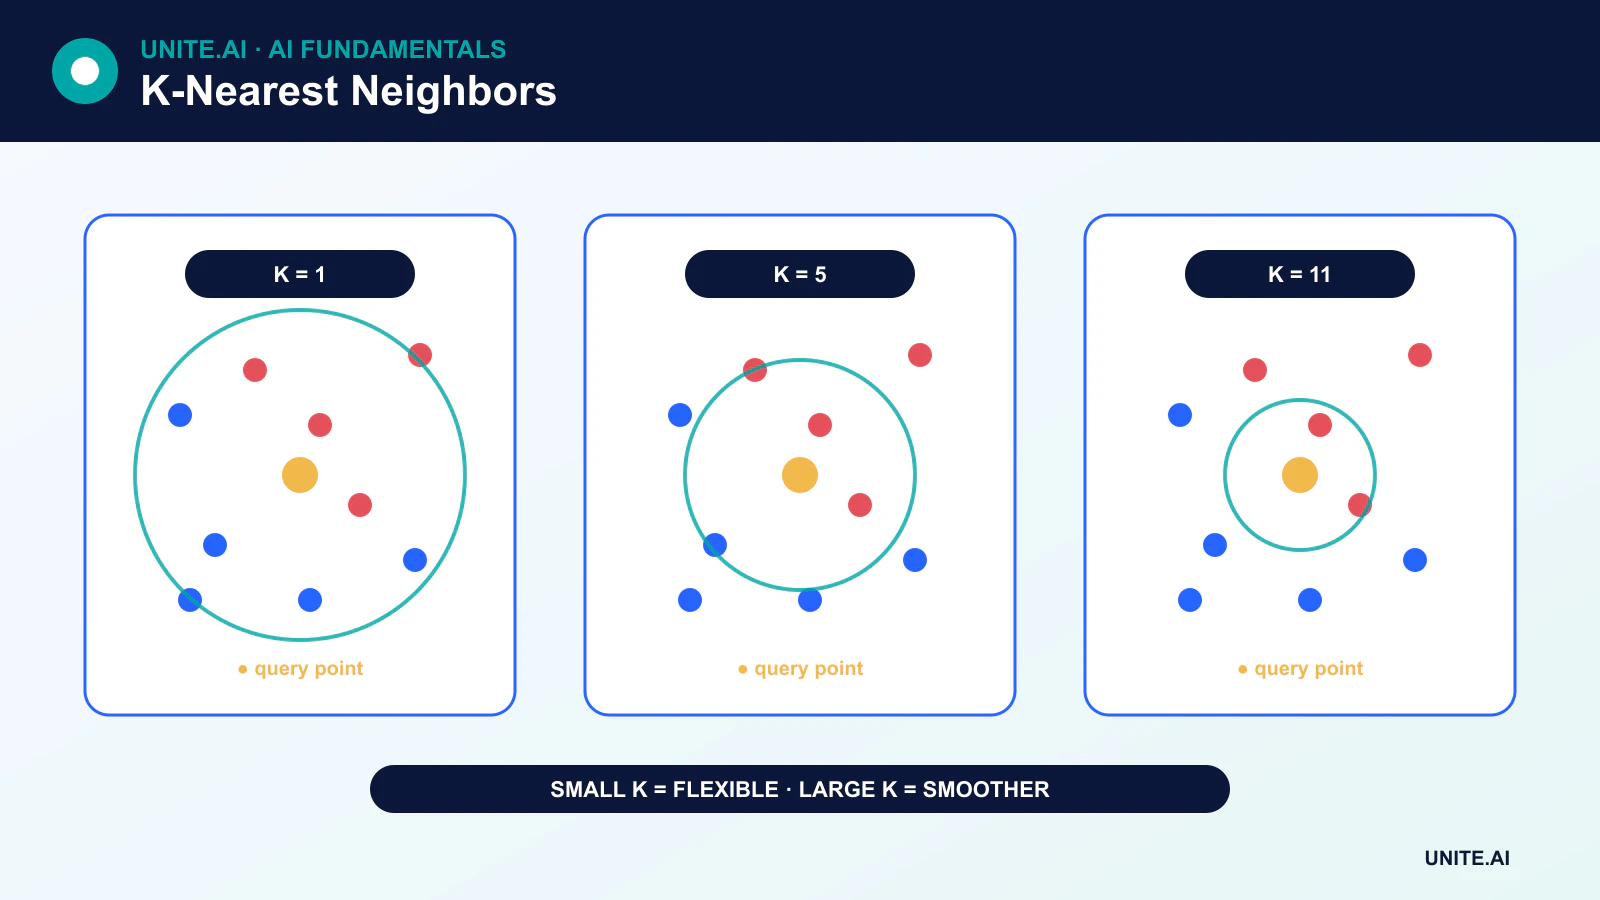
- छोटा k शोरयुक्त हो सकता है, जबकि बड़ा k स्थानीय संरचना को स्मूथ कर सकता है।
- उच्च आयाम, अप्रासंगिक फीचर, वर्ग असंतुलन, और धीमी खोज प्रदर्शन को सीमित कर सकते हैं।
KNN वर्गीकरण कैसे काम करता है
- क्वेरी और प्रशिक्षण उदाहरणों को समान फीचर स्पेस में प्रस्तुत करें।
- क्वेरी से प्रशिक्षण उदाहरणों तक की दूरी की गणना करें।
- सबसे निकट के k उदाहरण चुनें।
- बहुमत वर्ग की भविष्यवाणी करें या दूरी-भारित वोटिंग का उपयोग करें।
भारित वोटिंग निकटतम पड़ोसियों को अधिक प्रभाव देती है। टाई की स्थिति में एक प्रलेखित नियम की आवश्यकता होती है, और समान दूरी वाले पड़ोसी जिनके लेबल अलग हैं, परिणामों को क्रम या कार्यान्वयन विवरणों पर निर्भर बना सकते हैं।
KNN प्रतिगमन
प्रतिगमन के लिए, भविष्यवाणी आमतौर पर पड़ोसी लक्ष्यों का औसत होती है। दूरी भारित करने से दूरस्थ अवलोकनों का प्रभाव कम हो सकता है। जब स्थानीय लक्ष्य में अपवाद (आउटलायर) हों, तो मध्यिका या मजबूत समाकलन उपयोगी हो सकता है।
दूरी मेट्रिक
यूक्लिडियन दूरी सतत फीचर के लिए सामान्य है, मैनहट्टन दूरी निरपेक्ष अंतर का योग करती है, और कोसाइन दूरी परिमाण के बजाय दिशा पर केंद्रित होती है। अन्य मेट्रिक बाइनरी, श्रेणीबद्ध, भौगोलिक, अनुक्रम या सीखित एम्बेडिंग डेटा पर लागू होते हैं।
KNN को “गैर-पैरामीट्रिक” कहने का अर्थ है कि यह निर्णय सीमा के लिए किसी स्थिर सीमित-आयामी कार्यात्मक रूप को मानता नहीं है। यह फिर भी मानता है कि चयनित प्रतिनिधित्व और मीट्रिक निकटवर्ती बिंदुओं को एक-दूसरे के लिए प्रासंगिक बनाते हैं।
स्केलिंग क्यों महत्वपूर्ण है
यदि एक फीचर 0 से 1 तक और दूसरा 0 से 100,000 तक रहता है, तो सामान्य यूरोक्लिडियन दूरी दूसरे फीचर द्वारा प्रमुख हो जाएगी। मानकीकरण, सामान्यीकरण, या डोमेन-विशिष्ट रूपांतरण को प्रशिक्षण भाग पर फिट किया जाना चाहिए और सत्यापन, परीक्षण, तथा उत्पादन डेटा पर लागू किया जाना चाहिए।
अप्रासंगिक फीचर भी पड़ोस को विकृत कर सकते हैं। फीचर चयन, आयाम घटाव, या सीखित प्रतिनिधित्व मददगार हो सकते हैं, लेकिन प्रत्येक चयन को डेटा लीक के बिना मान्य किया जाना चाहिए।
k चुनना
k = 1 के साथ, मॉडल शोर और गलत लेबल वाले उदाहरणों का अनुसरण कर सकता है। जैसे-जैसे k बढ़ता है, भविष्यवाणियां स्मूथ होती हैं और एक बिंदु के प्रति कम संवेदनशील होती हैं। यदि k बहुत बड़ा हो जाता है, तो दूरस्थ वर्ग या क्षेत्रों का प्रभुत्व बढ़ जाता है और मॉडल अंडरफ़िट हो जाता है।
प्रशिक्षण डेटा पर क्रॉस-वैलिडेशन के माध्यम से k चुनें। द्विआधारी वर्गीकरण के लिए, विषम k टाई को घटाता है लेकिन पूरी तरह समाप्त नहीं करता। वर्ग भार, स्तरीकृत विभाजन, थ्रेशोल्ड चयन, और उपयुक्त मीट्रिक असंतुलित वर्गों के समय महत्वपूर्ण होते हैं।
आयामीयता का अभिशाप
उच्च-आयामी स्थानों में, दूरी कम सूचनात्मक हो सकती है क्योंकि उदाहरण विरल होते हैं और निकटतम तथा सबसे दूर की दूरी आपस में समान हो जाती है। अर्थपूर्ण स्थानीय पड़ोस बनाए रखने के लिए KNN को अत्यधिक मात्रा में डेटा की आवश्यकता हो सकती है। इसे ही आयामीयता का अभिशाप कहा जाता है।
आयामीयता घटाव या कार्य-विशिष्ट एम्बेडिंग मदद कर सकते हैं, लेकिन एम्बेडिंग की ज्यामिति को इच्छित समानता अवधारणा के लिए मान्य किया जाना चाहिए।
खोज प्रदर्शन
एक ब्रूट‑फ़ोर्स क्वेरी नए बिंदु की तुलना सभी संग्रहीत उदाहरणों से करती है। KD ट्री और बॉल ट्री कुछ सटीक खोजों को तेज़ करते हैं, हालांकि उनका लाभ उच्च आयामों में घट जाता है। अनुमानित निकटतम‑पड़ोसी इंडेक्स थोड़ी सी रिकॉल की कीमत पर बड़ी गति और मेमोरी लाभ प्रदान करते हैं। यह अवधारणा वेक्टर समानता खोज को भी समर्थन देती है।
ताकतें और सीमाएँ
KNN सरल है, अनियमित निर्णय सीमाओं का समर्थन करता है, और एक सहज उदाहरण-आधारित व्याख्या प्रदान करता है। यह काफी मेमोरी की आवश्यकता भी रख सकता है, संवेदनशील प्रशिक्षण उदाहरणों को उजागर कर सकता है, धीरे‑धीरे भविष्यवाणी करता है, और जब दूरी अर्थपूर्ण नहीं होती तो खराब प्रदर्शन करता है। यह एक उपयोगी बेंचमार्क है—डिफ़ॉल्ट रूप से अधिकांश समस्याओं में अत्यधिक सटीक विधि नहीं है।
दूरी, पड़ोस, और हाइपरपैरामीटर व्यवहार
K-nearest neighbors प्रशिक्षण उदाहरणों को संग्रहीत करता है और चुनी गई दूरी के तहत k सबसे निकटतम से भविष्यवाणी करता है। वर्गीकरण बहुमत या दूरी‑भारित वोट का उपयोग करता है; प्रतिगमन पड़ोसी लक्ष्यों का औसत लेता है। स्केलिंग आवश्यक है क्योंकि उच्च-रेंज वाला फीचर यूरोक्लिडियन दूरी को प्रमुख बना सकता है। श्रेणीबद्ध, विरल, अनुक्रम या भौगोलिक डेटा को हैमिंग, कोसाइन, संपादन, ग्रेट‑सर्कल, या सीखित दूरियों की आवश्यकता हो सकती है। मीट्रिक समानता के बारे में एक मॉडलिंग मान्यत है, और इसे निकटवर्ती मामलों के वास्तविक अर्थ के विरुद्ध मान्य किया जाना चाहिए।
छोटा k लचीले, उच्च‑वैरिएंस सीमाओं और शोर के प्रति संवेदनशीलता बनाता है; बड़ा k भविष्यवाणियों को स्मूथ करता है और अल्पसंख्यक संरचना को मिटा सकता है। विषम k केवल कुछ द्विआधारी टाई को रोकता है और यह सामान्य नियम नहीं है। क्रॉस‑वैलिडेशन के भीतर k, दूरी, भार, फीचर सेट, और प्री‑प्रोसेसिंग चुनें। वर्ग असंतुलन स्थानीय बहुमत वोट को दुर्लभ परिणामों को अनदेखा करवा सकता है, इसलिए प्रति‑वर्ग रिकॉल और पड़ोस संरचना की जाँच करें। उच्च‑आयामी दूरियां अक्सर केंद्रित हो जाती हैं, और अप्रासंगिक फीचर पड़ोस को घटाते हैं; चयन, आयाम घटाव, या सीखित एम्बेडिंग मदद कर सकते हैं।
इंडेक्सिंग, अनिश्चितता, और उत्पादन संचालन
सरल अनुमान क्वेरी की तुलना सभी प्रशिक्षण बिंदुओं से करता है। उपयुक्त निम्न आयामों में KD ट्री और बॉल ट्री मदद करते हैं; अनुमानित निकटतम‑पड़ोसी इंडेक्स सटीकता को गति और स्केल के लिए बदलते हैं। पड़ोसी खोज की रिकॉल को भविष्यवाणी गुणवत्ता से अलग मापें। मेमोरी में संग्रहीत फीचर, लेबल, और इंडेक्स संरचनाएँ शामिल हैं। अपडेट अवधारणात्मक रूप से सरल होते हैं लेकिन इंडेक्स पुनर्निर्माण, संस्करण संगतता, और हटाने के प्रसार की आवश्यकता हो सकती है। संवेदनशील प्रशिक्षण उदाहरणों की सुरक्षा करें क्योंकि पड़ोसियों या दूरियों को लौटाने से रिकॉर्ड उजागर हो सकते हैं।
KNN ऐसे उदाहरण प्रस्तुत कर सकता है जिससे भविष्यवाणी समझ में आए, लेकिन निकटता कारण या न्यायसंगतता नहीं दर्शाती। जब पड़ोस विरल या विरोधाभासी हों तो दूरी, वोट मार्जिन, और एक परहेज़ नियम प्रदान करें। क्वेरी दूरी, पड़ोसी लेबल, फीचर ड्रिफ्ट, विलंब, और पुष्टि किए गए परिणामों की निगरानी करें। प्री‑प्रोसेसिंग और इंडेक्स संस्करणों को समन्वित रखें, और परिवर्तन के बाद सटीक बनाम अनुमानित परिणामों का परीक्षण करें। जब दूरी अर्थपूर्ण हो तो KNN एक प्रभावी स्थानीय बेंचमार्क और पुनःप्राप्ति विधि है; जब समानता उपलब्ध फीचर द्वारा प्रतिनिधित्व नहीं की जा सकती तो यह संघर्ष करता है।
व्यावहारिक उदाहरण: उत्पाद प्रतिस्थापन के लिए KNN
एक रिटेलर उत्पादों को मानकीकृत संख्यात्मक गुण, श्रेणीबद्ध संगतता, और एक सीखित टेक्स्ट एम्बेडिंग के साथ दर्शाता है, फिर मर्चेंडाइज़र द्वारा समीक्षा किए गए भारित दूरी को परिभाषित करता है। K और भार बाद के उत्पाद लॉन्च के आधार पर चुने जाते हैं, न कि यादृच्छिक आइटम पंक्तियों से। मूल्यांकन प्रासंगिक प्रतिस्थापन रिकॉल, असंगत सिफ़ारिशें, दूरी, श्रेणी कवरेज, और दुर्लभ आइटम के परिणामों की जाँच करता है। एक लोकप्रियता बेंचमार्क दर्शाता है कि स्थानीय समानता मूल्य जोड़ती है या नहीं।
एक अनुमानित इंडेक्स को रिकॉल और विलंब के लिए सटीक पड़ोसियों के विरुद्ध बेंचमार्क किया जाता है। उन क्वेरीज़ जिनमें कोई निकटतम संगत आइटम नहीं होता, सुझाव नहीं लौटातीं बल्कि कोई मजबूर पड़ोसी नहीं देतीं। उत्पाद हटाव और गुण सुधार संस्करणित अपडेट के माध्यम से इंडेक्स में प्रसारित होते हैं। मॉनिटरिंग दूरी वितरण, खाली परिणाम, ओवरराइड, और व्यावसायिक परिणामों को ट्रैक करती है, बिना बिक्री को वास्तविक संगतता के साथ भ्रमित किए। संवेदनशील आपूर्तिकर्ता शर्तें व्याख्याओं से बाहर रखी जाती हैं, और लौटाए गए उदाहरण समानता के प्रमाण रहते हैं—यह दावा नहीं कि उत्पाद समान हैं।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय को सफल प्रदर्शन से अधिक की आवश्यकता होती है। इच्छित उपयोगकर्ताओं, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादनीय बेंचमार्क और एक संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपलब्ध इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग, और सबसे अधिक सेवा‑हीन समूहों या वातावरण का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, विलंब, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनः उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक, और रिटायरमेंट के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित बैकअप रखें, और जानबूझकर डाले गए विफलताओं के साथ मॉनिटरिंग को सत्यापित करें। परिचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणामों को अनावश्यक संवेदनशील डेटा एकत्र किए बिना उजागर करना चाहिए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, न कि यह मानते हुए कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियां, हार्डवेयर, या लक्ष्य बदलें, पुनः‑मूल्यांकन करें। एक रखरखाव प्रणाली को दस्तावेज़ित पुनर्प्राप्ति, घटना‑सीख, हटाने और रखरखाव प्रक्रियाओं, और एक स्पष्ट बिंदु की भी आवश्यकता होती है जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या KNN का कोई प्रशिक्षण चरण होता है?
इसमें बहुत कम पैरामीटर फ़िटिंग होती है, लेकिन फिर भी इसका एक विकास प्रक्रिया है: प्री‑प्रोसेसिंग प्रशिक्षण डेटा से सीखी जाती है, एक इंडेक्स बनाया जा सकता है, और k, मीट्रिक, भार, और फीचर वैधता के साथ चुने जाते हैं।
क्या KNN, K-means के समान है?
नहीं। KNN मुख्यतः एक सुपरवाइज़्ड स्थानीय‑भविष्यवाणी विधि है। K-means एक अनसुपरवाइज़्ड क्लस्टरिंग एल्गोरिद्म है जिसमें K क्लस्टर केंद्रों की संख्या है।
प्राथमिक संदर्भ












