
एआई की मूल बातें
डीप लर्निंग में RNNs और LSTMs क्या हैं?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
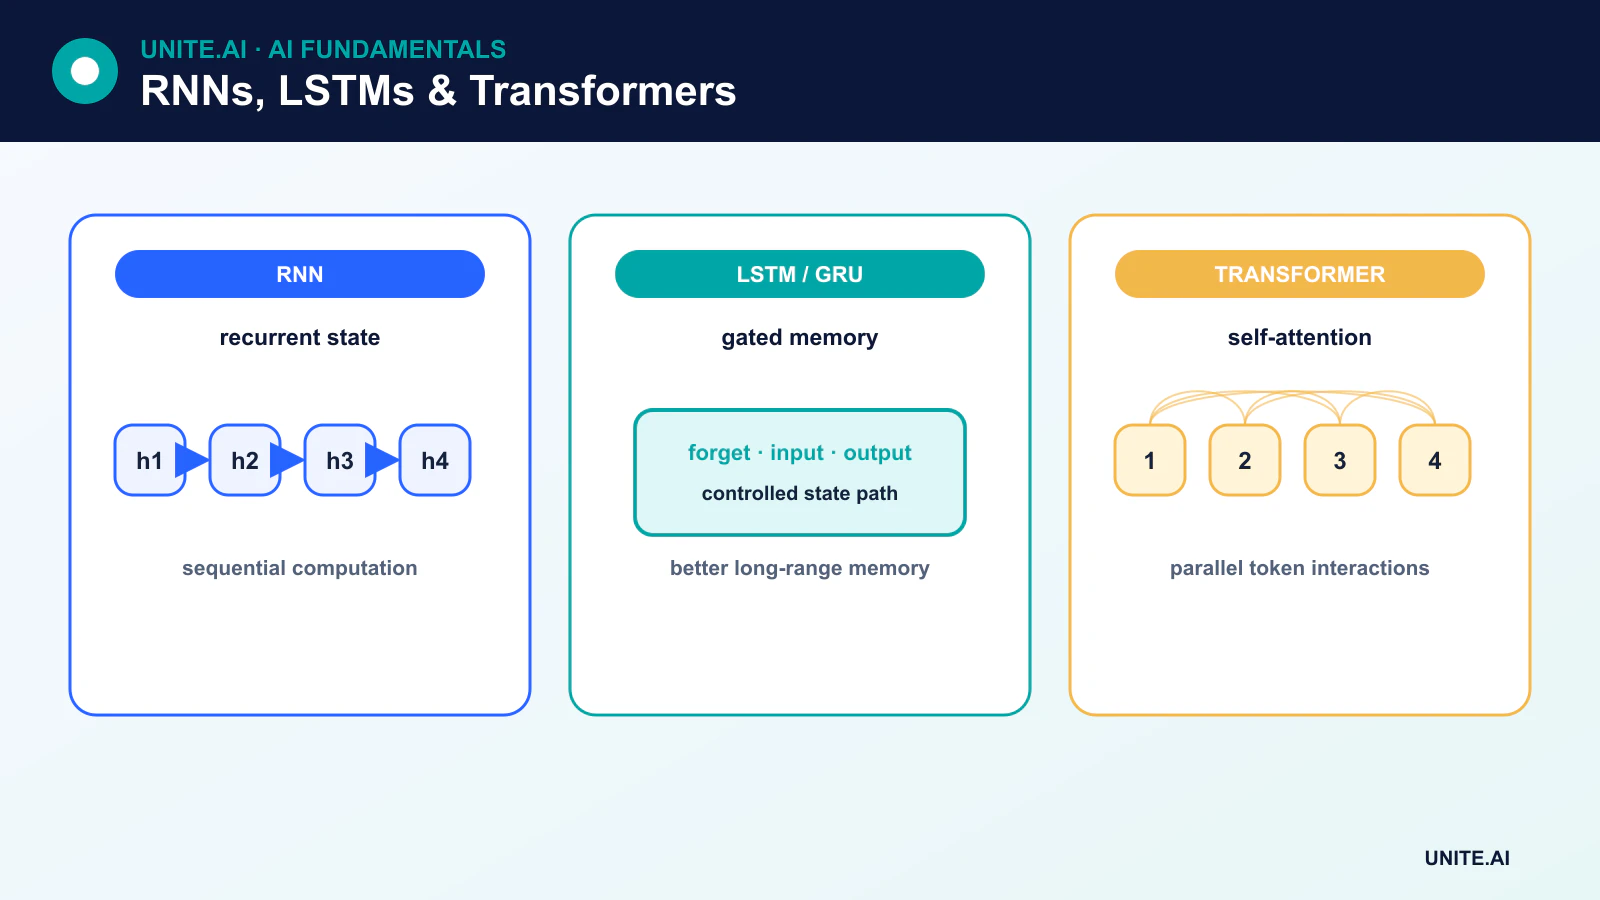
रीकरेंट न्यूरल नेटवर्क (RNNs) क्रमों को समय के साथ एक छिपी हुई स्थिति को अपडेट करके प्रोसेस करते हैं। लॉन्ग शॉर्ट-टर्म मेमोरी (LSTM) नेटवर्क गेटेड RNNs हैं जो बुनियादी रीकरेंट यूनिट की तुलना में जानकारी को अधिक प्रभावी ढंग से संरक्षित और नियंत्रित करने के लिए डिजाइन किए गए हैं।
RNNs और LSTMs ने कभी कई भाषा कार्यों में प्रभुत्व रखा था, लेकिन आधुनिक बड़े चैटबॉट्स मुख्यतः ट्रांसफ़ॉर्मर्स पर आधारित हैं। रीकरेंट मॉडल स्ट्रीमिंग, टाइम-सीरीज़, स्पीच, नियंत्रण, और संसाधन-सीमित सिस्टम्स में उपयोगी रहते हैं जहाँ क्रमिक स्थिति और कम लेटेंसी महत्वपूर्ण होती है।
मुख्य बिंदु
- एक RNN प्रत्येक क्रम चरण पर वही पैरामीटर पुनः उपयोग करता है और छिपी हुई स्थिति को आगे ले जाता है।
- समय के माध्यम से प्रशिक्षण वैनिशिंग या एक्सप्लोडिंग ग्रेडिएंट्स पैदा कर सकता है।
- एक LSTM सेल स्थिति तथा इनपुट, फ़रगेट और आउटपुट गेट्स जोड़ता है।
- ट्रांसफ़ॉर्मर्स लंबी दूरी के संबंधों और समानांतर प्रशिक्षण को अलग तरीके से संभालते हैं; कोई भी आर्किटेक्चर हर परिनियोजन के लिए सर्वश्रेष्ठ नहीं है।
एक बुनियादी RNN कैसे काम करता है
t चरण पर, एक साधारण रीकरेंट यूनिट वर्तमान इनपुट xₜ को पिछले छिपे हुए स्थिति hₜ₋₁ के साथ मिलाता है:
hₜ = activation(Wₓxₜ + Wₕhₜ₋₁ + b)
छिपी हुई स्थिति एक सीखी हुई सारांश है जो अगले चरण के लिए तथा कार्य के आधार पर आउटपुट के रूप में उपयोग होती है। “अनरोल्ड” आरेख प्रत्येक समय चरण के लिए एक प्रति बनाता है, लेकिन सभी प्रतियां पैरामीटर साझा करती हैं। आउटपुट केवल नई कच्ची इनपुट के रूप में नहीं कॉपी किया जाता; रीकरेंस एक परिभाषित परिवर्तन के माध्यम से छिपी हुई स्थिति को पास करता है।
समय के माध्यम से बैकप्रॉपेगेशन
RNNs को बैकप्रॉपेगेशन थ्रू टाइम (BPTT) के साथ प्रशिक्षित किया जाता है। अनरोल्ड क्रम एक गहरा कम्प्यूटेशनल ग्राफ बनाता है, और बैकप्रॉपेगेशन यह गणना करता है कि लॉस साझा रीकरेंट पैरामीटरों पर कैसे निर्भर करता है।
बार-बार गुणा करने से ग्रेडिएंट शून्य की ओर घट सकते हैं या अनंत तक बढ़ सकते हैं। वैनिशिंग ग्रेडिएंट्स लंबी निर्भरताओं को सीखने से रोकते हैं; एक्सप्लोडिंग ग्रेडिएंट्स अस्थिर अपडेट बनाते हैं। ग्रेडिएंट क्लिपिंग एक्सप्लोडिंग ग्रेडिएंट्स को नियंत्रित करती है, जबकि गेटिंग, इनिशियलाइज़ेशन, नॉर्मलाइज़ेशन, और छोटे प्रशिक्षण विंडो मदद कर सकते हैं।
LSTM सेल के भीतर
एक LSTM छिपी हुई स्थिति hₜ के अतिरिक्त सेल स्थिति cₜ को बनाए रखता है। इसके गेट्स सीखने योग्य, डेटा-निर्भर नियंत्रण होते हैं:
- फ़रगेट गेट निर्धारित करता है कि पिछले सेल स्थिति का कितना हिस्सा बरकरार रखा जाए।
- इनपुट गेट निर्धारित करता है कि उम्मीदवार जानकारी का कितना भाग लिखा जाए।
- आउटपुट गेट निर्धारित करता है कि सेल जानकारी का कितना भाग छिपी हुई स्थिति में योगदान दे।
शून्य से एक के बीच सिग्मॉइड आउटपुट सॉफ्ट गेट्स के रूप में कार्य करते हैं, जबकि टैनएच-परिवर्तित उम्मीदवार नई सामग्री प्रदान करता है। ऐडिटिव सेल-स्टेट पाथ ग्रेडिएंट को बनाए रखने में मदद करता है, लेकिन LSTMs अनिश्चित स्मृति की गारंटी नहीं देते और सभी ऑप्टिमाइज़ेशन समस्याओं को समाप्त नहीं करते।
GRUs और द्विदिश रीकरेंस
एक गेटेड रीकरेंट यूनिट (GRU) गेटिंग मैकेनिज़्म को एक सरल रीकरेंट सेल में सम्मिलित करता है, जिसमें अलग LSTM‑स्टाइल सेल स्थिति नहीं होती। GRUs तेज़ प्रशिक्षण कर सकते हैं और कुछ कार्यों पर समान प्रदर्शन देते हैं।
एक द्विदिश RNN पूर्ण क्रम को दोनों दिशाओं में प्रोसेस करता है और स्थितियों को संयोजित करता है। यह भविष्य के संदर्भ का उपयोग टैगिंग या एन्कोडिंग के लिए कर सकता है, लेकिन जब भविष्य के इनपुट उपलब्ध नहीं होते तो कारणात्मक स्ट्रीमिंग के लिए अनुपयुक्त है।
सीक्वेंस-टू-सीक्वेंस मॉडल
एन्कोडर‑डिकोडर RNNs एक क्रम को दूसरे में मैप करते हैं। अटेंशन को इस तरह पेश किया गया कि डिकोडर एक स्थिर वेक्टर पर निर्भर रहने के बजाय विभिन्न एन्कोडर स्थितियों से परामर्श कर सके। इस कार्य ने ट्रांसफ़ॉर्मर आर्किटेक्चर को जन्म दिया, जिसने रीकरेंस को अटेंशन‑आधारित ब्लॉक्स से बदल दिया।
RNNs बनाम ट्रांसफ़ॉर्मर्स
ट्रांसफ़ॉर्मर्स प्रशिक्षण स्थितियों को समानांतर रूप से प्रोसेस करते हैं और दूरस्थ टोकनों के बीच छोटे अटेंशन पाथ बनाते हैं। RNNs स्थिति को क्रमिक रूप से प्रोसेस करते हैं, जिससे समानांतरता सीमित रहती है लेकिन स्ट्रीमिंग के दौरान स्थिर‑आकार की रीकरेंट स्थिति मिलती है। ट्रांसफ़ॉर्मर इनफ़रेंस को बढ़ते की‑वैल्यू कैश की आवश्यकता हो सकती है, जबकि RNN इतिहास को अपनी छिपी हुई स्थिति में संकुचित करता है और विवरण खो सकता है।
क्रम लंबाई, डेटा स्केल, हार्डवेयर, लेटेंसी, मेमोरी, और कार्य ऑफ़लाइन है या स्ट्रीमिंग, इन सभी के आधार पर चयन करें। हाइब्रिड और स्टेट‑स्पेस आर्किटेक्चर अतिरिक्त ट्रेड‑ऑफ़ प्रदान करते हैं।
वर्तमान उपयोग मामलों
RNNs और LSTMs पूर्वानुमान, विसंगति पहचान, सेंसर प्रोसेसिंग, स्पीच घटक, हस्तलेख, एम्बेडेड नियंत्रण, और कम‑लेटेंसी क्रम मॉडलिंग में प्रासंगिक बने हुए हैं। वे वर्तमान बड़े भाषा मॉडल या AI चैटबॉट्स के लिए डिफ़ॉल्ट व्याख्या नहीं हैं।
रीकरेंस, गेट्स, और क्रम स्मृति
एक रीकरेंट न्यूरल नेटवर्क वर्तमान इनपुट को पिछले चरणों से ले गई छिपी हुई स्थिति के साथ मिलाकर क्रम को प्रोसेस करता है। साझा वज़न चर क्रम की लंबाई को बदलने की अनुमति देते हैं, और अनरोलिंग समय के साथ गणना को प्रशिक्षण के लिए उजागर करता है। बुनियादी RNNs समयीय निर्भरताओं को दर्शा सकते हैं लेकिन ग्रेडिएंट्स को लंबी क्रमों में बार‑बार गुणा करने से वे वैनिश या एक्सप्लोड हो सकते हैं। ट्रंकेटेड बैकप्रॉपेगेशन मेमोरी और गणना को सीमित करता है, जबकि ग्रेडिएंट क्लिपिंग अत्यधिक अपडेट को नियंत्रित करता है। छिपी हुई स्थिति एक सीखा हुआ सारांश है, न कि प्रत्येक पूर्व टोकन का पूर्ण भंडारण।
लॉन्ग शॉर्ट-टर्म मेमोरी नेटवर्क सेल स्थिति तथा इनपुट, फ़रगेट, और आउटपुट गेट्स जोड़ते हैं जो लिखने, बरकरार रखने, और जानकारी उजागर करने को नियंत्रित करते हैं। गेटेड रीकरेंट यूनिट्स सरल रीसेट और अपडेट संरचना का उपयोग करते हैं। द्विदिश वैरिएंट्स भविष्य के संदर्भ का उपयोग करते हैं और इसलिए बिना देरी के कारणात्मक रूप से स्ट्रीम नहीं कर सकते। स्टैक्ड, रेज़िडुअल, और अटेंशन‑ऑगमेंटेड रीकरेंट मॉडल क्षमता जोड़ते हैं। पैडिंग और मास्क को सुनिश्चित करना चाहिए कि कृत्रिम क्रम तत्व स्थिति या लॉस को प्रभावित न करें, और वास्तविक क्रम सीमाओं पर स्थिति रीसेट होनी चाहिए ताकि उदाहरणों के बीच लीक न हो।
प्रशिक्षण, तुलना, और स्टेटफ़ुल सर्विंग
RNNs और LSTMs स्ट्रीमिंग, कॉम्पैक्ट ऑन‑डिवाइस मॉडल, टाइम‑सीरीज़, और उन कार्यभारों के लिए उपयोगी रहते हैं जहाँ क्रमिक स्थिति कुशल होती है। ट्रांसफ़ॉर्मर्स समानांतर प्रशिक्षण और लंबी दूरी की इंटरैक्शन को अलग तरीके से संभालते हैं लेकिन बड़े मेमोरी और कैश की आवश्यकता हो सकती है। आर्किटेक्चर को सटीकता, लेटेंसी, थ्रूपुट, मेमोरी, पावर, और क्रम लंबाई के साथ प्रदर्शन के आधार पर तुलना करें। रोलिंग टाइम स्प्लिट के साथ पूर्वानुमान, क्रम‑सजग मीट्रिक के साथ भाषा, और इवेंट‑लेवल माप के साथ विसंगति पहचान का मूल्यांकन करें। लंबी गैप, रीजन परिवर्तन, अनुपलब्ध सैंपल, और अचानक क्रम सीमाओं के बाद विफलता की जांच करें।
स्टेटफ़ुल डिप्लॉयमेंट को छिपी हुई स्थिति को सही सत्र से जोड़ना, समाप्त करना, संवेदनशील होने पर एन्क्रिप्ट करना, और त्रुटियों या मॉडल परिवर्तन के बाद रीसेट करना आवश्यक है। आउट‑ऑफ़‑ऑर्डर या डुप्लिकेट इवेंट्स स्थिति को भ्रष्ट कर सकते हैं; टाइमस्टैम्प, क्रम संख्या, और इडेम्पोटेंसी शामिल करें। स्थिति आयु, क्रम लंबाई, मिसिंगनेस, आउटपुट ड्रिफ्ट, और लेटेंसी की निगरानी करें। क्वांटाइज़ेशन को गेट‑सेंसिटिव वैलिडेशन की आवश्यकता होती है क्योंकि छोटे संख्यात्मक परिवर्तन समय के साथ जमा हो सकते हैं। RNN मेमोरी संदर्भ सक्षम करती है, लेकिन यह निजी या पुरानी जानकारी भी संरक्षित कर सकती है, इसलिए रिटेंशन और उपयोगकर्ता नियंत्रण डिज़ाइन में शामिल होने चाहिए।
व्यावहारिक उदाहरण: स्ट्रीमिंग सेंसर क्रमों के लिए LSTM
एक उपयोगिता हालिया माप, कैलेंडर, और मौसम से अल्पकालिक लोड का पूर्वानुमान करने के लिए LSTM का उपयोग करती है। क्रम सख्त समय क्रम में बनते हैं; फ़ीडर सीमाओं पर छिपी हुई स्थिति रीसेट होती है, और पैडिंग को मास्क किया जाता है। सीज़नल‑नैव और ग्रेडिएंट‑बूस्टेड बेसलाइन को रोलिंग विंडो में LSTM के साथ तुलना की जाती है। परीक्षण में मिसिंग इंटरवल, विलंबित मौसम, छुट्टियाँ, आउटेज, और सामान्य प्रशिक्षण से परे क्रम लंबाई शामिल हैं।
स्ट्रीमिंग सेवा स्थिति को एक फ़ीडर से जोड़ती है, आउट‑ऑफ़‑ऑर्डर डुप्लिकेट को अस्वीकार करती है, और लंबी गैप या मॉडल अपडेट के बाद स्थिति को समाप्त करती है। जब सेंसर या स्थिति अमान्य हों तो एक सुरक्षित सांख्यिकीय पूर्वानुमान आउटपुट को बदल देता है। क्वांटाइज़्ड इनफ़रेंस को लंबी क्रमों पर संचयी ड्रिफ्ट के लिए जाँचा जाता है। निगरानी स्थिति आयु, मिसिंगनेस, लेटेंसी, बायस, और इंटरवल त्रुटि को ट्रैक करती है। मॉडल केवल ग्रिड परिवर्तन के बाद पुनः प्रशिक्षित किया जाता है और परिणाम दर्शाते हैं कि सीखी गई समयिक संबंध अब सामान्यीकृत नहीं होते।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय केवल सफल प्रदर्शन से अधिक की आवश्यकता रखता है। इरादे वाले उपयोगकर्ता, संचालन पर्यावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादनीय बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, खराब या अनुपलब्ध इनपुट, वितरण शिफ्ट, निर्भरता आउटेज, दुरुपयोग, और सबसे अधिक अनसेव्ड समूहों या पर्यावरणों का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुंच, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन, थ्रेशहोल्ड, और परिणाम को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनः उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले रिलीज़, अपवाद, परिवर्तन, रोलबैक, और रिटायरमेंट के लिए अधिकार असाइन करें। एक चरणबद्ध रोलआउट, सुरक्षित फ़ॉलबैक रखें, और जानबूझकर डाली गई विफलताओं के साथ निगरानी को सत्यापित करें। परिचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम दिखाने चाहिए बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशहोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर डिप्लॉयमेंट के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें बजाय यह मानने के कि ऑफ़लाइन प्रदर्शन बना रहेगा। डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीति, हार्डवेयर, या उद्देश्य में परिवर्तन होने पर पुनः मूल्यांकन करें। एक रखरखाव प्रणाली को दस्तावेज़ित रिकवरी, घटना सीखना, विलोपन और रिटेंशन प्रक्रियाएँ, और स्पष्ट बिंदु चाहिए जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या LSTM हमेशा एक बुनियादी RNN से बेहतर होता है?
नहीं। गेटिंग कई लंबी‑निर्भरता समस्याओं में मदद करती है लेकिन गणना और पैरामीटर जोड़ती है। एक बुनियादी RNN छोटे, सरल क्रमों के लिए पर्याप्त हो सकता है, और बहुत लंबी संदर्भ के लिए कोई अन्य आर्किटेक्चर बेहतर हो सकता है।
क्या LSTM अनिश्चित इतिहास को प्रोसेस कर सकता है?
नहीं। इसकी स्थिति की क्षमता सीमित है, ग्रेडिएंट और प्रशिक्षण डेटा सीमाएँ लगाते हैं, और प्रासंगिक विवरण ओवरराइट हो सकते हैं। लंबी‑संदर्भ प्रदर्शन को आर्किटेक्चर के नाम से अनुमानित करने के बजाय मापना चाहिए।
प्राथमिक संदर्भ












