
एआई की मूल बातें
डीप रिइन्फोर्समेंट लर्निंग क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
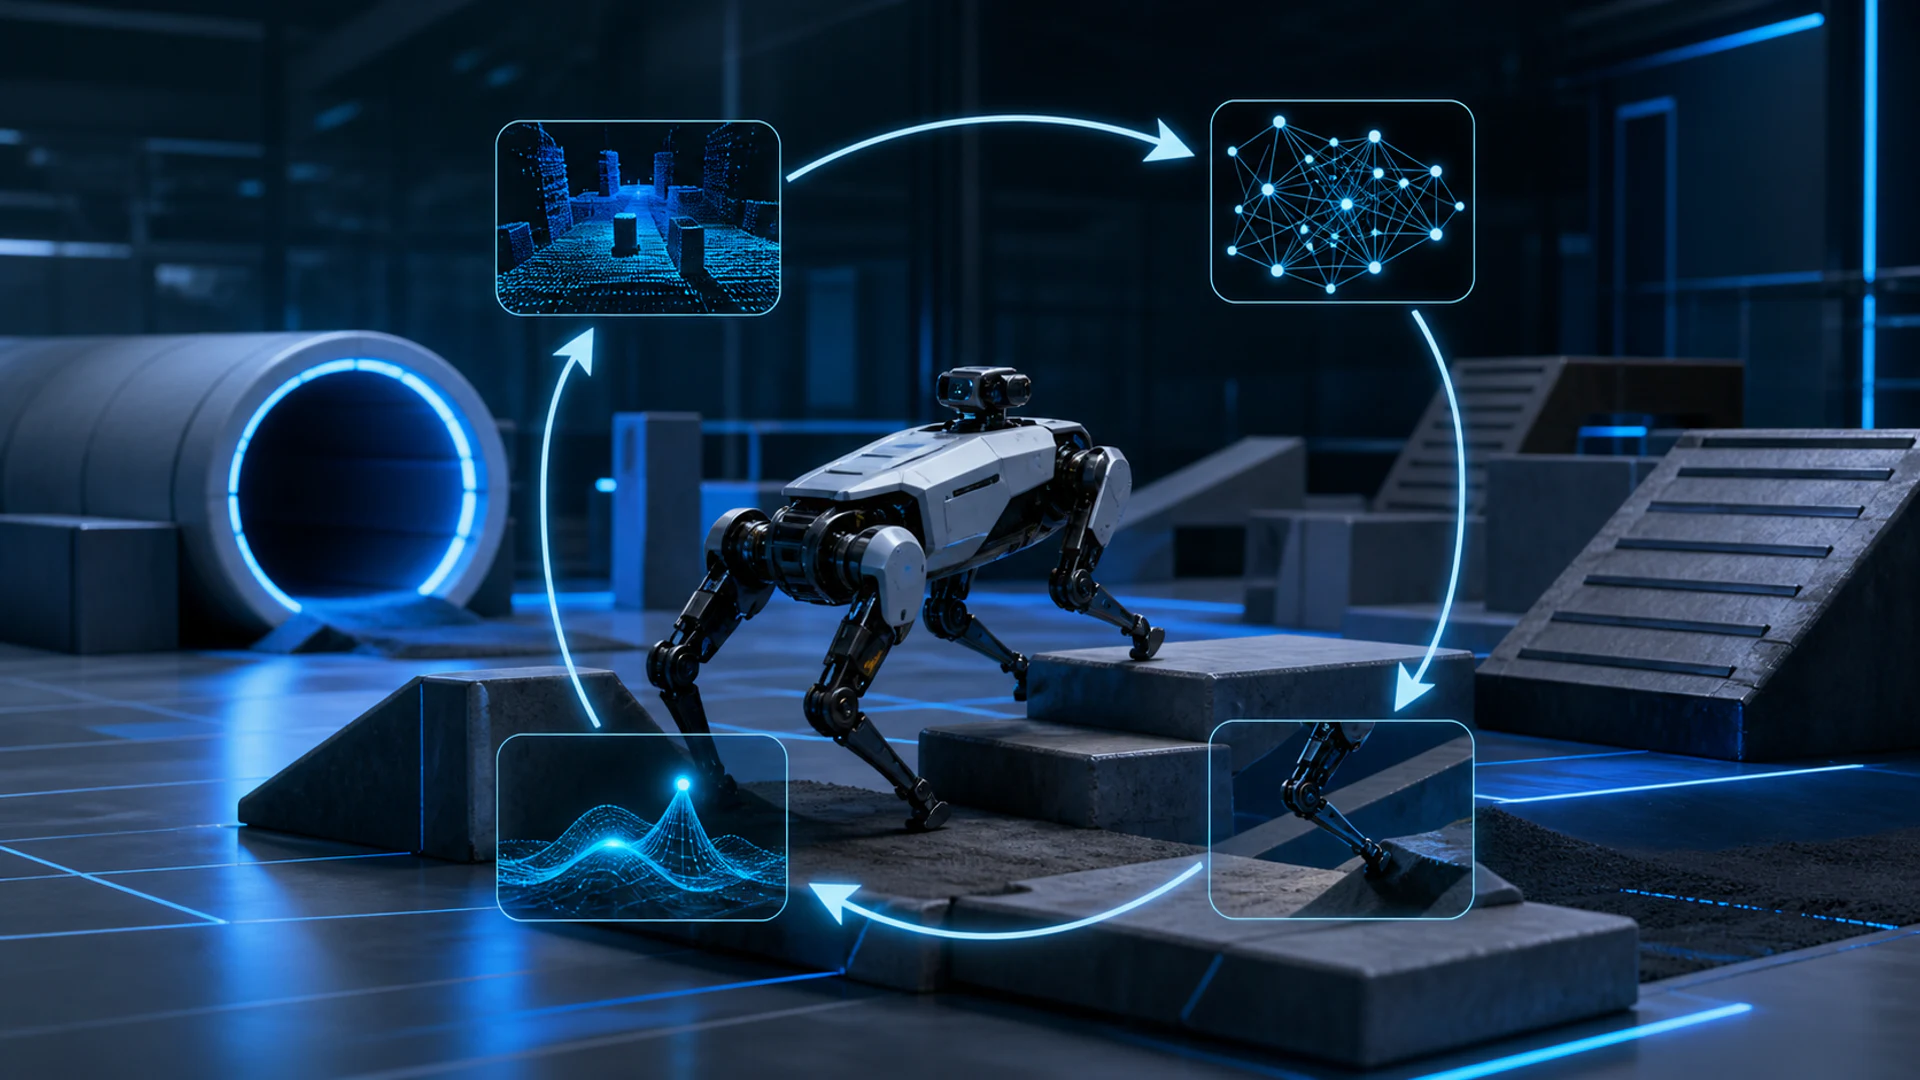
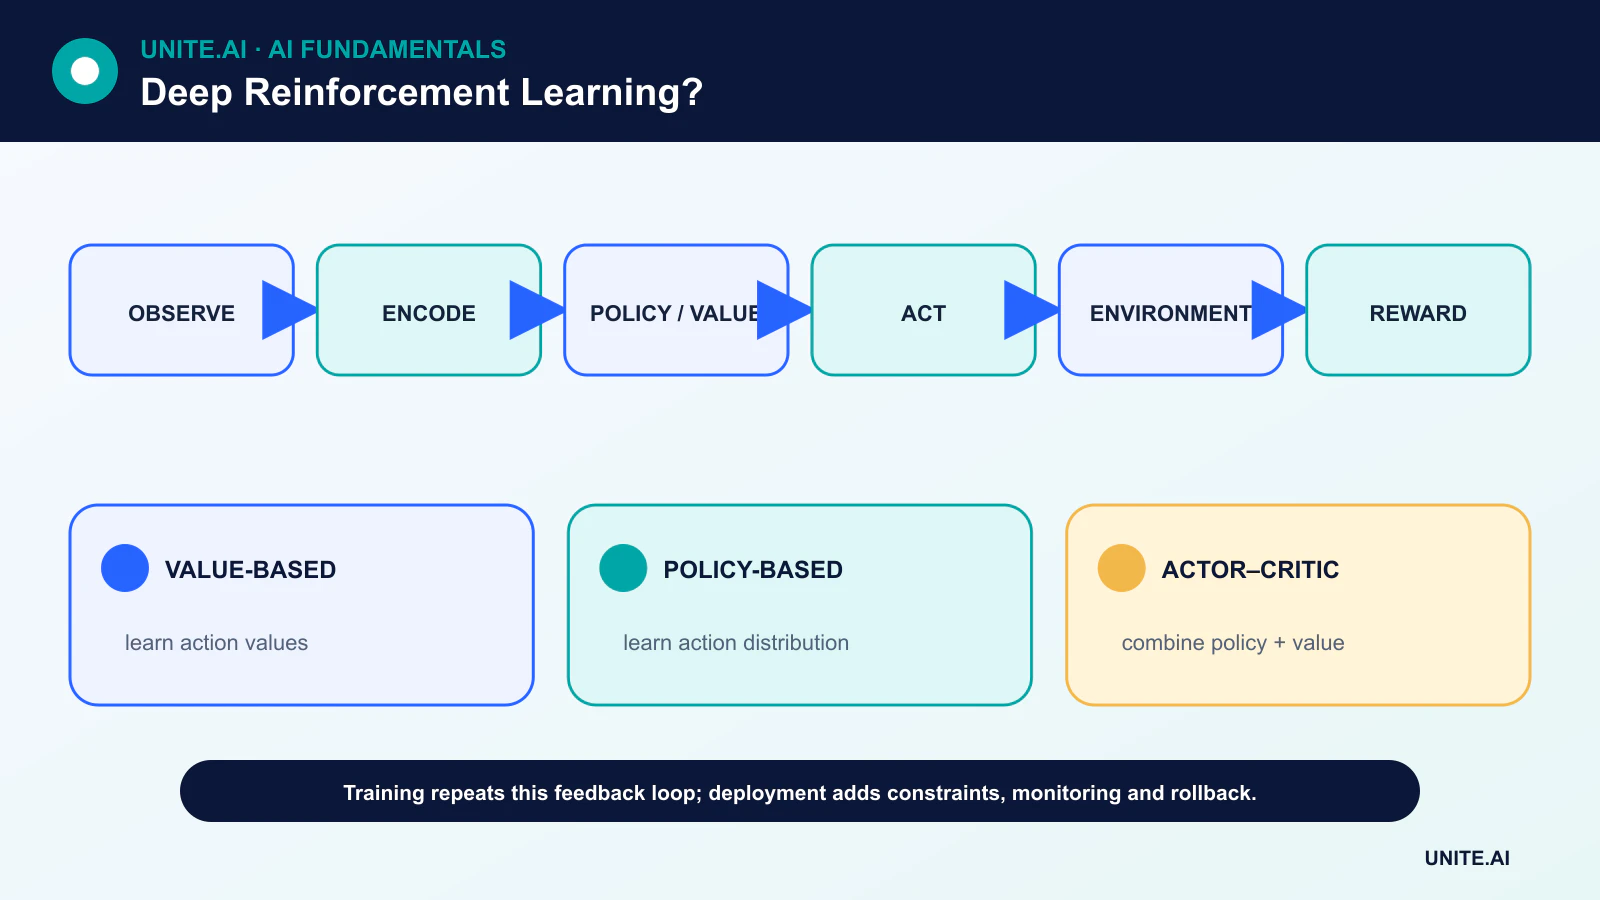
डीप रिइन्फोर्समेंट लर्निंग (डीप RL) रिइन्फोर्समेंट लर्निंग को डीप न्यूरल नेटवर्क्स के साथ जोड़ती है। एक एजेंट स्थिति को देखता है, एक कार्रवाई चुनता है, एक इनाम और नई अवलोकन प्राप्त करता है, फिर भविष्य के निर्णयों को सुधारने के लिए नीति या वैल्यू फ़ंक्शन को समायोजित करता है।
डीप नेटवर्क रिइन्फोर्समेंट लर्निंग की कठिन भागों को नहीं हटाता। यह छवियों, सेंसर स्ट्रीम, बड़े एक्शन स्पेस या जटिल वैल्यू फ़ंक्शनों को प्रतिनिधित्व करने का लचीला तरीका प्रदान करता है। खोज, विलंबित क्रेडिट, अस्थिर प्रशिक्षण और सुरक्षित वास्तविक‑विश्व मूल्यांकन अभी भी मुख्य इंजीनियरिंग समस्याएँ हैं।
मुख्य बिंदु
- डीप RL इंटरैक्शन से क्रमिक निर्णय सीखता है, न कि लेबल किए गए उदाहरणों की स्थिर तालिका से।
- वैल्यू‑आधारित विधियाँ कार्रवाई की गुणवत्ता का अनुमान लगाती हैं; पॉलिसी विधियाँ सीधे कार्रवाई वितरण सीखती हैं; एक्टर‑क्रिटिक विधियाँ दोनों को मिलाती हैं।
- रीप्ले बफ़र्स, टार्गेट नेटवर्क और सावधानीपूर्वक इनाम डिज़ाइन प्रशिक्षण को सुधार सकते हैं, लेकिन कोई भी विश्वसनीय व्यवहार की गारंटी नहीं देता।
- एक मजबूत सिम्युलेटर स्कोर मजबूती, सुरक्षा या भौतिक दुनिया में सफल ट्रांसफ़र का प्रमाण नहीं है।
निर्णय समस्या: अवस्थाएँ, क्रियाएँ और इनाम
कई डीप‑RL कार्यों को मार्कोव निर्णय प्रक्रिया के रूप में मॉडल किया जाता है। समय t पर, एजेंट स्थिति या अवलोकन st प्राप्त करता है, कार्रवाई at चुनता है, फिर इनाम rt+1 और अगली स्थिति प्राप्त करता है। लक्ष्य अपेक्षित डिस्काउंटेड रिटर्न है, न कि केवल अगला इनाम।
डिस्काउंट फ़ैक्टर यह नियंत्रित करता है कि दूरस्थ इनाम कितने महत्वपूर्ण हैं। एक रिवॉर्ड फ़ंक्शन निर्धारित करता है कि ऑप्टिमाइज़ेशन प्रक्रिया क्या追求 करेगी, इसलिए अधूरा प्रॉक्सी ऐसी व्यवहार उत्पन्न कर सकता है जो तकनीकी रूप से सफल हो लेकिन संचालनात्मक रूप से अवांछनीय हो। यही कारण है कि रिवॉर्ड डिज़ाइन और प्रतिबंध परीक्षण को मॉडल आर्किटेक्चर जितना ही ध्यान मिलना चाहिए।
वैल्यू‑आधारित, पॉलिसी‑आधारित और एक्टर‑क्रिटिक विधियाँ
वैल्यू‑आधारित एल्गोरिद्म स्थिति वैल्यू या एक्शन वैल्यू का अनुमान लगाता है। डीप Q‑नेटवर्क्स न्यूरल नेटवर्क का उपयोग करके Q‑वैल्यू को अनुमानित करते हैं और आमतौर पर कुछ खोज बनाए रखते हुए सबसे उच्च अनुमान वाली कार्रवाई चुनते हैं। पॉलिसी‑ग्रेडिएंट एल्गोरिद्म इसके बजाय एक पैरामीटराइज्ड पॉलिसी को अनुकूलित करता है जो कार्रवाई वितरण आउटपुट करता है।
एक्टर‑क्रिटिक सिस्टम दोनों एक्टर (जो कार्रवाई प्रस्तावित करता है) और क्रिटिक (जो उनकी वैल्यू का अनुमान लगाता है) को बनाए रखते हैं। यह डिज़ाइन सतत नियंत्रण का समर्थन करता है लेकिन अनुमान त्रुटियों के अंतर्संबंधित स्रोतों को प्रस्तुत करता है। इसलिए डीप RL उसी आधार पर निर्भर करता है जैसे डीप लर्निंग, ग्रेडिएंट डिसेंट और बैकप्रॉपेगेशन।
रीप्ले बफ़र्स और टार्गेट नेटवर्क मदद क्यों करते हैं
लगातार अनुभव नमूने परस्पर संबंधित होते हैं, जबकि नेटवर्क अपडेट बाद के अपडेट्स द्वारा उपयोग किए जाने वाले टार्गेट को बदलता है। एक्सपीरियंस रीप्ले पुराने ट्रांज़िशन को सैंपल करके इस समयिक संबंध को तोड़ता है। टार्गेट नेटवर्क ऑनलाइन नेटवर्क की तुलना में धीरे‑धीरे बदलता है, जिससे बूटस्ट्रैप्ड टार्गेट कम अस्थिर होते हैं।
ये तंत्र प्रशिक्षण स्थिरता को सुधारते हैं, लेकिन ट्यूनिंग अभी भी महत्वपूर्ण है। लर्निंग रेट, खोज शेड्यूल, रिवॉर्ड स्केल, रीप्ले संरचना और नेटवर्क क्षमता सभी परिणाम को बदल सकते हैं। कई रैंडम सीड्स की रिपोर्ट की जानी चाहिए क्योंकि एकल रन भ्रामक हो सकता है।
ऑफ़लाइन RL, मॉडल‑आधारित RL और सिम‑टू‑रियल
ऑफ़लाइन RL एक स्थिर लॉग्ड डेटासेट से नई इंटरैक्शन एकत्र किए बिना सीखता है। यह तब उपयोगी हो सकता है जब खोज महंगी या असुरक्षित हो, लेकिन नीति को उन कार्रवाइयों से बचना चाहिए जो लॉग में ठीक से प्रतिनिधित्व नहीं हैं। मॉडल‑आधारित RL एक ट्रांज़िशन मॉडल सीखता या उपयोग करता है योजना बनाने के लिए, अतिरिक्त धारणाओं का आदान‑प्रदान करके सैंपल दक्षता प्राप्त करता है।
रोबोटिक्स अक्सर सिमुलेशन में प्रशिक्षण लेती है, भौतिक पैरामीटर को रैंडमाइज़ करती है, फिर हार्डवेयर पर फाइन‑ट्यून या वैलिडेट करती है। वास्तविकता अंतर अभी भी परसेप्शन, टाइमिंग, संपर्क डायनेमिक्स और अनमॉडेल्ड एज केस में त्रुटियों को उजागर कर सकता है। एक रिइन्फोर्समेंट‑लर्निंग सिस्टम को व्यवधान, वितरण परिवर्तन और स्पष्ट सुरक्षा प्रतिबंधों के तहत मूल्यांकन किया जाना चाहिए।
मूल्यांकन और डिप्लॉयमेंट
उपयोगी मूल्यांकन प्रशिक्षण और परीक्षण वातावरण को अलग करता है, केवल सर्वोत्तम स्कोर के बजाय रिटर्न वितरण रिपोर्ट करता है, और प्रतिबंध उल्लंघन, हस्तक्षेप आवृत्ति और सबसे बुरे मामले के व्यवहार की जाँच करता है। वास्तविक सिस्टम के लिए, टीमों को मॉनिटरिंग, रोलबैक प्रक्रियाएँ, सीमित एक्शन स्पेस और मानव ओवरराइड की भी आवश्यकता होती है।
डीप RL सबसे आकर्षक तब होता है जब निर्णय क्रमिक होते हैं, फीडबैक उपलब्ध होता है और हाथ से लिखे नियंत्रण नियम अपर्याप्त होते हैं। यह तब खराब विकल्प है जब सुपरवाइज़्ड लेबल प्रचुर मात्रा में होते हैं, एक पारम्परिक ऑप्टिमाइज़र समस्या हल करता है, या खोज लोगों या संपत्तियों को जोखिम में डालती है।
डीप RL आर्किटेक्चर और प्रशिक्षण संकेत
डीप रिइन्फोर्समेंट लर्निंग वैल्यू फ़ंक्शन, पॉलिसी, एनवायरनमेंट मॉडल या इनके संयोजन को प्रतिनिधित्व करने के लिए न्यूरल नेटवर्क्स का उपयोग करती है। एक डीप Q‑नेटवर्क कार्रवाई वैल्यू की भविष्यवाणी करता है और टेम्पोरल‑डिफरेंस टार्गेट से सीखता है; एक्सपीरियंस रीप्ले अपडेट्स के बीच संबंध को कम करता है, जबकि टार्गेट नेटवर्क चल रहे उद्देश्य को स्थिर करता है। पॉलिसी‑ग्रेडिएंट विधियाँ अपेक्षित रिटर्न को सीधे अनुकूलित करती हैं, और एक्टर‑क्रिटिक विधियाँ ग्रेडिएंट वैरिएंस को कम करने के लिए सीखे हुए क्रिटिक का उपयोग करती हैं। सतत कार्रवाई अक्सर निर्धारक या स्टोकेस्टिक एक्टर‑क्रिटिक वैरिएंट की आवश्यकता रखती है, जबकि डिस्क्रीट उच्च‑डायमेंशनल कार्रवाई को सावधानीपूर्ण खोज और आउटपुट डिज़ाइन की जरूरत होती है।
प्रशिक्षण गैर‑स्थिर है क्योंकि पॉलिसी वह डेटा बदल देती है जो वह एकत्र करती है। रीप्ले डेटा ऑफ‑पॉलिसी हो जाता है, बूटस्ट्रैप्ड टार्गेट वर्तमान अनुमान पर निर्भर करता है, और फ़ंक्शन एप्रॉक्सिमेशन त्रुटियों को बढ़ा सकता है—जिस संयोजन को कभी‑कभी डेडली ट्रायड कहा जाता है। डबल एस्टिमेटर्स वैल्यू ओवरएस्टिमेशन को कम करते हैं; एडवांटेज फ़ंक्शन क्रेडिट असाइनमेंट को सुधारते हैं; एंट्रॉपी बोनस खोज को प्रोत्साहित करते हैं; क्लिप्ड ऑब्जेक्टिव्स विनाशकारी पॉलिसी अपडेट को सीमित करते हैं। केवल लीकेज‑सेफ स्टेट के साथ अवलोकन और इनाम को सामान्यीकृत करें, और एनवायरनमेंट, रैपर, एक्शन रिपीट, टर्मिनेशन, और रिवॉर्ड प्री‑प्रोसेसिंग को रिकॉर्ड करें क्योंकि प्रत्येक समस्या को बदलता है।
मूल्यांकन, सिम्युलेटर, और डिप्लॉयमेंट सुरक्षा
स्वतंत्र सीड्स और एनवायरनमेंट इंस्टेंसेस में रिटर्न वितरण रिपोर्ट करें, न कि सर्वश्रेष्ठ रन। सैंपल दक्षता, प्रतिबंध उल्लंघन, आपदा परिणाम, रिवॉर्ड स्केल के प्रति संवेदनशीलता, और अवलोकन शोर, देरी, एक्ट्यूएटर त्रुटि और बदलती डायनेमिक्स के प्रति मजबूती का मूल्यांकन करें। स्क्रिप्टेड कंट्रोल, क्लासिकल कंट्रोल, सुपरवाइज़्ड इमीटेशन और सरल RL के साथ तुलना करें। एनवायरनमेंट वैरिएशन्स को होल्ड‑आउट करें और रिवॉर्ड‑फ़्री आउटपुट मेट्रिक्स का परीक्षण करें, क्योंकि एजेंट प्रोग्राम्ड रिवॉर्ड का शोषण कर सकता है जबकि इच्छित कार्य में विफल रहता है। वीडियो और ट्रैजेक्टरी निरीक्षण अक्सर समग्र रिटर्न द्वारा छिपे व्यवहार को उजागर करते हैं।
सिमुलेशन खोज को सक्षम करता है लेकिन वास्तविकता अंतर प्रस्तुत करता है। संबंधित भौतिकी और परसेप्शन को रैंडमाइज़ करें, वास्तविक माप के खिलाफ कैलिब्रेट करें, और रूढ़िवादी ट्रांसफ़र उपयोग करें। लॉग्ड‑डेटा या ऑफ़लाइन RL ऑनलाइन खोज से बचता है लेकिन व्यवहार पॉलिसी द्वारा असमर्थित कार्रवाइयों का विश्वसनीय मूल्यांकन नहीं कर सकता। प्रोडक्शन सिस्टम को एक्शन सेट, रेट, संसाधन और ऑपरेटिंग एन्क्लोज़र को सीमित करना चाहिए; हाई‑इम्पैक्ट एक्शन्स के लिए अनुमोदन आवश्यक है; और एक सत्यापित सुरक्षित कंट्रोलर या स्टॉप शामिल होना चाहिए। पॉलिसी इनपुट, एक्शन वितरण, रिवॉर्ड, वास्तविक परिणाम और हस्तक्षेपों की मॉनिटरिंग करें, और परीक्षण किए गए पॉलिसी संस्करण पर रोलबैक रखें।
एक ठोस नियंत्रण उदाहरण
वेयरहाउस रोबोट रूटिंग के लिए, स्थिति को स्थान, लोड, बैटरी, निकटवर्ती ट्रैफ़िक और टास्क क्यू से परिभाषित करें; कार्रवाइयाँ अनुमति प्राप्त मूवमेंट और चार्जिंग निर्णयों से; और इनाम को पूर्ण कार्य, ऊर्जा, भीड़भाड़ और सुरक्षा प्रतिबंधों से निर्धारित करें। पहले एक कैलिब्रेटेड सिम्युलेटर में रैंडमाइज़्ड डिमांड और सेंसर फॉल्ट के साथ प्रशिक्षण दें, फिर वास्तविक निर्णयों का शैडो बनाएं। कभी भी सीखी गई पॉलिसी को टकराव बचाव को बायपास न करने दें। थ्रूपुट को निकट‑मिस, डेडलॉक्स, बैटरी इमरजेंसी और सबसे बुरे देरी के साथ मूल्यांकन करें। परियोजना तभी सफल होगी जब परतदार सिस्टम संचालन को सुधारता है बिना लोगों या उपकरणों को अस्वीकार्य खोज जोखिम स्थानांतरित किए।
व्यावहारिक उदाहरण: डेटा‑सेंटर कूलिंग के लिए DRL
एक डेटा सेंटर RL एजेंट को अनुमोदित कूलिंग सेटपॉइंट्स तक सीमित करता है और इसे ऐतिहासिक मौसम, वर्कलोड, तापमान और उपकरण प्रतिक्रिया से कैलिब्रेटेड सिम्युलेटर में प्रशिक्षित करता है। इनाम में ऊर्जा शामिल है लेकिन कठोर प्रतिबंध अलग‑से तापमान, आर्द्रता और उपकरण साइक्लिंग की रक्षा करते हैं। मॉडल‑प्रेडिक्टिव कंट्रोल और मौजूदा नियम बेंचमार्क हैं। मूल्यांकन मौसम, सेंसर शोर, एक्ट्यूएटर देरी, उपकरण नुकसान, असामान्य लोड और कई सीड्स को कवर करता है, ऊर्जा, उल्लंघन, वैरिएंस और रिकवरी रिपोर्ट करता है।
सीखी गई पॉलिसी सीमित ज़ोन ट्रायल से पहले शैडो मोड में चलती है। एक बाहरी सुरक्षा कंट्रोलर कार्रवाइयों को क्लिप करता है और ऑपरेटर ओवरराइड कर सकते हैं। एक्शन रेट, स्थिति कवरेज, मॉडल अनिश्चितता और वास्तविक सुविधा परिणामों की मॉनिटरिंग की जाती है; सिम्युलेटर मिसमैच या दोहराए गए हस्तक्षेप रोलबैक को ट्रिगर करते हैं। अपडेटेड उपकरण या कंट्रोल लॉजिक एक नया एनवायरनमेंट संस्करण और वैलिडेशन बनाते हैं। ऊर्जा बचत केवल तभी स्वीकार की जाती है जब विश्वसनीयता, थर्मल मार्जिन, रखरखाव और फॉल्ट प्रतिक्रिया बेसलाइन जितनी ही मजबूत हों।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक प्रोडक्शन निर्णय को केवल सफल डेमॉन्स्ट्रेशन से अधिक चाहिए। इच्छित उपयोगकर्ता, ऑपरेटिंग एनवायरनमेंट, इनपुट, आउटपुट, निर्भरताएँ, मालिक और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले पुनरुत्पादनीय बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा शर्तों, विकृत या अनुपलब्ध इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग और सबसे अधिक उपेक्षित समूहों या वातावरणों का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुन: उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, बदलाव, रोलबैक और रिटायरमेंट के लिए अधिकार सौंपें। एक चरणबद्ध रोलआउट उपयोग करें, एक सुरक्षित फॉलबैक रखें, और जानबूझकर इंजेक्टेड फेल्योर के साथ मॉनिटरिंग को सत्यापित करें। ऑपरेशनल टेलीमेट्री को इनपुट क्वालिटी, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और रिस्पॉन्स ओनर निर्धारित करें, फिर डिप्लॉयमेंट के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, न कि यह मानते हुए कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियां, हार्डवेयर या उद्देश्य बदलें, पुनः मूल्यांकन करें। एक रखरखाव किया गया सिस्टम दस्तावेज़ित रिकवरी, घटना सीखना, डिलीशन और रिटेंशन प्रक्रियाओं, और एक स्पष्ट बिंदु की भी आवश्यकता रखता है जहाँ इसे निष्क्रिय या बदलना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या डीप रिइन्फोर्समेंट लर्निंग डीप लर्निंग के समान है?
नहीं। डीप लर्निंग फ़ंक्शन अप्रोक्सिमेटर प्रदान करती है; रिइन्फोर्समेंट लर्निंग इंटरैक्शन, इनाम और क्रमिक‑निर्णय लक्ष्य प्रदान करती है।
क्या उच्च इनाम का अर्थ है कि एजेंट ने इच्छित व्यवहार सीखा?
ज़रूरी नहीं। इसका मतलब है कि पॉलिसी ने ऐसा व्यवहार पाया जो लागू किए गए इनाम और वातावरण के तहत अच्छा स्कोर करता है। स्वतंत्र सुरक्षा और लक्ष्य‑संगति परीक्षण अभी भी आवश्यक हैं।
मुख्य संदर्भ












