
एआई की मूल बातें
ग्रेडिएंट डिसेंट क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
Gradient descent एक अनुकूलन विधि है जो मॉडल पैरामीटरों को समायोजित करके उद्देश्य फ़ंक्शन को घटाती है। न्यूरल नेटवर्क प्रशिक्षण में, यह उद्देश्य आमतौर पर उदाहरणों पर गणना किया गया लॉस होता है। ग्रेडिएंट स्थानीय रूप से सबसे तेज़ वृद्धि की दिशा में इंगित करता है, इसलिए ग्रेडिएंट डिसेंट विपरीत दिशा में एक कदम लेता है।
ग्रेडिएंट स्थानीय संवेदनशीलता को वर्णित करता है; इसका परिमाण यह माप नहीं है कि मॉडल कितनी तेज़ी से “सीख रहा” है। वास्तविक प्रगति सीखने की दर, वक्रता, शोर, पैरामीटराइजेशन, ऑप्टिमाइज़र स्थिति और डेटा पर भी निर्भर करती है।
मुख्य बिंदु
- Backpropagation ग्रेडिएंट की गणना करता है, जबकि ग्रेडिएंट डिसेंट उनका उपयोग पैरामीटर अपडेट करने के लिए करता है।
- मिनी‑बैच अनुकूलन डीप लर्निंग के लिए मानक व्यावहारिक दृष्टिकोण है।
- सीखने की दर अपडेट के पैमाने को नियंत्रित करती है और हर कदम के बाद घटने के बजाय एक अनुसूची का पालन कर सकती है।
- मॉमेंटम, AdamW, क्लिपिंग, और नॉर्मलाइज़ेशन विभिन्न अनुकूलन समस्याओं को संबोधित करते हैं।
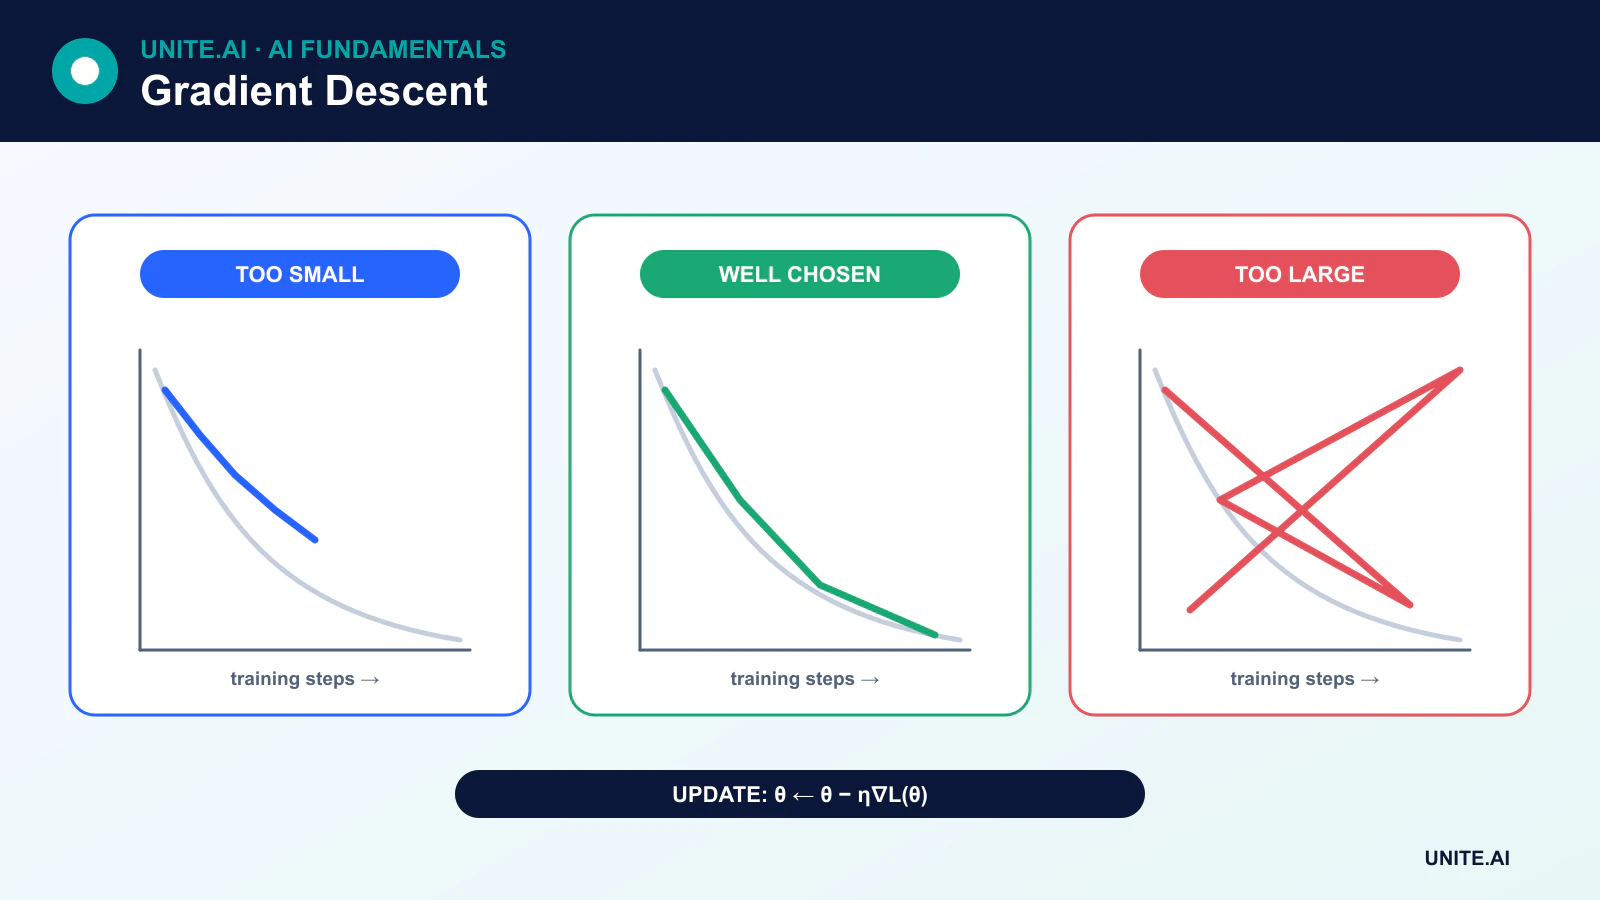
बुनियादी अद्यतन नियम
पैरामीटर वेक्टर θ, सीखने की दर η, और लॉस L:
θ ← θ - η∇L(θ)
ग्रेडिएंट ∇L(θ) प्रत्येक पैरामीटर के लिए एक आंशिक अवकलन रखता है। इसे घटाने से स्थानीय रूप से नीचे की ओर गति होती है। एक स्थिर बिंदु का ग्रेडिएंट शून्य होता है, लेकिन यह न्यूनतम, अधिकतम, सैडल पॉइंट या सपाट क्षेत्र हो सकता है। डीप‑लर्निंग लॉस सतहें गैर‑उभयात्मक (nonconvex) होती हैं, इसलिए प्रशिक्षण यह सुनिश्चित नहीं करता कि वह एक अनोखा ग्लोबल न्यूनतम या शून्य लॉस पाए।
बैच, स्टोकैस्टिक, और मिनी‑बैच विधियां
बैच ग्रेडिएंट डिसेंट
बैच ग्रेडिएंट डिसेंट हर अपडेट के लिए पूरे प्रशिक्षण सेट का उपयोग करके ग्रेडिएंट की गणना करता है। यह अनुमान स्थिर होता है लेकिन समय और मेमोरी दोनों में महंगा हो सकता है, और एक अपडेट आधुनिक एक्सेलेरेटरों का पूरी तरह उपयोग नहीं कर सकता।
स्टोकैस्टिक ग्रेडिएंट डिसेंट
सख्त स्टोकैस्टिक ग्रेडिएंट डिसेंट प्रत्येक अपडेट में एक यादृच्छिक रूप से चुना गया उदाहरण उपयोग करता है। इसके ग्रेडिएंट शोरयुक्त होते हैं, जो लॉस सतह की खोज में मदद कर सकते हैं, लेकिन एकल‑उदाहरण संचालन समानांतर हार्डवेयर पर अक्षम हो सकते हैं।
मिनी‑बैच ग्रेडिएंट डिसेंट
मिनी‑बैच प्रशिक्षण उदाहरणों के एक उपसमुच्चय से ग्रेडिएंट का अनुमान लगाता है। यह सांख्यिकीय शोर को कुशल मैट्रिक्स ऑपरेशनों के साथ संतुलित करता है और डीप लर्निंग में सामान्य दृष्टिकोण है। बैच आकार मेमोरी, थ्रूपुट, ग्रेडिएंट शोर, नॉर्मलाइज़ेशन और कभी‑कभी जनरलाइज़ेशन को प्रभावित करता है।
सीखने की दर चुनना
बहुत बड़ी दर उपयोगी क्षेत्रों को ओवरशूट कर सकती है या विचलन का कारण बन सकती है। बहुत छोटी दर प्रशिक्षण को अव्यावहारिक रूप से धीमा बना सकती है या सपाट क्षेत्रों में ठहर सकती है। सर्वोत्तम पैमाना ऑप्टिमाइज़र, बैच आकार, मॉडल, प्रारंभिककरण और उद्देश्य पर निर्भर करता है।
अनुसूचियां धीरे‑धीरे वार्म‑अप हो सकती हैं, माइलस्टोन पर घट सकती हैं, कोसाइन वक्र का अनुसरण कर सकती हैं, या वैलिडेशन प्रगति पर प्रतिक्रिया दे सकती हैं। दर को हर अपडेट के बाद क्रमिक रूप से घटाने की आवश्यकता नहीं है। वार्म रिस्टार्ट और चक्रात्मक अनुसूचियां प्रशिक्षण के कुछ हिस्सों में जानबूझकर इसे बढ़ाती हैं।
मॉमेंटम
मॉमेंटम पिछले ग्रेडिएंटों का घातीय चल औसत बनाए रखता है। यह सुसंगत दिशाओं में प्रगति को तेज़ कर सकता है और तीव्र, संकीर्ण दिशाओं में दोलन को कम कर सकता है। नेस्टेरोव‑शैली का मॉमेंटम मॉमेंटम दिशा में आगे देख कर ग्रेडिएंट का मूल्यांकन या अनुमान लगाता है।
अनुकूली ऑप्टिमाइज़र
RMSProp वर्गीकृत ग्रेडिएंटों के चल औसत का उपयोग करके अपडेट को स्केल करता है। Adam मोमेंटम‑समतुल्य प्रथम मोमेंट्स को द्वितीय मोमेंट स्केलिंग के साथ मिलाता है। AdamW अनुकूलित ग्रेडिएंट अपडेट से वेट डिके को अलग करता है और ट्रांसफ़ॉर्मर में व्यापक रूप से उपयोग किया जाता है।
अनुकूली ऑप्टिमाइज़र अक्सर शुरुआती प्रशिक्षण को आसान बनाते हैं, लेकिन वे हर मॉडल या अंतिम जनरलाइज़ेशन लक्ष्य के लिए स्वचालित रूप से श्रेष्ठ नहीं होते। ऑप्टिमाइज़र तुलना के लिए समान अनुसूचियां और सावधानीपूर्ण ट्यूनिंग आवश्यक है।
ग्रेडिएंट क्लिपिंग और एग्रीगेशन
ग्रेडिएंट क्लिपिंग ग्रेडिएंट के मान या नॉर्म को सीमित करता है ताकि विस्फोटक ग्रेडिएंटों का प्रभाव कम हो, विशेषकर पुनरावर्ती या अस्थिर प्रशिक्षण में। ग्रेडिएंट एग्रीगेशन कई छोटे बैचों में ग्रेडिएंट को जोड़ता है इससे पहले कि अपडेट किया जाए, जिससे मेमोरी सीमित होने पर बड़े प्रभावी बैच का अनुमान लगाया जा सके।
अनुकूलन की निगरानी
प्रशिक्षण और वैलिडेशन लॉस, टास्क मीट्रिक्स, सीखने की दर, ग्रेडिएंट नॉर्म, पैरामीटर नॉर्म, और संख्यात्मक त्रुटियों को ट्रैक करें। प्रशिक्षण लॉस घटते हुए और वैलिडेशन प्रदर्शन बिगड़ते हुए ओवरफिटिंग का संकेत देता है, न कि एक अनुकूलन सफलता जिसे स्वचालित रूप से जारी रखना चाहिए।
अनुकूलन उसे दिया गया उद्देश्य न्यूनतम करता है। कम लॉस यह प्रमाणित नहीं करता कि डेटा, मीट्रिक, या वास्तविक‑विश्व व्यवहार उपयुक्त है। डेटा लीक, खराब लेबल, और असंगत उद्देश्य एक अच्छी तरह से अनुकूलित लेकिन हानिकारक मॉडल उत्पन्न कर सकते हैं।
अनुकूलन ज्यामिति और अद्यतन नियम
ग्रेडिएंट डिसेंट लॉस के ग्रेडिएंट के विपरीत पैरामीटर अपडेट करता है। फुल‑बैच डिसेंट प्रत्येक चरण में सभी प्रशिक्षण उदाहरणों का उपयोग करता है; स्टोकैस्टिक डिसेंट एक का; मिनी‑बैच विधियां उपसमुच्चय से ग्रेडिएंट का अनुमान लगाती हैं और डीप लर्निंग में प्रमुख हैं। सीखने की दर चरण के पैमाने को निर्धारित करती है। बहुत छोटी दर गणना बर्बाद करती है या ठहराव लाती है; बहुत बड़ी दर दोलन या विचलन पैदा करती है। मॉमेंटम एक चल दिशा को संग्रहीत करता है, जबकि Adam जैसी अनुकूली विधियां ग्रेडिएंट मोमेंट्स का उपयोग करके निर्देशांक को स्केल करती हैं। इनके विभिन्न अप्रत्यक्ष पक्षपात समान प्रशिक्षण लॉस वाले लेकिन विभिन्न जनरलाइज़ेशन वाले मॉडल उत्पन्न कर सकते हैं।
न्यूरल नेटवर्क में लॉस सतहें सपाट और तीव्र क्षेत्रों, सैडल, समरूपता, और खराब कंडीशन वाली दिशाओं को शामिल करती हैं। फीचर स्केलिंग, नॉर्मलाइज़ेशन, प्रारंभिककरण, रेजिडुअल कनेक्शन, और प्रीकंडिशनिंग ऑप्टिमाइज़र द्वारा देखी गई ज्यामिति को बदलते हैं। अनुसूचियां धीरे‑धीरे वार्म‑अप, घटाव, चक्र या प्लेटॉज़ पर प्रतिक्रिया कर सकती हैं। कुछ अनुकूली ऑप्टिमाइज़र में वेट डिके केवल L2 पेनल्टी जोड़ने से अलग होता है। बैच आकार शोर, मेमोरी, समानांतरता और सीखने‑दर क्षेत्र को प्रभावित करता है, इसलिए ऑप्टिमाइज़र तुलना के लिए समान प्रशिक्षण बजट और सावधानीपूर्ण ट्यूनिंग आवश्यक है।
निदान, पुनरुत्पादनशीलता, और रोकना
प्रशिक्षण और वैलिडेशन लॉस, टास्क मीट्रिक्स, ग्रेडिएंट और पैरामीटर नॉर्म, सीखने की दर, थ्रूपुट, और संख्यात्मक चेतावनियों को ट्रैक करें। विचलन भ्रष्ट बैच, अमान्य लेबल, अस्थिर मिश्रित प्रिसीजन, या गलत लॉस रिडक्शन से उत्पन्न हो सकता है। प्लेटॉज़ अंडर‑कैपेसिटी, संतृप्त एक्टिवेशन, खराब फीचर, अत्यधिक रेग्युलराइज़ेशन, या अनुसूची समस्या का संकेत दे सकते हैं। ओवरफिटिंग के लिए डेटा, ऑग्मेंटेशन, रेग्युलराइज़ेशन, या अर्ली स्टॉपिंग की आवश्यकता होती है—न कि यह दावा कि ऑप्टिमाइज़र विफल हुआ। प्रतिनिधि त्रुटियों का निरीक्षण करें और प्रशिक्षण जटिलता बढ़ाने से पहले एक सरल बेसलाइन से तुलना करें।
पुनरुत्पादनशीलता के लिए सीड, डेटा क्रम, कोड, कॉन्फ़िगरेशन, हार्डवेयर और लाइब्रेरी संस्करण आवश्यक होते हैं, हालांकि कुछ एक्सेलेरेटर कर्नेल नॉन‑डिटर्मिनिस्टिक रहते हैं। ऑप्टिमाइज़र और शेड्यूलर स्थिति के साथ चेकपॉइंट सहेजें ताकि प्रशिक्षण सुसंगत रूप से फिर से शुरू हो सके। पहले से तय वैलिडेशन मानदंडों के आधार पर एक चेकपॉइंट चुनें और एक अपरिवर्तित टेस्ट सेट रखें। वितरित प्रशिक्षण में प्रभावी बैच आकार, ग्रेडिएंट औसत, और विफल वर्कर के संभाल को पुष्टि करें। अनुकूलन उपलब्ध डेटा पर चुने हुए उद्देश्य को न्यूनतम करता है; यह कैलिब्रेटेड प्रॉबेबिलिटी, कारणात्मक तर्क, निष्पक्षता, सुरक्षा, या वास्तविक‑विश्व उपयोगिता की गारंटी नहीं देता।
व्यावहारिक उदाहरण: भाषा मॉडल के लिए ऑप्टिमाइज़र ट्यून करना
एक टीम टोकनाइज़र, डेटा क्रम, मॉडल, प्रभावी बैच, और प्रशिक्षण‑टोकन बजट को स्थिर करती है, फिर विश्वसनीय सीखने‑दर अनुसूचियों के तहत मोमेंटम वाले SGD और AdamW की तुलना करती है। वार्म‑अप, घटाव, वेट डिके, क्लिपिंग, और प्रिसीजन को लॉग किया जाता है। प्रत्येक उम्मीदवार कई सीड चलाता है, और वैलिडेशन एक अलग समय स्लाइस प्लस टास्क मूल्यांकन का उपयोग करता है। थ्रूपुट और ऊर्जा को लॉस के साथ रिपोर्ट किया जाता है ताकि थोड़ा बेहतर ऑप्टिमाइज़र असंगत लागत पर न चुना जाए।
डायग्नॉस्टिक्स यह उजागर करते हैं कि अस्थिरता एक डेटा शार्ड, अत्यधिक स्टेप साइज, अंडरफ़्लो, या मॉडल आर्किटेक्चर में से कहीं से उत्पन्न होती है। चेकपॉइंट ऑप्टिमाइज़र और शेड्यूलर स्थिति को संरक्षित करते हैं और परीक्षण में फिर से शुरू किए जाते हैं। अंतिम चयन वैलिडेशन गुणवत्ता और मजबूती पर आधारित होता है, न कि सबसे कम प्रशिक्षण लॉस पर। चयन के बाद एक सील्ड टेस्ट सेट एक बार चलाया जाता है। प्रोडक्शन इनफ़रेंस अलग से कैलिब्रेटेड और मॉनिटर किया जाता है क्योंकि प्री‑ट्रेनिंग के दौरान ऑप्टिमाइज़र की सफलता सुरक्षित या सत्य व्यवहार स्थापित नहीं करती।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय को केवल सफल प्रदर्शन से अधिक की आवश्यकता होती है। इच्छित उपयोगकर्ताओं, संचालन पर्यावरण, इनपुट, आउटपुट, निर्भरताओं, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादनीय बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपलब्ध इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग, और सबसे अधिक उपेक्षित समूहों या पर्यावरणों का परीक्षण करें। टास्क गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनरुत्पादित कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक, और रिटायरमेंट के लिए अधिकार निर्धारित करें। एक चरणबद्ध रोलआउट उपयोग करें, एक सुरक्षित फ़ॉलबैक रखें, और जानबूझकर इंजेक्टेड विफलताओं के साथ मॉनिटरिंग को सत्यापित करें। परिचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, न कि यह मानते हुए कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियां, हार्डवेयर, या उद्देश्य बदलें, पुनर्मूल्यांकन करें। एक बनाए रखा गया सिस्टम को दस्तावेज़ित पुनर्प्राप्ति, घटना सीखना, हटाने और रखरखाव प्रक्रियाओं, और एक स्पष्ट बिंदु की आवश्यकता होती है जहाँ इसे निष्क्रिय या बदलना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या ग्रेडिएंट डिसेंट हमेशा ग्लोबल न्यूनतम तक पहुँचता है?
नहीं। अभिसारी (convex) उद्देश्यों के लिए, उपयुक्त शर्तें मजबूत गारंटी देती हैं। डीप‑नेटवर्क उद्देश्यों में गैर‑अभिसारी (nonconvex) होते हैं, और व्यावहारिक ऑप्टिमाइज़र आमतौर पर एक उपयोगी समाधान खोजते हैं न कि यह सिद्ध करने के लिए कि उन्होंने अनन्य ग्लोबल न्यूनतम पाया।
शून्य ग्रेडिएंट क्यों भ्रामक हो सकता है?
शून्य या बहुत छोटा ग्रेडिएंट न्यूनतम, अधिकतम, सैडल पॉइंट, संतृप्ति, या सपाट प्लेटॉज़ का संकेत दे सकता है। प्रशिक्षण डायग्नॉस्टिक्स को लॉस इतिहास, वक्रता, पैरामीटर स्केल, और वैलिडेशन प्रदर्शन को ध्यान में रखना चाहिए।
प्राथमिक संदर्भ












