
Základy AI
Co je lineární regrese?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Lineární regrese modeluje spojitý cíl jako lineární kombinaci jednoho nebo více vstupních rysů. Používá se pro predikci, odhad a jako transparentní výchozí model pro pochopení, zda složitější model přináší smysluplnou hodnotu.
Výrazy nezávislá proměnná a závislá proměnná popisují role v modelu, nikoli prokázanou příčinu a následek. Regrese může identifikovat asociaci, zatímco konfúze, výběrová zkreslení, opačná kauzalita nebo měřicí chyba vysvětlují vztah.
Klíčové poznatky
- Cíl y je modelován z vstupních rysů X; starší verze článku v jednom vysvětlení vzorce tyto štítky zaměnila.
- Metoda nejmenších čtverců minimalizuje součet čtvercových reziduí.
- Diagnostika reziduí a předpoklady jsou důležité pro inferenci a nejistotu.
- Regularizace ridge a lasso pomáhá, když je prediktorů mnoho nebo jsou korelované.
Jednoduchá lineární regrese
S jedním rysem je model:
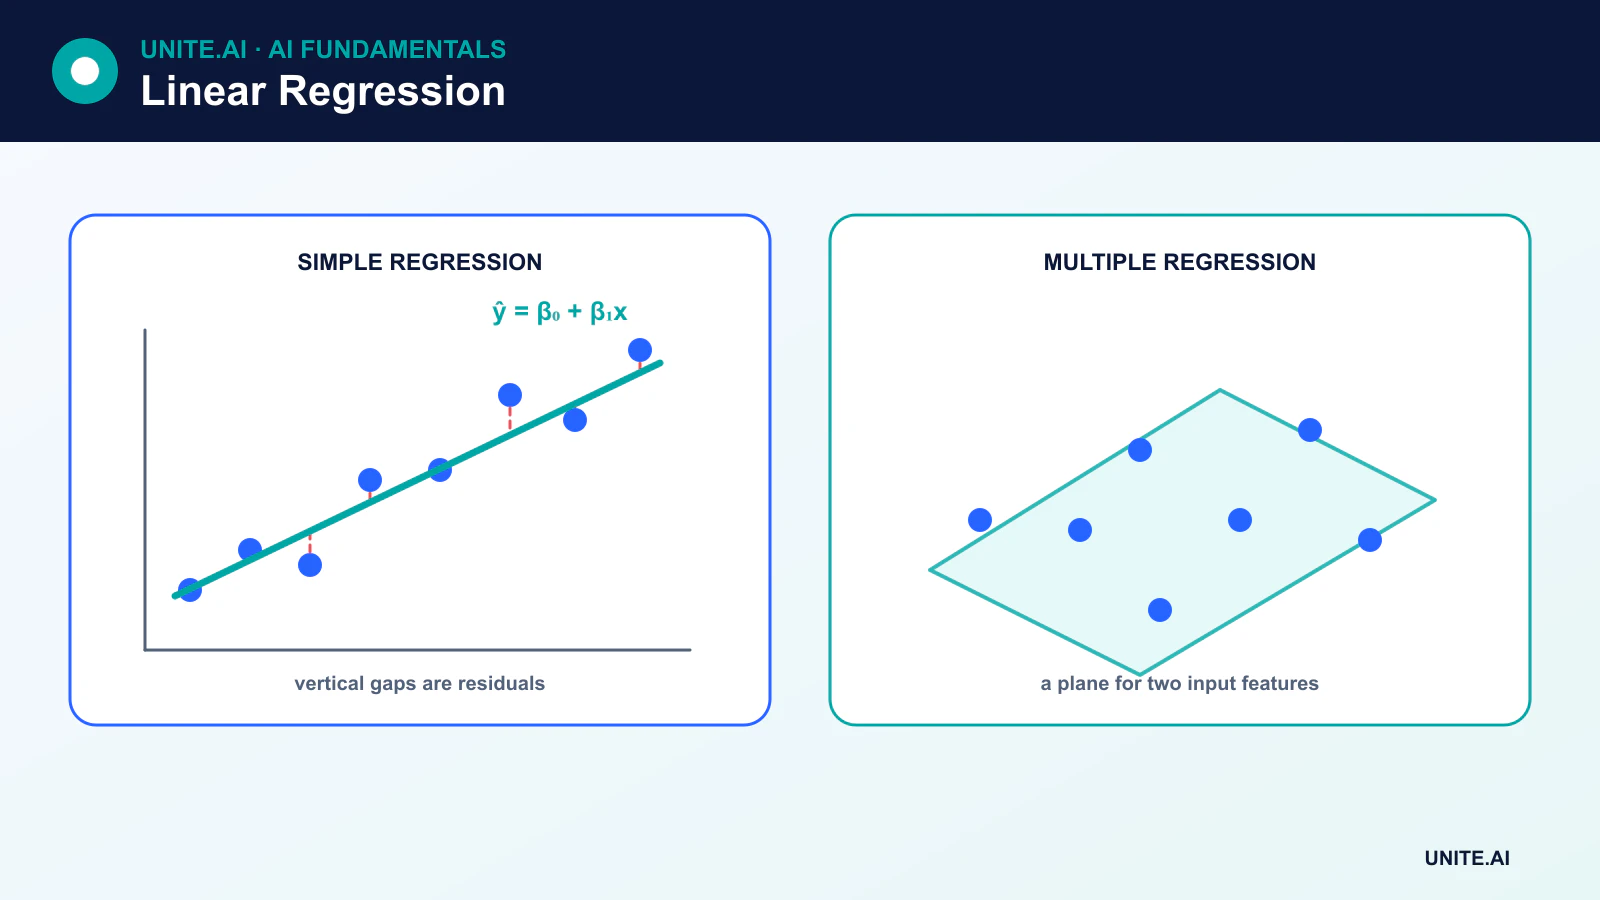
ŷ = β₀ + β₁x
β₀ je průsečík a β₁ je směrnice. Reziduum pro pozorování i je yᵢ - ŷᵢ. Metoda nejmenších čtverců (OLS) vybírá koeficienty, které minimalizují součet čtvercových reziduí.
Směrnice odhaduje očekávanou změnu cíle spojenou s jednojednotkovou změnou rysu v rámci nasazeného modelu. Neměla by být popisována jako kauzální efekt, pokud návrh studie a předpoklady nepodporují identifikaci kauzality.
Vícenásobná lineární regrese
S p rysy:
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
Každý koeficient se interpretuje podmíněně na ostatních zahrnutých rysech. Vícenásobná regrese může zahrnovat kategorické proměnné pomocí kódování, polynomických členů a interakcí. Zůstává „lineární“, protože je lineární v koeficientech, i když jsou zahrnuty transformované rysy jako x².
Předpoklady a diagnostika
Pro predikci je hlavní otázkou, jak dobře model generalizuje. Pro klasické testy koeficientů a intervaly jsou důležité další předpoklady:
- Linearita: podmíněný průměr je reprezentován zvoleným lineárním tvarem.
- Nezávislé nebo správně modelované chyby: opakovaná, seskupená, prostorová nebo časová pozorování mohou vyžadovat odlišnou strukturu chyb.
- Stálá variance chyby: heteroskedasticita ovlivňuje standardní chyby a odhady nejistoty.
- Omezená multikolinearita: silně korelované prediktory činí jednotlivé koeficienty nestabilními.
- Rozdělení reziduí: normalita je relevantní pro některé inferenční postupy při malých vzorcích, není však požadavkem, aby každý rys byl normálně rozdělen.
Grafy reziduí, míry leverage a vlivu a revize domény mohou identifikovat odlehlé hodnoty, nelinearitu, měnící se varianci nebo pozorování, která dominují fitu.
Vyhodnocování předpovědí
- Střední absolutní chyba (MAE) průměruje velikost absolutních reziduí.
- Střední čtvercová chyba (MSE) dává větší váhu větším chybám.
- Kořenová střední čtvercová chyba (RMSE) převádí čtvercovou chybu zpět na jednotky cíle.
- R² porovnává variaci reziduí s konstantní referencí na vyhodnocovaných datech.
R² není mírou přesnosti, neprokazuje kauzalitu a může být na testovacích datech záporné. Validace by měla odpovídat reálnému predikčnímu nastavení, včetně časových nebo skupinových rozdělení, pokud je to nutné.
Ridge, lasso a elastic net
Ridge regrese přidává L2 penalizaci, která zmenšuje koeficienty a stabilizuje korelované prediktory. Lasso přidává L1 penalizaci a může nastavit koeficienty na nulu. Elastic net kombinuje obojí. Rysy obvykle vyžadují kompatibilní škálování, než jsou tyto penalizace porovnávány.
Regularizace zavádí bias výměnou za nižší varianci a může snížit overfitting. Síla penalizace se volí pomocí validace, nikoli na finálním testovacím souboru.
Kdy je lineární regrese nesprávným nástrojem
Lineární model může selhat, když jsou vztahy silně nelineární, chyby závisí na minulých hodnotách, rozdělení cíle vyžaduje specializované modelování, nebo několik odlehlých hodnot dominuje čtvercové ztrátě. Rozhodovací stromy, zobecněné lineární modely, časové řady, robustní regrese nebo nelineární metody mohou lépe sedět.
I když složitější model převáží, lineární regrese zůstává cenným výchozím bodem. Pokud velký systém nedokáže spolehlivě překonat její výkon, přidaná složitost nemusí být oprávněná.
Předpoklady modelu, odhad a diagnostika
Lineární regrese modeluje podmíněný průměr číselného výsledku jako průsečík plus vážené prediktory. Metoda nejmenších čtverců vybírá koeficienty, které minimalizují čtvercová rezidua. Koeficienty popisují očekávanou změnu výsledku při jednojednotkové změně prediktoru, zatímco ostatní zahrnuté proměnné jsou drženy konstantní, v rámci specifikovaného modelu. Jedná se o asociaci, pokud předpoklady o kauzální identifikaci a návrh studie neodůvodňují jinak. Jednotky, kódování, transformace, interakce a referenční kategorie určují interpretaci, takže koeficienty bez datového slovníku jsou neúplné.
Klasická inferenční analýza se opírá o předpoklady o funkční formě, nezávislých chybách, konstantní varianci a rozdělení chyb pro konkrétní testy a intervaly. Grafy reziduí vs. předpovězených hodnot odhalují nelinearitu nebo heteroskedasticitu; Q–Q grafy posuzují chování ocasu; diagnostika leverage a vlivu identifikuje pozorování, která silně ovlivňují odhady. Korelované prediktory zvyšují nejistotu a činí jednotlivé koeficienty nestabilními, i když předpovědi zůstávají dostačující. Mohou být potřeba robustní standardní chyby, transformace, splajny, hierarchická struktura nebo jiný model místo mazání nepohodlných datových bodů.
Regularizace, vyhodnocení a odpovědné použití
Ridge regrese zmenšuje koeficienty pomocí L2 penalizace, zatímco lasso může některé nastavit na nulu pomocí L1 penalizace; elastic net je kombinuje. Standardizujte prediktory, když má být měřítko penalizace srovnatelné, a sílu vyberte pomocí validace nebo křížové validace. Vyhodnocujte střední absolutní chybu, kořenovou střední čtvercovou chybu, rozdělení reziduí, kalibraci napříč rozsahy a nejistotu, s časovými nebo skupinovými rozděleními, která odrážejí použití. Porovnávejte s průměrným výchozím modelem a nelineárními alternativami, ale zachovávejte lineární modely, když jsou transparentnost a stabilita cenné.
Extrapolace mimo pozorovaný rozsah prediktorů následuje nasazenou linii bez důkazů a může být nebezpečná. Sledujte rozsahy rysů, chybějící data, rezidua a chyby podskupin v produkci. Predikční intervaly popisují nejistotu individuálního výsledku a jsou širší než intervaly spolehlivosti pro průměr; obě vyžadují předpoklady. Vyhněte se kontrolování proměnných, které zavádějí kauzální bias, pokud je cílem odhad efektu. Lineární regrese je přesný nástroj pro definovaný vztah, nikoli univerzální záruka, že svět je lineární nebo že koeficient představuje zásah.
Praktický příklad: odhad doby doručení
Logistický tým modeluje dobu doručení na základě vzdálenosti, úrovně služby, regionu, dne v týdnu a známého počasí. Kontroluje nelineární vzory reziduí a přidává oprávněné splajny a interakce místo toho, aby lineární rovnici bral jako doslovnou fyziku. Skupiny dopravců a tras definují validační sklady. Zprvuje se střední absolutní chyba, chyba v ocasu, pokrytí intervalů a systematický bias. Zrušené doručení a data zaznamenaná po příjezdu jsou vyloučena nebo modelována explicitně.
Koeficienty jsou dokumentovány v jednotkách a kontrolovány na nestabilitu při korelovaných prediktorech. Model odmítá extrapolaci mimo validované rozsahy vzdálenosti a regionu. K odhadům jsou připojeny predikční intervaly a následné plánování využívá jejich nejistotu. Monitoring sleduje rozsahy rysů, rezidua, pokrytí intervalů a bias po změnách sítě. Kauzální tvrzení o dopravci nebo počasí není učiněno na základě predikčních koeficientů; operativní experimenty nebo silnější identifikace by byly potřebné k podpoře zásahu.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledek každého důležitého selhání. Zaveďte reprodukovatelný výchozí stav a verzovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun rozdělení, výpadek závislosti, nesprávné použití a skupiny nebo prostředí, která jsou nejvíce opomíjena. Měřte kvalitu úkolu spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před nasazením přiřaďte pravomoci pro vydání, výjimky, změny, rollback a ukončení. Použijte postupné nasazení, zachovejte bezpečný fallback a ověřte monitorování pomocí úmyslně zavedených selhání. Provozní telemetrie by měla odhalit kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky bez sběru zbytečných citlivých údajů. Definujte prahové hodnoty upozornění a odpovědného, poté přezkoumejte reálné důkazy po nasazení místo předpokladu, že offline výkon přetrvá. Přehodnoťte při změně zdrojů dat, uživatelů, modelů, dodavatelů, politik, hardware nebo cílů. Udržovaný systém také potřebuje dokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Vyžaduje lineární regrese pouze jednu vstupní proměnnou?
Ne. Jednoduchá regrese má jeden prediktor, zatímco vícenásobná lineární regrese může používat mnoho číselných, kódovaných kategorických, transformovaných a interakčních rysů.
Může lineární regrese prokázat kauzalitu?
Ne. Kauzální interpretace vyžaduje obhajitelný výzkumný design a předpoklady o konfúzi, výběru, měření a zásahu. Predikční koeficient sám o sobě popisuje asociaci v nasazeném modelu.
Primární reference












