
Základy AI
Co je rozhodovací strom?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Rozhodovací strom je model učící se pod dohledem, který provádí predikci aplikací posloupnosti pravidel typu pokud‑pak. Každý vnitřní uzel testuje vlastnost, každá větev představuje výsledek tohoto testu a každý list produkuje predikci třídy, pravděpodobnost nebo číselnou hodnotu.
Rozhodovací stromy se používají pro klasifikaci i regresi. Jejich výhodou je praktičnost: dokážou reprezentovat nelineární interakce, vyžadují relativně málo předzpracování a vytvářejí cestu, kterou může člověk prozkoumat. Jejich slabinou je nestabilita — malé změny v trénovacích datech mohou vytvořit jiný strom.
Klíčové body
- Strom rekurzivně rozděluje prostor vlastností; nemusí izolovat každé trénovací pozorování.
- Rozdělení pro klasifikaci běžně používají Giniho nečistotu nebo entropii, zatímco rozdělení pro regresi snižují predikční chybu nebo rozptyl.
- Hloubka, minimální velikost listu a prořezávání řídí složitost a přeučení.
- Náhodné lesy a gradientně posilované stromy zvyšují predikční sílu kombinací mnoha stromů.
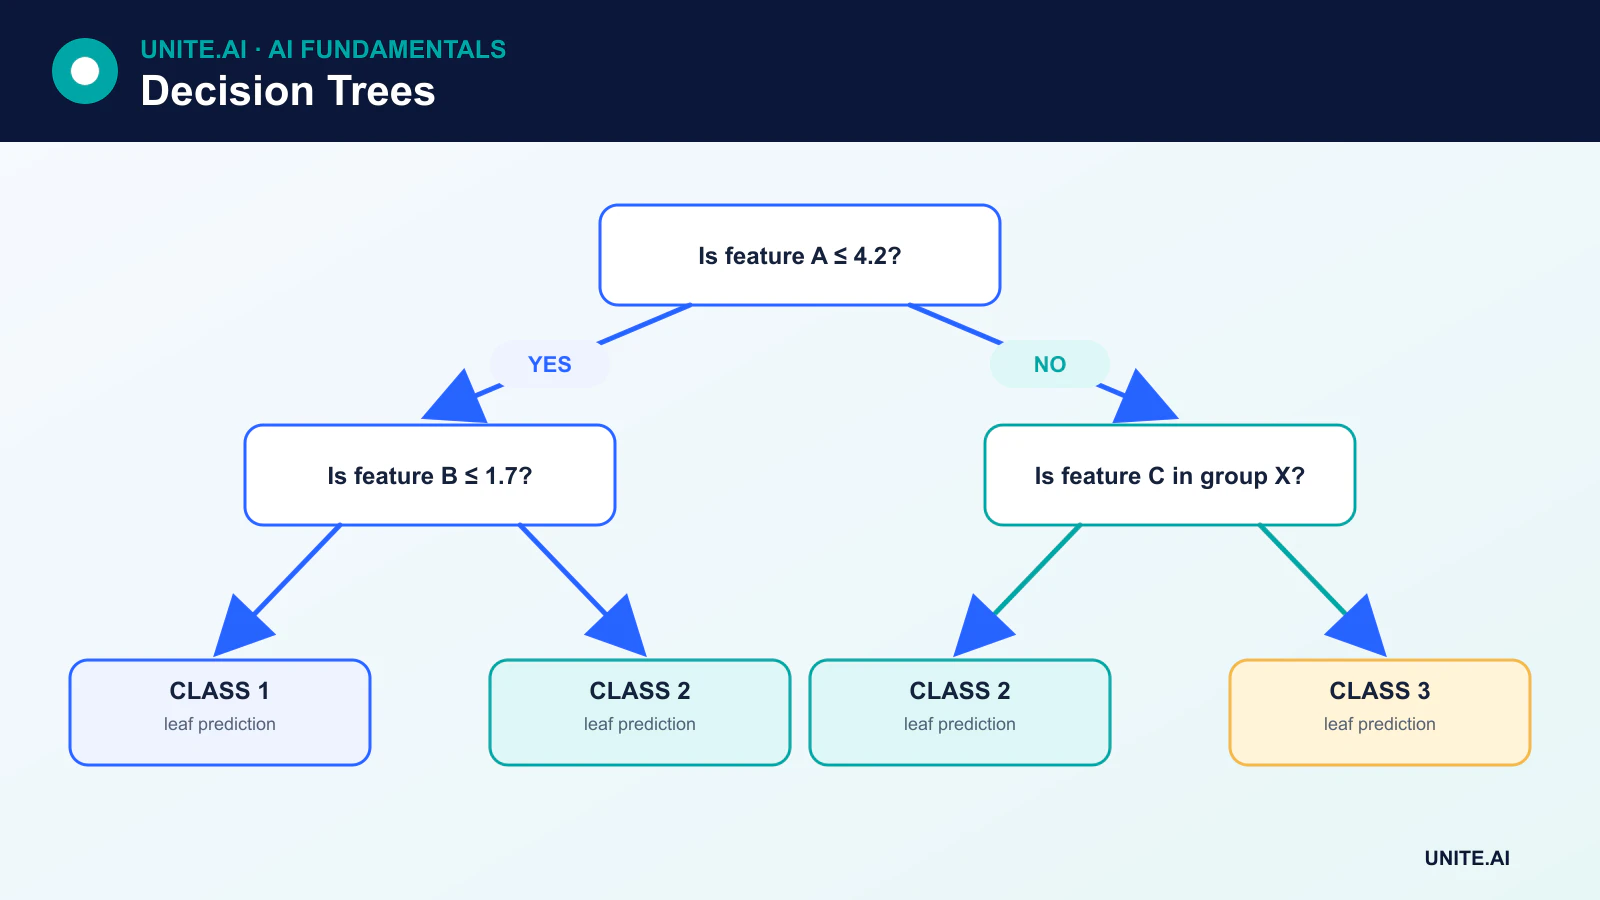
Jak rozhodovací strom provádí predikci
Předpokládejme, že model předpovídá, zda je pravděpodobné selhání stroje. Kořenový uzel se může ptát, zda vibrace překračuje naučený práh. Větev pak může testovat provozní teplotu. Pozorování dosáhne listu, který obsahuje odhadovanou pravděpodobnost selhání mezi trénovacími příklady, jež následovaly stejnou cestu.
U regrese může list vrátit průměrnou cílovou hodnotu pozorování v daném regionu. U klasifikace může vrátit převládající třídu nebo rozdělení četností tříd. List může obsahovat mnoho pozorování; úplné oddělení trénovacích dat je obvykle nežádoucí, protože může vést k přeučenému stromu.
Jak strom vybírá rozdělení
Trénink zvažuje kandidátní vlastnosti a prahy a poté vybírá rozdělení, které nejvíce zlepšuje definovaný cíl. Zlepšení musí být váženo počtem pozorování, která přecházejí do každého poduzlu.
Giniho nečistota
U klasifikace měří Giniho nečistota, jak jsou třídy v uzlu smíšené:
Gini = 1 - Σ p(k)²
Uzel obsahující pouze jednu třídu má nečistotu nula. Kandidátní rozdělení je užitečné, když je vážená nečistota jeho potomků nižší než nečistota rodiče.
Entropie a informační zisk
Entropie je další měřítko nejistoty třídy:
Entropy = -Σ p(k) log₂ p(k)
Informační zisk je entropie rodiče minus vážená entropie potomka. Gini a entropie často vedou k podobným stromům, i když ne vždy identickým.
Regresní ztráta
Regresní stromy běžně vybírají rozdělení, která snižují kvadratickou chybu, absolutní chybu nebo jiný regresní kritérium. Každý list pak predikuje hodnotu na základě trénovacích cílů v daném regionu.
CART a další algoritmy stromů
CART, neboli Classification and Regression Trees, používá binární rozdělení a je základem běžných implementací, jako jsou rozhodovací stromy v scikit-learn. Další algoritmy zahrnují ID3, C4.5 a C5.0. Implementace se liší podporovanými typy rozdělení, zacházením s chybějícími hodnotami, prořezáváním a cíli.
Kategorické proměnné mohou vyžadovat kódování, přímé podmnožinové rozdělení nebo specifické zacházení podle implementace. Chybějící hodnoty lze imputovat nebo řešit pomocí naučených výchozích směrů či náhradních rozdělení. Je důležité pochopit chování konkrétní knihovny, místo aby se předpokládalo, že každá implementace stromu funguje stejně.
Řízení složitosti stromu
Hloubkový strom může zapamatovat šum. Běžné ovládací prvky zahrnují:
- Maximální hloubka: omezuje délku predikční cesty.
- Minimální počet vzorků na rozdělení nebo list: zabraňuje malým regionům.
- Minimální pokles nečistoty: vyžaduje, aby rozdělení přineslo dostatečný přínos.
- Maximální počet listů: omezuje celkovou složitost.
- Prořezávání podle nákladů a složitosti: odstraňuje větve, jejichž zlepšení neospravedlňuje přidanou složitost.
Prořezávání je strukturovaný optimalizační proces, nikoli náhodné mazání. Hyperparametry by měly být vybírány pomocí validačních dat nebo křížové validace, zatímco finální testovací sada zůstává nedotčena.
Silné stránky a omezení
Rozhodovací stromy dokážou modelovat interakce a prahové efekty bez škálování vlastností. Přijímají číselné a v závislosti na implementaci i kategorické vstupy. Predikce je rychlá a malý strom je snadno vizualizovatelný.
Nicméně jediný strom může mít vysokou varianci, vytvářet náhlé změny predikcí v blízkosti rozdělení a upřednostňovat vlastnosti s mnoha možnými body rozdělení. Stromy také špatně extrapolují v regresi: mimo pozorované oblasti list stále vrací hodnotu naučenou z trénovacích vzorků. Velký strom nemusí být srozumitelnější než jiný komplexní model.
Od jednoho stromu k ansámblům
Ensemble learning kombinuje více modelů. Náhodný les trénuje mnoho stromů na přeodběrových pozorováních a podmnožinách vlastností a poté průměruje jejich predikce. Gradientní boosting staví stromy sekvenčně, aby každý nový strom řešil zbývající chybu. Tyto přístupy obvykle překonávají jeden strom, ale za cenu snížené interpretovatelnosti a vyšších výpočetních nákladů.
Důležitost vlastností ze stromu nebo ansámblu by měla být interpretována opatrně. Důležitost založená na nečistotě může být zaujatá a důležitost vlastnosti neprokazuje kauzalitu. Permutační důležitost, nástroje částečné závislosti a odborný přezkum poskytují další kontext.
Jak strom učí rozdělení a predikce
Rozhodovací strom rekurzivně rozděluje prostor vlastností. V každém uzlu tréninkový algoritmus hodnotí kandidátní prahy vlastností nebo rozdělení kategorií a vybírá rozdělení, které nejvíce snižuje nečistotu, například Giniho nečistotu nebo entropii pro klasifikaci a kvadratickou chybu pro regresi. Listy ukládají rozdělení tříd nebo číselnou predikci na základě trénovacích pozorování, která k nim dorazí. Chamtivé rozdělování je výpočetně praktické, ale nezaručuje globálně nejlepší strom a různé vzorky či rozhodování při remíze mohou vytvořit odlišné struktury.
Kontinuální, ordinální, kategorické a chybějící vlastnosti vyžadují explicitní zacházení. One‑hot kódování může vytvořit mnoho kandidátních rozdělení; nativní metody pro kategorie mohou používat uspořádané statistiky, ale potřebují implementaci chráněnou před únikem. Stromy nevyžadují škálování, přesto mohou upřednostňovat proměnné s vysokou kardinálností a izolovat malé skupiny. Hloubka, minimální velikost listu, minimální pokles nečistoty a prořezávání podle nákladů a složitosti řídí varianci. Vyberte je pomocí validačních dat a vyhodnoťte kalibraci, protože pravděpodobnost listu založená na několika případech může být extrémní a nestabilní.
Interpretace, selhávací režimy a nasazení v produkci
Cesta od kořene k listu je přesné pravidlo pro jednu predikci modelu, ale není automaticky kauzálním vysvětlením. Korelované proměnné se mohou navzájem nahrazovat, malé změny v datech mohou změnit vyšší rozdělení a na první pohled jednoduchá cesta může záviset na zaujatých štítcích. Globální důležitost vlastností založená na nečistotě může být zavádějící; permutační důležitost, částečná závislost a kontrafaktuální kontroly poskytují kontext, ale mají také předpoklady. Uveďte nejistotu a otestujte, zda navrhované pravidlo platí na nezávislých datech a relevantních podskupinách.
Jednotlivé stromy jsou užitečné, když jsou důležité transparentnost, nízká latence a mírná nelineární struktura, ale ansámbly obvykle poskytují silnější predikční výkon. Ověřte chování na hranicích, vzácné kategorie, chybějící hodnoty a vstupy mimo trénovací rozsah. Exportovaná pravidla musí přesně reprodukovat tréninkové předzpracování a číselné porovnání. Sledujte obsazenost listů, rozdělení výstupů, chybu a vznikající kategorie. Strom, který směruje mnoho nových případů do malého nebo dříve prázdného regionu, by měl vyvolat revizi, i když je agregátní drift malý. Mějte záložní řešení pro neplatné schémata a dokumentujte každé prořezávání či rozhodnutí o prahu.
Praktický příklad: interpretovatelný strom pro třídění úvěrů
Poskytovatel úvěru používá strom pouze k upřednostnění neúplných žádostí pro ruční kontrolu, nikoli k schválení či odmítnutí úvěru. Cílem je zdokumentovaný výsledek úplnosti a vlastnosti dostupné při podání vylučují pozdější rozhodnutí. Skupinová časová validace porovnává mělký prořezaný strom s pravidly a logistickou regresí. Minimální velikost listu zabraňuje pravidlům založeným na několika žadatelích, zatímco kalibrace a chyby specifické pro třídy jsou hlášeny napříč kanály a relevantními chráněnými skupinami.
Kontrolující vidí přesnou cestu a zdrojové hodnoty, ale mohou opravit chybné údaje a přepsat směrování. Organizace testuje korelované proxy a kontrafaktuální změny, sleduje obsazenost listů a chybějící data a považuje náhlý provoz do malého listu za incident kvality dat. Změny politiky vytvářejí novou verzi modelu a validaci, nikoli nezdokumentované úpravy rozdělení. Protože použití ovlivňuje přístup a zátěž, žadatelé dostávají lidský kanál a strom není nikdy prezentován jako kauzální vysvětlení úvěruschopnosti.
Důkazy o implementaci a operační připravenost
Rozhodnutí v produkci vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledek každého důležitého selhání. Zaveďte reprodukovatelný výchozí stav a verziovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislostí, zneužití a skupiny nebo prostředí, která jsou nejpravděpodobněji nedostatečně obsloužena. Měřte kvalitu úkolu spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenávejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před nasazením přiřaďte pravomoc pro vydání, výjimky, změny, návrat k předchozí verzi a ukončení. Použijte postupné nasazení, zachovejte bezpečnou zálohu a ověřte monitorování pomocí úmyslně vložených selhání. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky bez sběru zbytečných citlivých údajů. Definujte prahy upozornění a odpovědnou osobu, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte vždy, když se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také vyžaduje zdokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy by měl být deaktivován nebo nahrazen.
Primární reference












