
Základy AI
Co je matice záměn?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Matice záměn je tabulka, která počítá, jak často předpovědi klasifikátoru souhlasí nebo nesouhlasí se známými štítky. Ukazuje, které třídy jsou zaměňovány, a poskytuje počty použité k výpočtu metrik, jako jsou přesnost, citlivost, specificita a F1. Je jedním ze základních diagnostických nástrojů pro supervised learning klasifikační úlohy.
Matice samotná není jedním výkonovým skóre. Jedná se o strukturovaný pohled na výsledky při konkrétním prahovém rozhodnutí, datové sadě a definici třídy.
Klíčové poznatky
- U binární klasifikace jsou čtyři výsledky pravdivě pozitivní, falešně pozitivní, falešně negativní a pravdivě negativní.
- Vždy označujte osy: knihovny a publikace neumisťují skutečné a předpovězené třídy vždy ve stejném uspořádání.
- Přesnost může skrývat vážné chyby, když jsou třídy nevyvážené.
- Změna prahové hodnoty klasifikace mění matici záměn a kompromis mezi přesností a citlivostí.
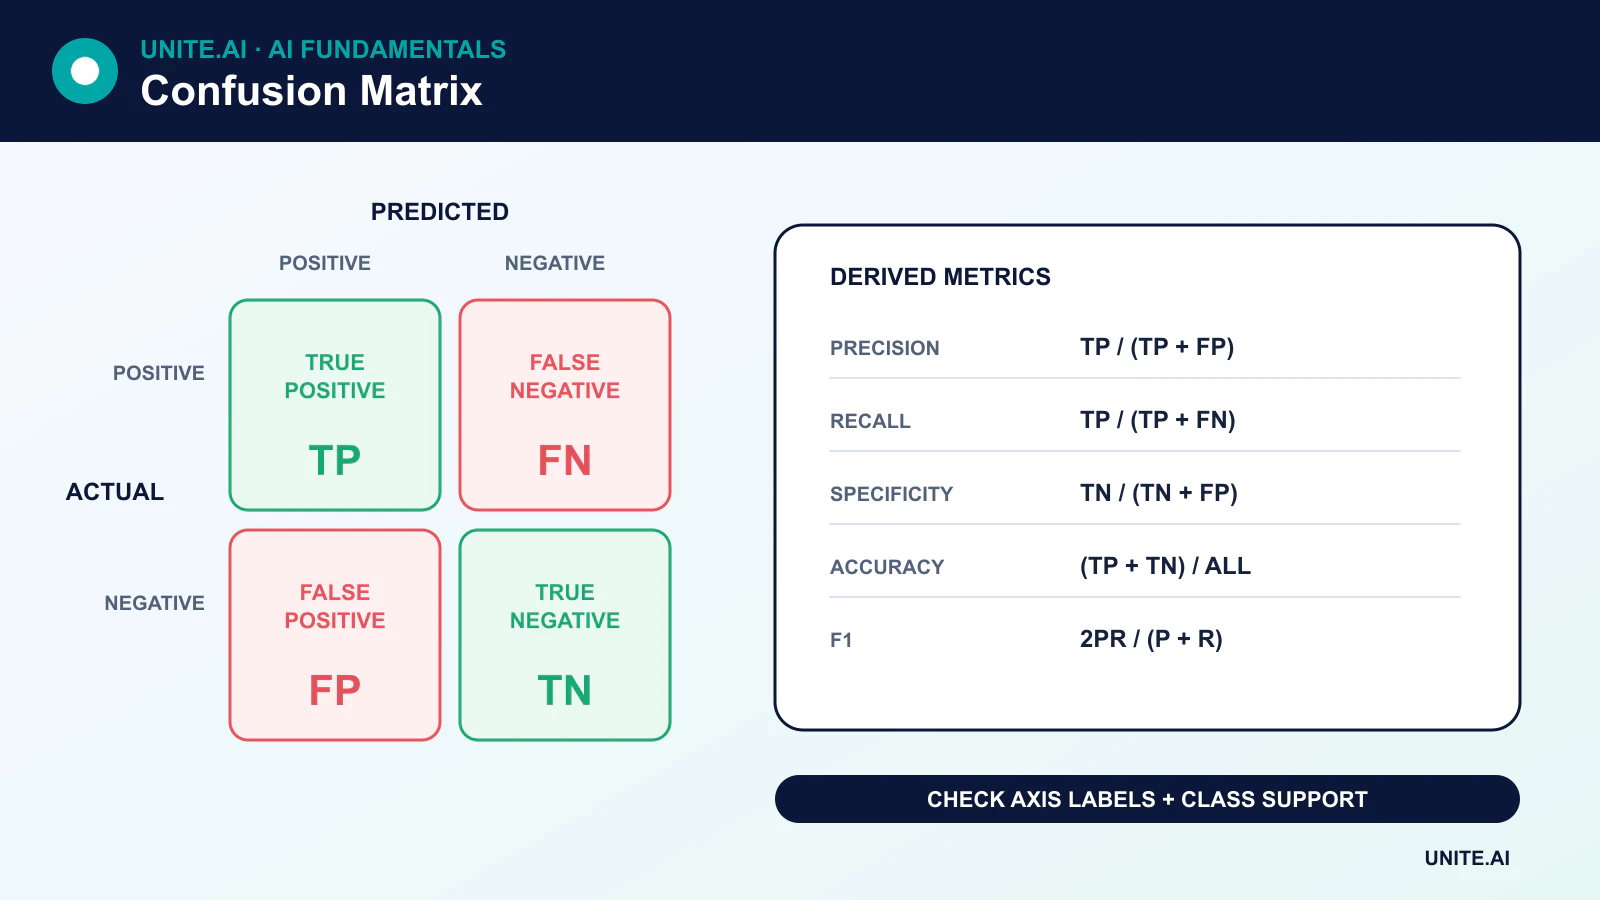
Čtyři výsledky binární klasifikace
- Pravdivě pozitivní (TP): příklad je pozitivní a model předpovídá pozitivní.
- Falešně pozitivní (FP): příklad je negativní, ale model předpovídá pozitivní.
- Falešně negativní (FN): příklad je pozitivní, ale model předpovídá negativní.
- Pravdivě negativní (TN): příklad je negativní a model předpovídá negativní.
V konvenci scikit-learn jsou řádky skutečné třídy a sloupce předpovězené třídy. Jiná vizualizace může toto uspořádání transponovat, takže by měly interpretaci vést popisky – nikoli pozice v rozích.
Metriky odvozené z matice záměn
Přesnost
Precision = TP / (TP + FP)
Přesnost odpovídá: mezi příklady předpovězenými jako pozitivní, jaký podíl byl ve skutečnosti pozitivní?
Recall nebo citlivost
Recall = TP / (TP + FN)
Citlivost odpovídá: mezi všemi skutečnými pozitivními příklady, jaký podíl model identifikoval? V binární klasifikaci se citlivost pro pozitivní třídu také nazývá senzitivita nebo míra pravdivě pozitivních.
Specificita
Specificity = TN / (TN + FP)
Specificita je recall pro negativní třídu: mezi skutečnými negativy, jaký podíl model správně odmítl?
Přesnost
Accuracy = (TP + TN) / (TP + TN + FP + FN)
Přesnost je užitečná, když jsou třídy a náklady na chyby přibližně vyvážené. Může být zavádějící, když jedna třída převládá.
F1 skóre
F1 = 2 × (Precision × Recall) / (Precision + Recall)
F1 shrnuje přesnost a citlivost pomocí harmonického průměru. Ignoruje pravdivě negativní případy, takže není vhodným souhrnem pro každou úlohu.
Ukázkový příklad
Předpokládejme, že testovací sada obsahuje 1 000 transakcí. Padesát je podvodných. Model najde 40 z těchto podvodů, ale označí 30 legitimních transakcí:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
Model má 96 % přesnost, ale jeho přesnost je přibližně 57 % a citlivost 80 %. Vysoká přesnost je z velké míry způsobena množstvím legitimních transakcí. Přijatelnost modelu závisí na nákladech na neodhalený podvod, kapacitě vyšetřování a na tom, jak jsou kalibrovány jeho rizikové skóre.
Prahy mění matici
Mnoho klasifikátorů výstupuje skóre místo nevyhnutelné odpovědi ano/ne. Snížení pozitivního prahu obecně zvyšuje citlivost a počet falešně pozitivních; zvýšení prahu obecně zvyšuje přesnost nebo specificitu, ale zároveň ztrácí více pozitiv. Prah by měl být zvolen na základě validačních dat a reálných nákladů na chyby, nikoli automaticky fixován na 0,5.
Křivky precision‑recall a ROC shrnují výkon napříč prahy. Křivky precision‑recall jsou často informativnější, když je pozitivní třída vzácná.
Matice záměn pro více tříd
Pro K tříd je matice K × K. Správné předpovědi leží na diagonále; mimo‑diagonální buňky ukazují, které dvojice tříd jsou zaměňovány. Metriky pro jednotlivé třídy lze zprůměrovat různými způsoby:
- Makroprůměr: dává každé třídě stejnou váhu.
- Vážený průměr: váží každou třídu podle počtu jejích příkladů.
- Mikroprůměr: agreguje počty výsledků před výpočtem metriky.
Zpráva obsahující jen jeden průměr může skrývat špatný výkon u menších tříd. Uveďte počty podpor a výsledky pro jednotlivé třídy tam, kde jsou rozdíly podstatné.
Časté chyby
- Čtení transponované matice bez kontroly popisků os.
- Výpočet metrik z trénovacích dat místo vhodné oddělené sady.
- Ignorování prevalence tříd, strategie vzorkování nebo duplicitních entit napříč rozděleními.
- Porovnávání matic vytvořených při různých prahových hodnotách bez uvedení změny.
- Považování všech falešně pozitivních a falešně negativních za stejně nákladné.
Matice záměn je tedy diagnostickým nástrojem, nikoli kompletní evaluací. Kalibrace, analýza podskupin, robustnost a následné důsledky také patří do revize klasifikace.
Čtení každé buňky a odvození užitečných metrik
Pro binární klasifikaci matice záměn počítá pravdivě pozitivní, falešně pozitivní, falešně negativní a pravdivě negativní případy pro zvolenou pozitivní třídu a práh. Přesnost dělí správné předpovědi všemi případy; přesnost (precision) se ptá, jaký podíl předpovězených pozitiv byl správný; citlivost (recall) se ptá, jaký podíl skutečných pozitiv byl nalezen; specificita měří, kolik skutečných negativ bylo správně odmítnuto. F1 je harmonický průměr přesnosti a citlivosti. Žádná z nich není univerzálně nejlepší: podvodní screening, lékařská triáž a filtrování spamu přiřazují různým buňkám odlišné důsledky.
U více‑třídních problémů řádky obvykle představují skutečné třídy a sloupce předpovězené třídy, i když konvence se liší, takže popisky musí být explicitní. Počty typu one‑vs‑rest poskytují přesnost a citlivost pro každou třídu. Makroprůměrování váží třídy stejně; mikroprůměrování agreguje rozhodnutí a upřednostňuje časté třídy; vážené průměrování následuje podporu třídy. Úlohy s více štítky umožňují několik štítků na položku a vyžadují definice po štítcích nebo po vzorcích. Normalizujte podle řádku pro zkoumání vzorců citlivosti nebo podle sloupce pro zkoumání složení předpovědí, ale zachovejte surové počty, aby se vzácné skupiny nepřeháněly vizuálně.
Prahy, nejistota a provozní rozhodnutí
Matice záměn shrnuje tvrdá rozhodnutí při jednom prahu. Použijte křivky precision‑recall nebo ROC k porovnání prahů a poté vyberte provozní bod podle kapacity, prevalence a nákladů na chyby. Kalibrace se ptá, zda předpovězené pravděpodobnosti odpovídají pozorované frekvenci, a je oddělena od řazení. Když se prevalence mění, může se měnit přesnost i při stabilní citlivosti a specificitě. Uveďte intervaly spolehlivosti nebo bootstrapovou variabilitu a vyhněte se vyvození závěrů z několika chyb v malé podskupině.
Auditujte matice podle času, místa, zařízení, jazyka a relevantních ovlivněných skupin, abyste našli koncentrované chyby. Porovnejte model s existujícím rozhodovacím procesem, včetně lidské revize. Pro řetězce zaznamenávejte chyby v každé fázi: získávání, klasifikace, nastavení prahu a akce. Sledujte živé štítky výstupů s jejich zpožděním a procesem korekce. Zdánlivě vylepšené F1 může stále zvýšit škodlivé falešně negativní nebo překročit kapacitu revize. Matice záměn je rozhodovací kniha; propojte každou buňku s tím, kdo chybu zažívá, a s následnou reakcí.
Ukázkový příklad: výběr prahu pro lékařské screenování
Model machine-learning pro screenování poskytuje rizikové skóre pro stav s nízkou prevalencí. Tým vytváří matice záměn napříč prahy a uvádí citlivost, specificitu, přesnost, falešně pozitivní odkazy a neodhalené případy s intervaly spolehlivosti. Protože pozitivní predikční hodnota závisí na prevalenci, modeluje se zamýšlená populace místo uvádění jedné datové sady jako přesnosti. Výsledky jsou rozděleny podle zařízení, místa, věku, pohlaví a dalších klinicky odůvodněných skupin.
Klínici volí provozní bod, který zachovává požadovanou citlivost, aniž by zahltil potvrzovací testování. Matice je převedena na očekávané počty na 10 000 prověřených lidí, aby byly důsledky srozumitelné. Skóre mimo validované podmínky nevedou k automatickému závěru. Monitorování porovnává předpovědi s opožděnými potvrzenými diagnózami, sleduje kapacitu a kalibraci a spouští revizi při změně prevalence nebo získávání dat. Matice záměn zůstává spojena s konkrétním modelem, prahem a populací.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení vyžaduje víc než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Zaveďte reprodukovatelnou základní linii a verzovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislostí, zneužití a skupiny nebo prostředí, která jsou pravděpodobně nedostatečně obsloužena. Měřte kvalitu úlohy společně s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoc pro vydání, výjimky, změny, návrat a ukončení. Použijte postupné nasazení, zachovejte bezpečnou zálohu a ověřte monitorování s úmyslně vloženými selháními. Provozní telemetrie by měla odhalit kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky bez sběru zbytečných citlivých údajů. Definujte prahové hodnoty alarmů a odpovědného, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte vždy, když se změní zdroje dat, uživatelé, modely, dodavatelé, zásady, hardware nebo cíle. Udržovaný systém také potřebuje dokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Co je normalizovaná matice záměn?
Normalizace dělí počty celkovým počtem skutečných tříd, počtem předpovězených tříd nebo všemi pozorováními. Usnadňuje porovnání rychlostí napříč třídami, ale zpráva by měla také zachovat surové počty podpor, aby malé skupiny nebyly zaměněny za stejně velké.
Může matice záměn hodnotit regresi?
Ne přímo. Matice záměn vyžaduje diskrétní třídy. Rozdělení spojitého cíle do intervalů ztrácí informaci; regresi by se mělo normálně hodnotit analýzou reziduí a metrikami určenými pro spojité hodnoty, jako jsou MAE nebo RMSE.
Primární reference












