
Základy AI
Jak funguje klasifikace textu?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Klasifikace textu přiřazuje jeden nebo více štítků dokumentu, zprávě nebo úseku textu. Příklady zahrnují detekci spamu, směrování záměru, analýzu sentimentu, označování témat, moderaci a prioritizaci tiketů podpory.
Produkční klasifikátor je víc než jen model. Závisí na přesné taxonomii štítků, reprezentativních anotacích, rozděleních chráněných před únikem, kalibrovaném rozhodovacím pravidle a monitorování změn jazyka a výskytu tříd.
Klíčové poznatky
- Definujte štítky a nejednoznačné případy před výběrem architektury.
- Jednoduché baseline metody typu bag-of-words zůstávají cenné; předtrénované enkodéry přidávají kontext a transfer learning.
- Přesnost může skrývat špatný výkon u menšinových tříd, proto používejte metriky zohledňující třídy a analýzu chyb.
- Kalibrace pravděpodobnosti, abstinence a lidská revize převádějí skóre na bezpečnější rozhodnutí.
Definování taxonomie a politiky anotací
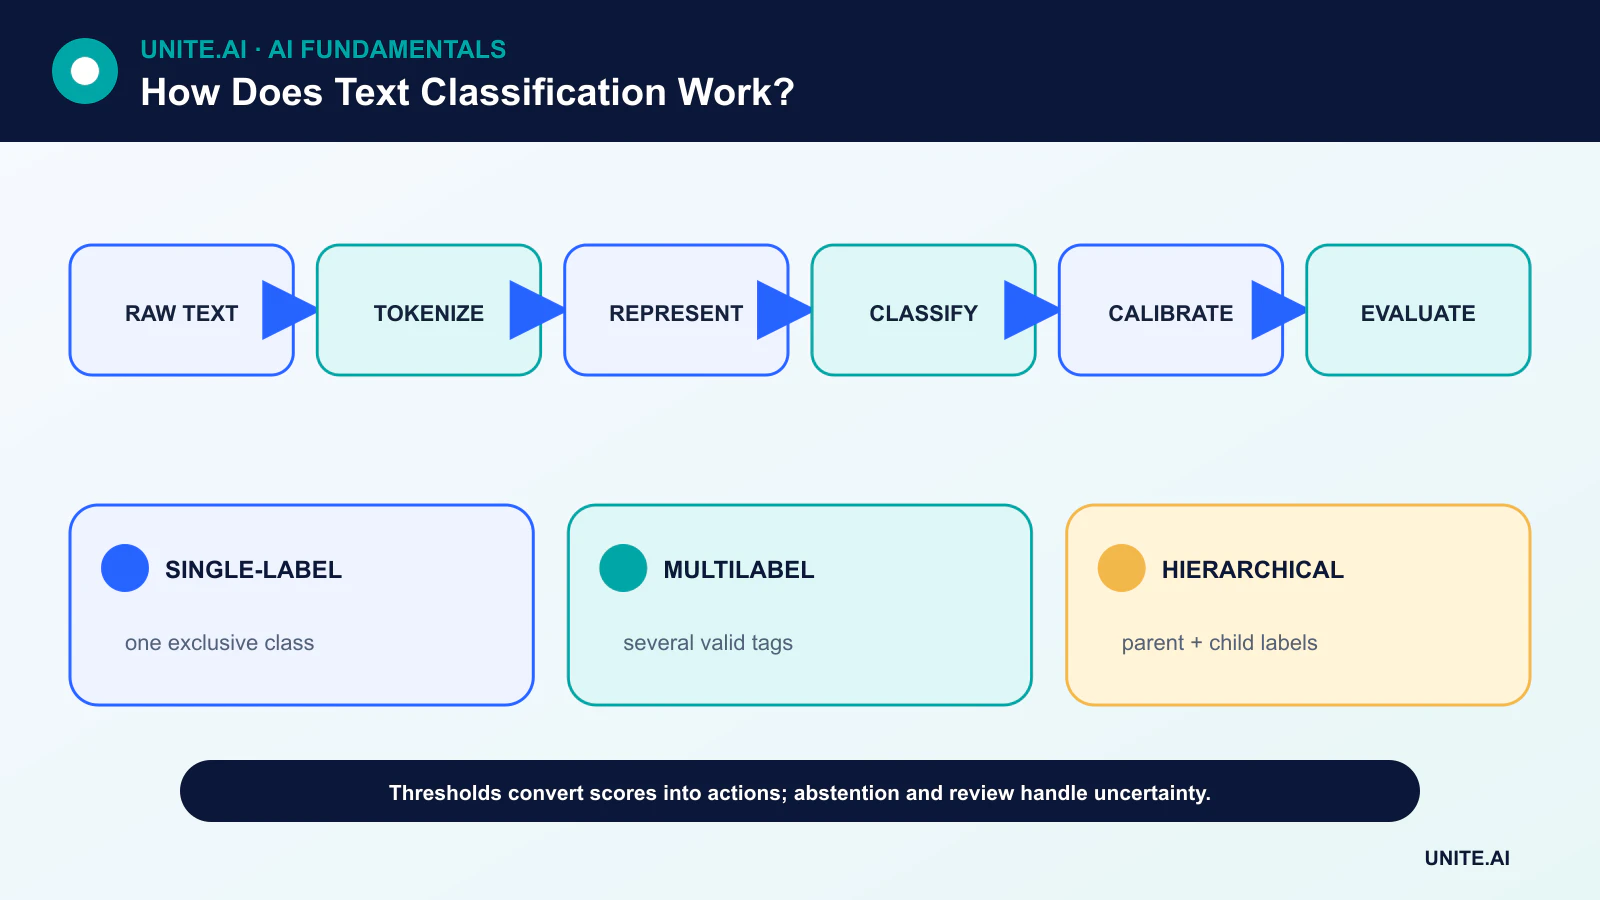
Úloha s jedním štítkem vybírá jednu navzájem se vylučující třídu. Úloha s více štítky může přiřadit několik nezávislých tagů. Hierarchické taxonomie obsahují nadřazené a podřazené štítky. Jedná se o odlišné učební problémy, které vyžadují různé výstupy a metriky.
Anotátoři potřebují definice, pozitivní a negativní příklady, pravidla pro chybějící kontext a eskalační cestu. Statistiky shody mohou odhalit nejasnou úlohu, ale nesoulad může také představovat skutečnou nejednoznačnost, kterou by systém měl zachovat.
Reprezentace textu
Tradiční pipeline používají počty tokenů, n-gramy a TF‑IDF s lineárními klasifikátory nebo support vector machines. Trénují rychle, odhalují vlivné termíny a poskytují silný základ.
Neurální systémy mapují tokeny na vektory (embeddingy). Předtrénované transformátorové enkodéry používají attention k vytvoření kontextových reprezentací a lze je doladit pomocí označených příkladů. Promptované nebo zero‑shot klasifikátory mohou snížit počáteční anotaci, ale jejich formulace štítků, verze modelu a kalibrace musí být vyhodnoceny na konkrétním doménovém souboru.
Trénink bez úniku informací
Datová sada je rozdělena na trénovací, validační a finální testovací data. Dokumenty téměř duplicitní, zprávy ze stejné konverzace nebo šablony ze stejného zdroje by měly zůstat ve stejném rozdělení. Pro časově závislé použití lépe reprezentuje nasazení chronologické rozdělení.
Nerovnováhu tříd lze řešit vážením, pře‑vzorkováním, výběrem prahů nebo doplňkovými daty. Syntetické příklady by neměly nahrazovat revizi skutečných selhání menšinových tříd a mohou zavádět artefakty, které se model učí příliš snadno.
Metriky a kalibrovaná rozhodnutí
A confusion matrix ukazuje, které štítky jsou zaměňovány. Přesnost (precision) měří, kolik předpovězených pozitiv je správných; citlivost (recall) měří, kolik skutečných pozitiv bylo nalezeno. Macro průměry váží třídy stejně, zatímco micro průměry váží jednotlivé příklady.
Surové skóre softmax není automaticky důvěryhodnou pravděpodobností. Kalibrace porovnává jistotu s pozorovanou správností. Týmy mohou nastavit prahové hodnoty specifické pro třídu, abstinovat, když je jistota nízká, a směrovat citlivé případy ke kontrolorovi.
Nasazení, vícejazyčné použití a drift
Text se mění s produkty, událostmi, slangem a adversariálními útoky. Monitorování by mělo sledovat jazyk vstupu, délku, out‑of‑vocabulary vzory, četnost tříd, jistotu a opožděné výsledky. Retrénink vyžaduje verziovaná data a regresní sadu důležitých příkladů.
Vícejazyčný výkon musí být testován pro každou jazyk a dialekt. Překlad všeho do jednoho jazyka může změnit sentiment nebo entity; vícejazyčný enkodér může stále vykazovat nerovnoměrný výkon, protože jeho předtrénování a štítky nejsou rovnoměrně reprezentativní.
Reprezentace a rodiny klasifikátorů
Klasifikace textu mapuje dokument, větu nebo sekvenci tokenů na jeden nebo více štítků. Definujte, zda jsou štítky navzájem se vylučující, multilabel, hierarchické, uspořádané nebo otevřené. Tradiční pipeline tokenizují text, vytvářejí funkce typu bag‑of‑words nebo TF‑IDF a trénují logistickou regresi, naive Bayes nebo lineární SVM. Neurální systémy se učí embeddingy pomocí konvoluce, rekurence nebo transformerů. Promptované jazykové modely mohou klasifikovat bez úkolově specifického tréninku, ale omezení výstupu, náklady, drift a důkazy stále vyžadují srovnání se jednoduššími baseline.
Předzpracování závisí na reprezentaci. Převod na malá písmena nebo odstraňování interpunkce může zničit signály pro jména, sentiment, kód nebo jazyk; stemming může sloučit odlišné významy. Tokenizéry transformerů pracují s podslovy a mají omezení délky, takže strategie oříznutí je důležitá. Dlouhé dokumenty mohou vyžadovat rozdělení na úseky a agregaci. Zachovejte surový text a verzi transformace a rozdělte podle autora, konverzace, zdroje nebo času, aby se zabránilo průniku téměř duplicitních a opakujících se šablon mezi tréninkem a testem.
Štítky, metriky a analýza chyb
Průvodce anotací by měl definovat rozsah, příklady, nejednoznačné případy a možnost neznámého nebo abstinence. Měřte shodu a řešte nesoulad místo jeho skrytí většinovým hlasováním. Pro nevyvážené třídy není přesnost dostačující; uvádějte precision, recall, F1, konfúzní matici, kalibraci a pracovní zátěž specifickou pro prahové hodnoty podle třídy. Úlohy s více štítky potřebují micro, macro a metriky na úrovni štítku. Hodnoťte jazyky, dialekty, domény, délku zprávy a čas. Náhodné rozdělení může nadhodnocovat kvalitu, když se slovník nebo šablony mění.
Analýza chyb by měla oddělit selhání reprezentace, nedostatečný kontext, nejednoznačnost štítků, vzácnou slovní zásobu, negaci, sarkasmus a falešné náznaky. Používejte kontrafaktuální testy, které mění jména, dialektické značky nebo irelevantní metadata při zachování významu. Prozkoumejte chyby s vysokou jistotou a odmítnuté případy. Model se může naučit, že kanál zákazníka nebo podpis předpovídá štítek místo interpretace obsahu. Odstraňte únik informací a revidujte data před pouhým zvýšením kapacity modelu.
Návrh produkčního systému
Poskytujte pevný tokenizér a model se schématem validace, limity délky, dávkováním a záložním řešením pro nepodporované jazyky nebo nízkou jistotu. Monitorujte distribuci vstupů, četnost štítků, kalibraci, latenci a revidované výsledky. Chraňte text, protože může obsahovat osobní, důvěrné nebo adversariální instrukce. Pro automatizovanou moderaci, způsobilost nebo směrování poskytujte možnost odvolání a měřte rozdílné chyby. Verze štítků a prahových hodnot podle obchodní politiky. Klasifikace textu je spolehlivá pouze v rámci definovaného systému štítků a distribuce dat; plynulé vysvětlení modelu neprokazuje, že je klasifikace správná.
Praktický příklad: klasifikace příchozích požadavků podpory
Tým podpory definuje navzájem se vylučující štítky směrování plus příznaky urgentní, vícejazyčné a neznámé. Anotátoři označují de‑identifikované zprávy s pokyny pro smíšené problémy a měří shodu. Baseline logistické regresie na TF‑IDF, doladěný enkodér a promptovaný model používají stejnou časově orientovanou testovací sadu. Hodnocení uvádí precision a recall tříd, urgentní false negative, kalibraci, platnost schématu, latenci a náklady, přičemž téměř duplicitní šablony jsou seskupeny, aby se zabránilo úniku.
Nasazený klasifikátor ověřuje jazyk a délku, abstinuje při slabých důkazech a umožňuje operátorům opravit směrování. Promptové vstupy a zprávy jsou považovány za nedůvěryhodné; přístup k nástrojům chybí. Monitorování sleduje výskyt štítků, jistotu, korekce, dobu odezvy a vznikající témata. Zásada nebo změna produktu aktualizuje taxonomii a data pro retrénink prostřednictvím revize. Systém zlepšuje umístění ve frontě, ale nikdy neodvozuje zákaznický emocionální stav nebo nárok nad rámec ověřených štítků.
Důkazy o implementaci a provozní připravenost
Produkční rozhodnutí vyžaduje víc než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Stanovte reprodukovatelný baseline a verziovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislostí, zneužití a skupiny nebo prostředí, která jsou nejčastěji nedostatečně obsluhována. Měřte kvalitu úlohy spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a rozlišit důkazy od atraktivního prototypu.
Před spuštěním přidělte pravomoci pro vydání, výjimky, změny, rollback a ukončení. Použijte postupné nasazení, zachovejte bezpečnou záložní možnost a ověřte monitorování pomocí záměrně vložených selhání. Provozní telemetrie by měla odhalit kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky bez sběru zbytečných citlivých dat. Definujte prahové hodnoty upozornění a odpovědného za reakci, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte vždy, když se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také potřebuje dokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy by měl být deaktivován nebo nahrazen.
Často kladené otázky
Je analýza sentimentu úlohou klasifikace textu?
Obvykle ano, ale sentiment může být multilabel, založený na aspektech nebo kontinuální, místo jediného štítku pozitivní/neutralní/negativní.
Kdy by měl textový klasifikátor abstinovat?
Když je jistota nízká, text je mimo rozsah, chybí požadovaný kontext nebo náklady na nesprávnou automatickou akci převyšují náklady na revizi.
Primární reference












