
Základy AI
Co je analýza sentimentu? Metody, využití a omezení

 Přidejte Unite.AI mezi své preferované zdroje na Google
Analýza sentimentu odhaduje hodnotící jazyk v textech, přepisech řeči nebo jiném obsahu. Systém může klasifikovat polaritu, například pozitivní, negativní nebo neutrální; detekovat názory na úrovni aspektů; odhadovat intenzitu; nebo identifikovat postoj vůči konkrétnímu tvrzení.
Cíl je třeba definovat pečlivě. Sentiment není totéž co emoce, úmysl, toxicita, spokojenost nebo pravda. Pozitivní věta může sarkasticky popisovat škodlivou událost, zatímco negativní recenze produktu může celkově produkt doporučovat.
Klíčové poznatky
- Definujte jednotku, cíl, štítky a kontext před sběrem příkladů.
- Lexikony jsou transparentní výchozí modely; dozorované a transformerové modely dokážou zachytit více kontextu, ale vyžadují reprezentativní data.
- Negace, sarkasmus, doménová slovní zásoba, vícejazyčný text a hranice aspektů zůstávají obtížné.
- Vyhodnocujte podle třídy, podskupiny, domény a časového období; zahrňte lidskou kontrolu pro důležité použití.
Úrovně a cíle
Analýza na úrovni dokumentu vytváří jeden štítek pro celý objekt. Analýza na úrovni věty odděluje jednotlivé výroky, zatímco analýza založená na aspektech spojuje sentiment s entitou nebo atributem – například pozitivní ohledně kvality obrazu, ale negativní ohledně výdrže baterie.
Postoj zjišťuje, zda mluvčí podporuje konkrétní tvrzení, což se může lišit od emocionálního tónu. Tyto rozdíly by měly být vyjasněny v anotační příručce před použitím metod text classification.
Lexikony, klasické modely a transformery
Lexikon přiřazuje slovům skóre a kombinuje je s pravidly pro negaci nebo intenzitu. Je interpretovatelný a levný, ale má problémy s kontextem. Klasické dozorované modely používají slova nebo n‑gramové rysy, zatímco transformery se učí kontextové reprezentace a lze je doladit.
Promptování s několika příklady může být pohodlné, ale výstupy závisí na příkladech a formulaci. Porovnávejte každý složitý přístup s výchozím modelem a používáte few-shot learning pouze s oddělenou, verzovanou evaluační sadou.
Výzvy dat a jazyka
Štítky mohou odrážet perspektivu anotátora spíše než objektivní fakt. Posun domény je výrazný: ‘nepředvídatelné’ může být chvála pro film a kritika pro vozidlo. Přepínání kódů, dialekt, emoji, citovaná řeč a ironie komplikují signály na úrovni tokenů.
Vyvážte třídy úmyslně a zabraňte úniku souvisejících autorů, produktů nebo konverzací mezi tréninkovou a testovací sadou. Model, který si zapamatuje značku nebo mluvčího, může vypadat přesně, aniž by se naučil sentiment.
Vyhodnocení a odpovědné používání
Uveďte přesnost, recall, F1 a matici záměn místo samotné přesnosti. Přezkoumejte chyby podle aspektu, délky, dialektu a času a kalibrujte prahy podle operačních nákladů každé chyby.
Agregované trendy mohou podpořit výzkum nebo třídění, ale odvozování stavu jednotlivce či rozhodování o zaměstnání, úvěru, zdraví nebo policejních zásazích představuje větší riziko. Poskytněte nejistotu, kontext zdroje, kontrolu soukromí a lidskou revizi.
Anotace a tvorba datové sady
Sepište anotační příručku s cílovou entitou, jednotkou analýzy, definicemi štítků, zacházením s kombinovanými a neutrálními případy, pravidly citací, politikou sarkasmu a příklady z domény. Pilotujte s několika anotátory, vypočítejte shodu, projednejte nesrovnalosti a upravte úkol před rozšířením štítků.
Výběr vzorku určuje, co se model naučí. Proud ze sociálních médií může přehánět aktivní účty; podporné tickety mohou opomenout spokojené zákazníky; hvězdičkové hodnocení nemusí odpovídat textu recenze. Zachovejte metadata o zdroji a čase, respektujte podmínky platformy a soukromí a vytvořte testovací sadu z populace, kde budou rozhodnutí učiněna.
Únik štítků může nastat přes hodnocení, emoji vložená sběrným systémem, šablonové podpisy nebo názvy produktů korelované se sentimentem. Odstraňte téměř identické příspěvky a seskupte konverzace nebo autory, aby jejich jazyk neobjevil na obou stranách rozdělení.
Volby modelování a kalibrace
Lexikální systémy sčítají skóre slov a upravují je podle negace, zesilovačů, interpunkce nebo emoji. Poskytují užitečnou kontrolu rozumu a lze je přizpůsobit doménovým termínům. Lineární modely s TF‑IDF rysy zůstávají konkurenceschopné na některých datových sadách a odhalují vlivné n‑gramy.
Kontekstuální enkodéry reprezentují slova podle okolního textu a lze je doladit pro polaritu nebo aspekty. Dlouhé dokumenty mohou vyžadovat hierarchické modely, agregaci vět nebo vyhledávání relevantních úseků. Vícejazyčné přístupy mohou trénovat jeden sdílený model, překládat do pivotního jazyka nebo udržovat lokální modely; každý má své pokrytí a kulturní kompromisy.
Kalibrace pravděpodobnosti je důležitá, když skóre spouští akci. Grafy spolehlivosti a očekávaná chyba kalibrace ukazují, zda hlášená důvěra 0,8 odpovídá přibližně 80 % správnosti. Prahy mohou vytvořit pásmo pro odmítnutí a lidskou revizi a samostatné prahy mohou být oprávněné, když se náklady na chyby liší – ne k zakrytí nerovné kvality.
Aplikace a běžné mylné interpretace
Agregovaný sentiment může pomoci upřednostnit témata, porovnat reakce kampaní nebo směrovat urgentní servisní zprávy. Analýza aspektů je často praktičtější než celková polarita, protože identifikuje, o čem lidé diskutují. Analýza trendů vyžaduje stabilní výběr a definice štítků v čase.
Nezaměňujte výskyt negativních příspěvků s názorem celé populace. Chování při zveřejňování, boty, moderace, demografie platformy, kampaně a dotazy při sběru formují vzorek. Model sentimentu neměří tichou populaci a změna formulace může vypadat jako změna postoje.
Pro individuální rozhodnutí mohou být falešné štítky stigmatizující a obtížně napadnutelné. Vyhněte se používání sentimentu jako náhrady za zapojení zaměstnanců, duševní zdraví, úvěruschopnost, úmysl nebo podvod. Když jsou lidé ovlivněni, ukažte kontext zdroje, umožněte opravu a vyžadujte lidského rozhodovatele s reálnou volností.
Praktický příklad: analýza sentimentu pro zpětnou vazbu zákazníků
Společnost analyzující podporné komentáře by měla definovat, zda potřebuje sentiment dokumentu, sentiment aspektu, emoce, naléhavost nebo klasifikaci problému. „Dodávka byla rychlá, ale produkt se rozbil“ nelze věrně vyjádřit jediným pozitivním či negativním štítkem. Vytvořte anotační příručku pro cíle, negaci, sarkasmus, smíšené výroky, citovanou řeč a neznámé případy, poté změřte shodu před tím, než štítky považujete za pravdu.
Porovnejte lexikon nebo lineární výchozí model s doladěným enkodérem nebo promptovaným jazykovým modelem. Rozdělte data podle času nebo zákazníka, aby se zabránilo úniku téměř duplicitních příkladů, a zachovejte poměr tříd. Uveďte přesnost, recall, F1, kalibraci a matici záměn podle jazyka, kanálu, produktu a demografických zástupců jen tam, kde je to zákonné a odůvodněné. Přezkoumejte chyby s vysokou důvěrou, protože jsou nebezpečnější v automatickém směrování než nejisté výstupy, které jsou eskalovány.
Používejte sentiment jako jeden signál pro agregaci nebo prioritizaci, ne jako neotřesitelný měřítko stavu osoby. Sledujte vývoj slovní zásoby a produktů, přeškolujte s revidovanými příklady a umožněte agentům opravovat štítky. Nikdy neodvozujte chráněné charakteristiky ani neukazujte pracovníky na základě neověřených sentimentových skóre. Pro výkonnostní zprávy ukažte velikost vzorku, nejistotu, chybějící data a témata, která změnu pohánějí, aby kolísavé skóre vedlo k vyšetřování místo jednoduchého závěru.
Vícejazyčné nasazení by nemělo předpokládat, že překlad vstupů zachovává tón, negaci, idiomy nebo kulturní konvence. Ověřte každý podporovaný jazyk a smíšený jazykový vzor s rodilými recenzenty a poskytujte výsledek „neznámý“, když jsou důkazy slabé. Adaptace domény je také důležitá: slova, která znějí negativně v běžné konverzaci, mohou být neutrální technické popisy. Udržujte samostatné prahy nebo modely jen tehdy, když provozní důkazy ospravedlňují přidanou složitost a správní zátěž.
Praktický kontrolní seznam implementace
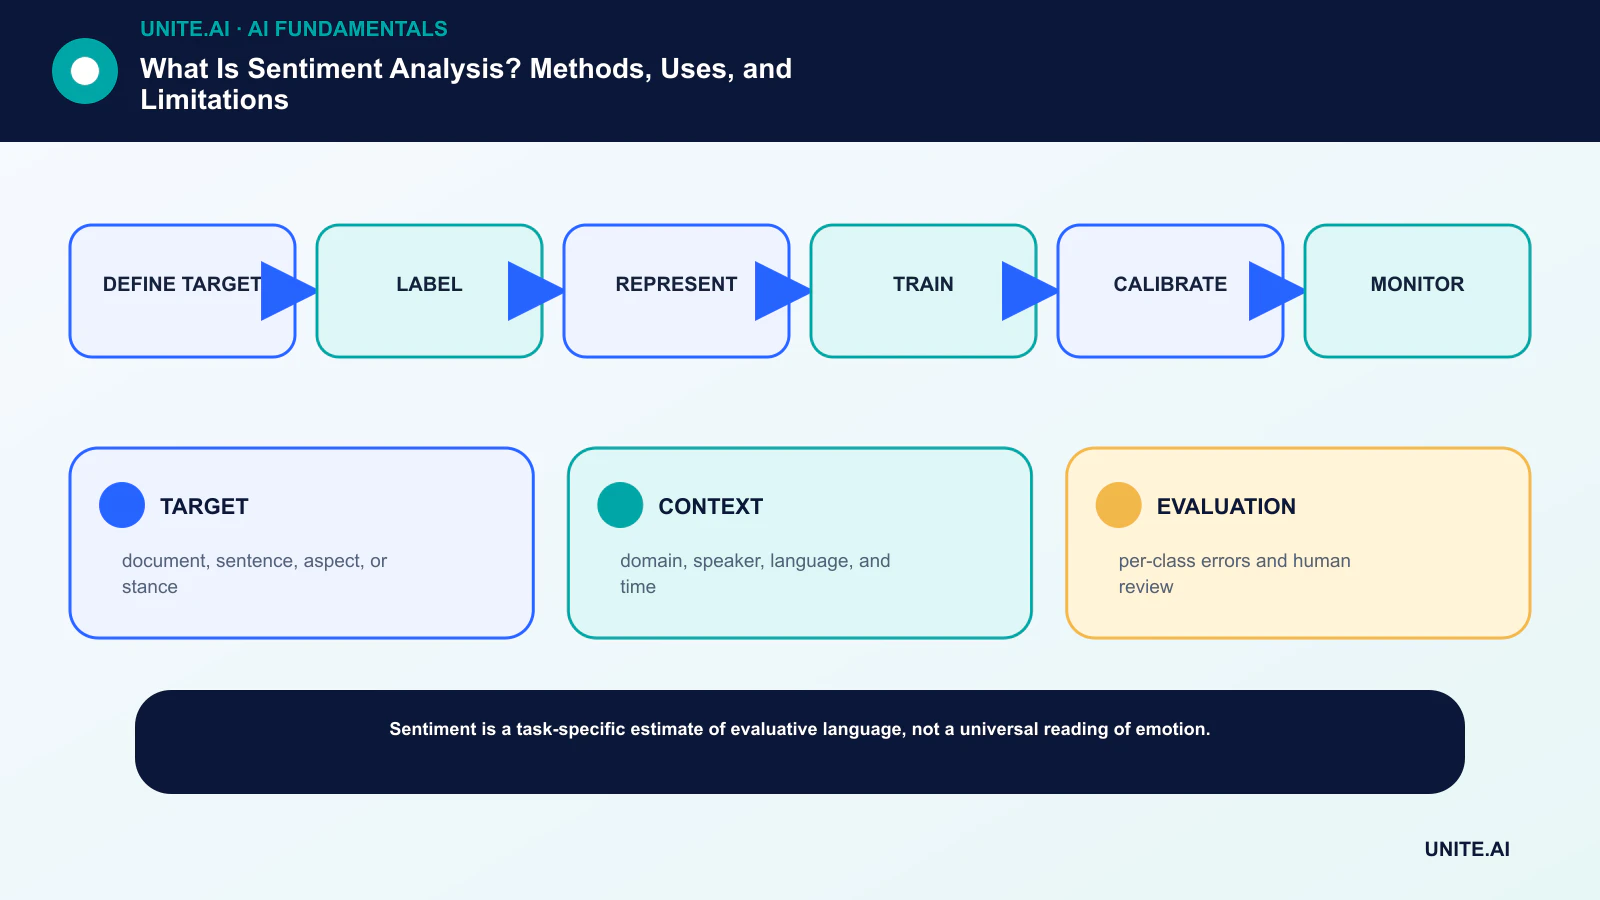
Převěďte koncept na ohraničený, testovatelný pracovní postup: definujte cíl → štítek → reprezentaci → trénink → kalibraci → monitorování. Určete odpovědnou osobu, zdokumentujte data a závislosti, zaveďte jednoduchý výchozí model, stanovte kritéria přijetí a ukončení, otestujte reprezentativní selhání a definujte monitorování, rollback a revizi před rozšířením rozsahu. Zaznamenejte verze a předpoklady, aby jiný tým mohl výsledek reprodukovat a pochopit, co se změnilo.
Před nasazením proveďte zdokumentovanou revizi připravenosti s lidmi, kteří systém budují, provozují, zabezpečují a jsou jím ovlivněni. Otestujte běžné případy, hraniční podmínky, selhání závislostí a zneužití; zachovejte důkazy a nevyřešená rizika. Definujte, kdo může schválit vydání, změnit práh, přebít výstup nebo zastavit provoz. Přehodnoťte rozhodnutí po příchodu reálných dat, protože technicky úspěšný pilot nezaručuje spolehlivý výkon v širším měřítku.
- TARGET: dokument, věta, aspekt nebo postoj.
- CONTEXT: doména, mluvčí, jazyk a čas.
- EVALUATION: chyby podle třídy a lidská revize.
Často kladené otázky
Je analýza sentimentu objektivní?
Ne. Odhaduje štítky definované úkolem a anotačním procesem. Některé texty jsou skutečně nejednoznačné, smíšené, kontextově závislé a čtenáři je interpretují různě.
Dokáže analýza sentimentu detekovat sarkasmus?
Modely se mohou naučit některé vzory, ale sarkasmus často závisí na historii mluvčího, sdílených znalostech a kontextu mimo samotný text. Zůstává běžným režimem selhání.
Primární reference












