
Základy AI
Co je Bayesova věta?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Bayesova věta popisuje, jak aktualizovat pravděpodobnost hypotézy po pozorování důkazu. Spojuje pravděpodobnost důkazu za předpokladu hypotézy s pravděpodobností hypotézy za předpokladu tohoto důkazu.
Tento rozdíl je středobodem statistického uvažování a strojového učení. Test může být vysoce přesný, když je stav přítomen, zatímco pozitivní výsledek má stále jen střední pravděpodobnost, že stav indikuje, pokud je stav vzácný.
Klíčové poznatky
- Posterior kombinuje předchozí víru s pravděpodobností pozorovaného důkazu.
- Termín důkazu normalizuje možné hypotézy.
- Základní četnosti mohou převážit zdánlivě silný důkaz.
- Naivní Bayes předpokládá, že rysy jsou podmíněně nezávislé za předpokladu třídy, nikoli nezávislé ve všech situacích.
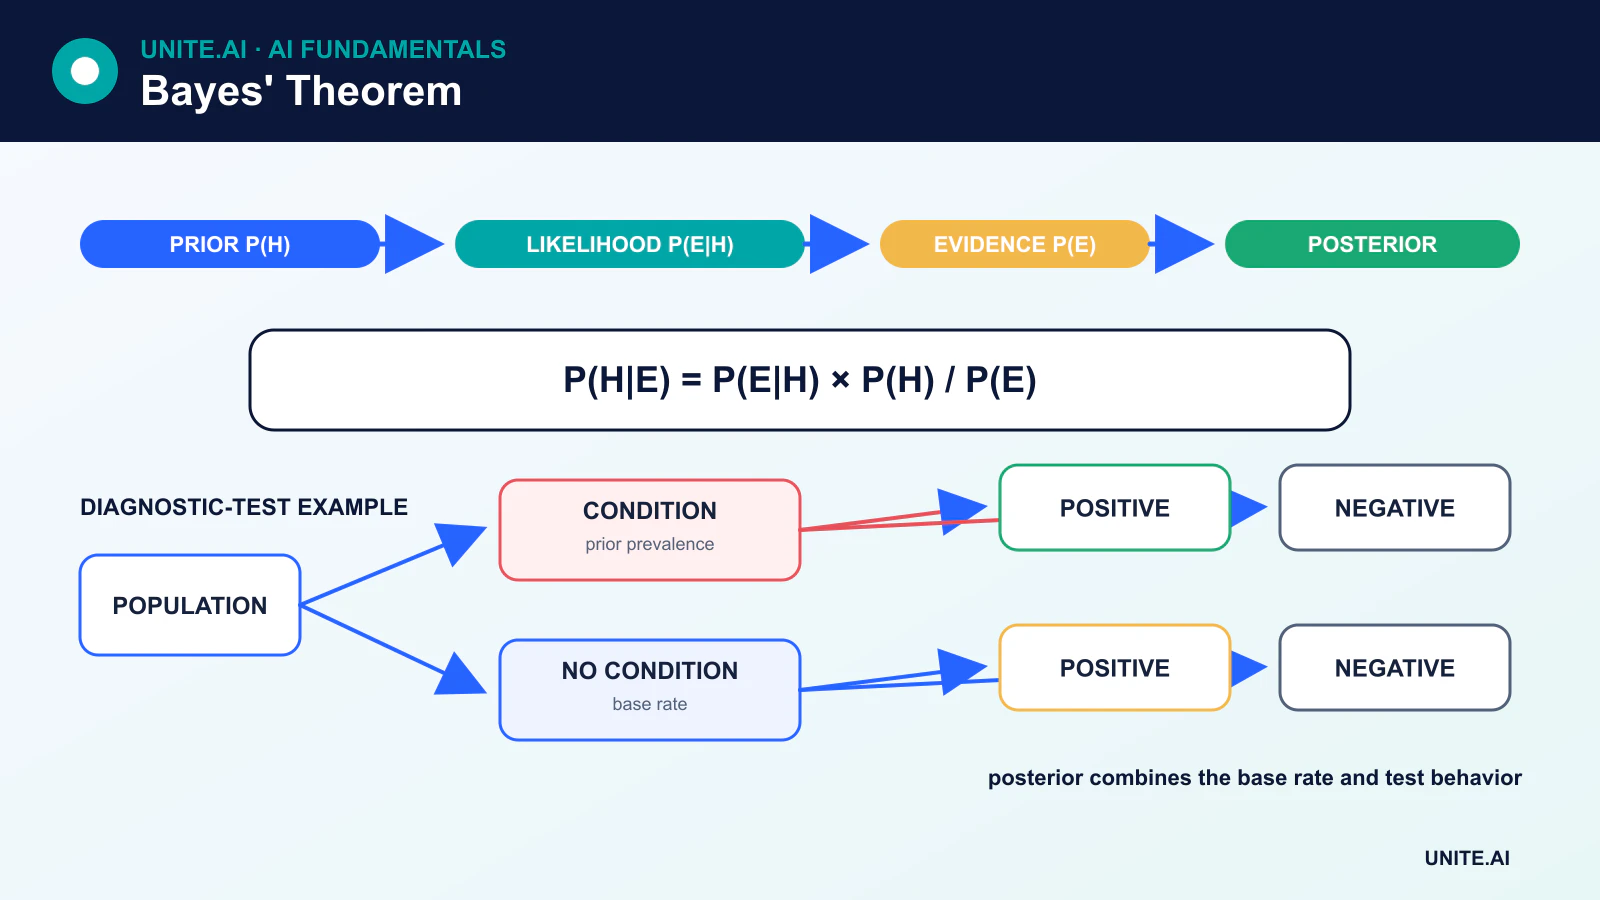
Vzorec
P(A|B) = P(B|A)P(A) / P(B)
- P(A) je předchozí pravděpodobnost hypotézy A.
- P(B|A) je pravděpodobnost pozorování důkazu B za předpokladu, že A je pravda.
- P(B) je celková pravděpodobnost důkazu.
- P(A|B) je posteriorní pravděpodobnost A po pozorování B.
Věta vyplývá ze dvou ekvivalentních výrazů pro společnou pravděpodobnost: P(A ∩ B) = P(B|A)P(A) a P(A ∩ B) = P(A|B)P(B).
Číselný příklad základní četnosti
Předpokládejme, že stav postihuje 1 % populace. Test má 90 % citlivost a 5 % míru falešně pozitivních výsledků. Uvažujme 1 000 lidí:
- Zhruba 10 má stav; test správně označí 9.
- Zhruba 990 nemá stav; 5 % míra falešně pozitivních označí přibližně 50.
- Celkem tedy vznikne asi 59 pozitivních výsledků, z nichž 9 jsou pravdivě pozitivní.
Pravděpodobnost stavu po pozitivním výsledku je přibližně 9 / 59 ≈ 15 %, nikoli 90 %. Citlivost testu odpovídá P(positive | condition); uživatel obvykle chce P(condition | positive). Bayesova věta je spojuje pomocí základní četnosti.
Bayesovská aktualizace
Jakmile přicházejí nové důkazy, posterior může sloužit jako prior pro další aktualizaci. Kompletní bayesovský model specifikuje možné hypotézy, priorní rozdělení, pravděpodobnost (likelihood) a veličinu, kterou chceme odhadnout. Nejistota je reprezentována posteriorním rozdělením místo jediné bodové odhadu.
Prior by měl být zdokumentován a testován na citlivost. Slabě informativní prior může regulovat nepravděpodobné hodnoty, zatímco špatně zvolený silný prior může přebít omezená data.
Klasifikátory Naivní Bayes
Naivní Bayes předpovídá třídu y z rysů x₁ … xₙ pomocí Bayesovy věty a předpokladu:
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
Předpokládá se, že rysy jsou podmíněně nezávislé po znalosti třídy. Toto je často nerealistické, přesto může klasifikátor dobře fungovat, pokud jsou výsledné skóre tříd stále užitečná.
Běžné varianty
- Multinomial Naive Bayes modeluje rysy podobné počtům a je běžný při klasifikaci dokumentů.
- Bernoulli Naive Bayes modeluje binární přítomnost rysů.
- Gaussian Naive Bayes modeluje každý spojitý rys pomocí třídu podmíněného Gaussova rozdělení.
- Categorical Naive Bayes modeluje diskrétní kategorie.
Vyhlazování a číselná stabilita
Pokud se hodnota rysu v tréninku nikdy neobjeví s danou třídou, nevyhlazený odhad pravděpodobnosti může být nulový a vyloučit celý součin. Aditivní nebo Laplace‑stylové vyhlazování tomu předchází. Implementace počítají logaritmy pravděpodobností, takže násobení mnoha malých hodnot se převádí na sčítání stabilních logaritmů.
Pravděpodobnosti, skóre a kalibrace
Výstupy pravděpodobností Naivního Bayesu mohou být špatně kalibrované, protože korelované rysy jsou v podstatě počítány vícekrát. Klasifikátor může dobře řadit třídy, ale přehánět jistotu. Kalibraci je třeba hodnotit na vyhrazených datech, pokud pravděpodobnosti řídí rozhodnutí.
Bayes mimo Naivní Bayes
Bayesovská inference podporuje hierarchické modely, A/B testy, vědecký odhad parametrů, předpovídání, rozhodování s ohledem na nejistotu a pravděpodobnostní grafické modely. Přibližné metody jako Markov Chain Monte Carlo a variační inference se používají, když posterior nelze vypočítat v uzavřené formě.
Běžné chyby v uvažování
- Zaměňování
P(A|B)sP(B|A). - Ignorování vzácné nebo běžné základní četnosti.
- Považování prioru za objektivní nebo jeho nezdokumentování.
- Předpokládání, že vysoká pravděpodobnost (likelihood) automaticky znamená vysoký posterior.
- Interpretace prediktivní asociace jako kauzality.
Podmíněná pravděpodobnost, poměry a důkazy
Bayesova věta spojuje pravděpodobnost hypotézy po důkazu s její předchozí pravděpodobností, pravděpodobností pozorování tohoto důkazu za předpokladu hypotézy a celkovou pravděpodobností důkazu. Ve formě poměrů (odds) posteriorní poměr se rovná priornímu poměru násobenému poměrem pravděpodobností (likelihood ratio). To odděluje, co bylo před testem považováno za pravděpodobné, od toho, jak silně test odlišuje hypotézy. Vysoce přesně se jevící test může stále generovat mnoho falešně pozitivních výsledků, pokud je stav vzácný, protože základní četnost vstupuje do posterioru.
Likelihood je funkcí hypotézy pro daná pozorovaná data a neměla by být zaměňována s pravděpodobností hypotézy. Normalizace důkazu sčítá nebo integruje napříč konkurenčními hypotézami. Předpoklady podmíněné nezávislosti mohou výpočet zjednodušit, jako u Naivního Bayesu, ale je třeba je ověřit vůči důsledkům. Více kusů důkazu nelze násobit jako nezávislé, pokud sdílejí příčiny nebo duplikují informace. Směr kauzality také záleží: P(důkaz|hypotéza) není obecně P(hypotéza|důkaz), což je klasická chyba inverzní pravděpodobnosti.
Volby modelování, výpočet a využití při rozhodování
Bayesovská analýza specifikuje prior, likelihood a posteriorní prediktivní rozdělení. Priory mohou zakódovat zavedené znalosti, regulovat malé vzorky nebo být slabě informativní; měly by být odůvodněny a testovány pomocí analýzy citlivosti. Konjugované modely poskytují analytické aktualizace, zatímco Markov Chain Monte Carlo, variační inference a sekvenční metody aproximují složité postery. Diagnostikujte konvergenci, efektivní velikost vzorku, chybu aproximace a pravděpodobnost priorní predikce místo hlášení jediné posteriorní hodnoty bez výpočetních kontrol.
Posteriorní pravděpodobnost informuje, ale sama o sobě nevybírá akci. Rozhodnutí vyžadují ztráty, přínosy, omezení a dostupné alternativy. Hodnoťte pravděpodobnostní modely pomocí kalibrace, správných skórovacích pravidel a posteriorních prediktivních kontrol na nových datech. Aktualizujte pouze s důkazy získanými v rámci modelovaného procesu; výběrová zkreslenost a posun datové sady mohou likelihood zneplatnit. Komunikujte věrohodné intervaly a předpoklady, aniž byste je představovali jako garantované frekvenční rozsahy. Bayesova věta je přesná pravděpodobnostní algebra, zatímco kvalita bayesovského závěru závisí na modelu a poskytnutých důkazech.
Praktický příklad: interpretace diagnostického testu
Test má 95 % citlivost a 90 % specificitu, ale stav postihuje jen 1 % testované populace. Pro 10 000 lidí se očekává přibližně 95 pravdivě pozitivních a 990 falešně pozitivních výsledků, což dává pozitivní prediktivní hodnotu pod 9 %. Bayesova věta explicitně ukazuje efekt základní četnosti. Výpočet uvádí populaci, prahovou hodnotu testu a nejistotu místo toho, aby propagoval citlivost jako pravděpodobnost, že pozitivní výsledek je správný. Tento rozdíl je také zásadní pro pečlivé datové vědy.
Lékaři aktualizují pravděpodobnost dalším důkazem pouze tehdy, když je modelována závislost mezi testy. Rozhodovací práh zahrnuje škodu z neodhalené nemoci, riziko potvrzovacího testu, náklady a preference pacienta. Kalibrace je kontrolována v místní populaci a změny prevalence spouštějí revizi. Posterior podporuje diskusi a další kroky; nenahrazuje potvrzující diagnózu. Zprávy používají přirozené četnosti a analýzu citlivosti, aby pacienti a odborníci viděli, jak se závěr mění při rozumných předpokladech.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledek každého důležitého selhání. Zaveďte reprodukovatelnou výchozí úroveň a verzi hodnotící sady před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislosti, zneužití a skupiny nebo prostředí, která jsou nejčastěji nedostatečně obsloužena. Měřte kvalitu úlohy společně s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a rozlišit důkazy od atraktivního prototypu.
Před nasazením přiřaďte pravomoc pro vydání, výjimky, změny, rollback a ukončení. Použijte postupné nasazení, zachovejte bezpečnou záložní možnost a ověřte monitorování pomocí záměrně vložených selhání. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky, aniž by sbírala zbytečná citlivá data. Definujte prahové hodnoty upozornění a odpovědnou osobu, poté přezkoumejte reálné důkazy po nasazení místo předpokladu, že offline výkon přetrvá. Přehodnoťte vždy, když se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také potřebuje dokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Jaký je rozdíl mezi pravděpodobnostní funkcí (likelihood) a pravděpodobností?
Při pevně daných parametrech model přiřazuje pravděpodobnost možným datům. Při pevně daných pozorovaných datech lze stejný výraz považovat za pravděpodobnostní (likelihood) funkci nad možnými hodnotami parametrů. Numerický vzorec může být stejný, ale interpretace se liší.
Je Naivní Bayes plná bayesovská inference?
Využívá Bayesovu větu pro klasifikaci za silného modelu podmíněné nezávislosti. Širší bayesovská inference umisťuje rozdělení na neznámé veličiny a uvažuje s posteriorním rozdělením.
Primární odkazy












