
Základy AI
Co je few-shot learning?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Few-shot learning zkoumá, jak se model dokáže přizpůsobit novému úkolu nebo třídě pouze na základě malého počtu označených příkladů. V klasických benchmarkech epizoda poskytuje podpůrnou sadu — například pět tříd s jedním nebo pěti příklady na třídu — a požaduje, aby model klasifikoval neviděné dotazy.
Tento termín se také používá pro učení v kontextu, kdy předtrénovaný jazykový model obdrží několik ukázek v promptu, aniž by aktualizoval své parametry. Obě nastavení mají cíl s malým počtem příkladů, ale používají různé adaptační mechanismy a vyžadují odlišné návrhy hodnocení.
Klíčové poznatky
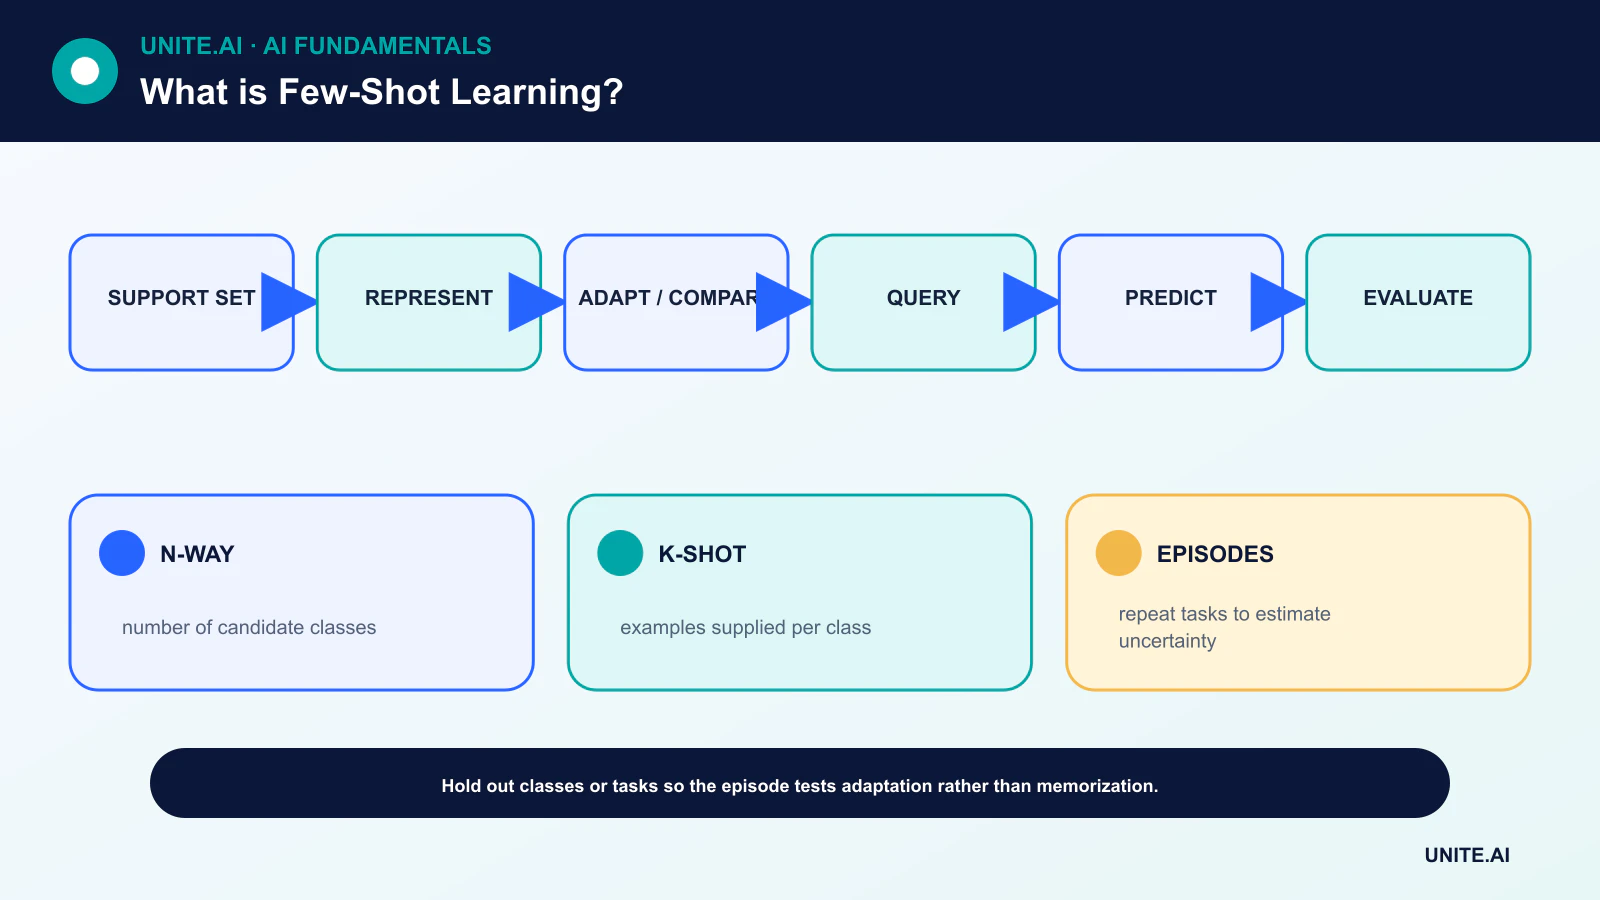
- N‑way K‑shot popisuje N tříd a K označených podpůrných příkladů na třídu.
- Metody metrického učení porovnávají dotazy s naučenými reprezentacemi podpůrných příkladů.
- Meta‑učení optimalizuje napříč mnoha úkoly tak, aby nový úkol mohl být naučen rychle.
- Málo příkladů zesiluje chyby v označování, únik informací, nejasnost tříd a nejistotu, proto jsou důležité základní metody a zprávy o důvěře.
Epizody, podpůrné sady a sady dotazů
Few-shot epizoda odděluje malou označenou podpůrnou sadu od sady dotazů používané pro hodnocení. Během meta‑tréninku model vidí mnoho takových epizod. Silné hodnocení vyčlení celé třídy, úkoly nebo domény, takže testovací epizoda měří adaptaci místo memorování.
Uveďte rozdělení přesnosti napříč mnoha epizodami místo jedné pohodlné vzorku. Porovnejte s jednoduchými metodami nejbližšího souseda a lineárními základními modely; sofistikovaná metoda, která nedokáže překonat dobře naučenou reprezentaci plus základní klasifikátor, nemusí ospravedlnit svou složitost.
Metrické učení a prototypy
Sítě Matching Networks a související metody vkládají podpůrné i dotazové příklady do prostoru, kde by si blízké vektory měly sdílet štítek. Prototypické sítě zprůměrují vkládání podpory pro každou třídu a klasifikují dotaz podle vzdálenosti od těchto třídních prototypů.
Tím se spojuje few-shot učení s kvalitou reprezentace. Předtrénovaný deep-learning model může již dobře organizovat relevantní rysy, zatímco nesprávná reprezentace může každou vzdálenost učinit zavádějící.
Optimalizačně založené meta‑učení
Model-Agnostic Meta-Learning (MAML) hledá parametry, které se dokážou přizpůsobit během několika kroků gradientu. Další metody se učí optimalizátor, inicializaci nebo pravidlo aktualizace parametrů. Vnější smyčka hodnotí výkon po adaptaci napříč úkoly.
Meta‑učení předpokládá, že užitečná struktura je sdílena mezi trénovacími a cílovými úkoly. Když se cílová distribuce výrazně liší, rychlá adaptace může selhat. Validace by měla měnit počet ukázek, počet tříd, domény a obtížnost úkolu místo toho, aby považovala jeden benchmark za univerzální.
Přenosové učení a strategie na úrovni dat
Transfer learning je často nejsilnějším praktickým výchozím bodem — zmrazení předtrénovaného enkodéru, trénink malé hlavy a následné selektivní doladění, pokud je k dispozici dostatek dat. Augmentace dat může zavést invariance, ale nerealistické syntetické příklady mohou zesílit bias nebo vytvořit zkratky.
Aktivní učení může upřednostňovat, které příklady označit, zatímco semi‑supervised learning může využívat další neoznačená data. Jedná se o doplňující strategie, nikoli synonymum pro few-shot learning.
Few-shot prompting se liší
Transformer dokáže odvodit vzor z ukázek umístěných v jeho kontextu. Trvalá aktualizace parametrů není vyžadována. Pořadí, formulace a vyváženost štítků mohou podstatně změnit výstup a ukázky mohou zabírat velkou část kontextového okna.
Používejte reprezentativní evaluační sadu, verzi každého promptu a ukázky a testujte zero-shot, few-shot i doladěné varianty. Malá podpůrná sada nepodporuje silná tvrzení o celé populaci, zejména pro vzácné nebo kritické případy.
Few-shot learning paradigmata a konstrukce úkolů
Few-shot learning usiluje o vykonání úkolu z velmi malého počtu označených příkladů. V metodách založených na metrice enkodér mapuje příklady do prostoru, kde nejbližší prototypy nebo sousedé představují třídy. Optimalizačně založené meta‑učení trénuje inicializaci nebo pravidlo aktualizace pro rychlou adaptaci. Přenosové učení doladí předtrénovaný model na malou cílovou sadu. Učení v kontextu poskytuje příklady v promptu bez aktualizace vah. Tyto mechanismy se liší, takže tvrzení by měla specifikovat, zda dochází ke změně parametrů, jaký předchozí trénink proběhl a jak jsou příklady vybírány.
Hodnocení by mělo oddělit trénovací a testovací třídy, úkoly, subjekty nebo domény podle požadované generalizace. Epizoda N‑way K‑shot obsahuje N tříd a K podpůrných příkladů na třídu, plus dotazové příklady pro skórování. Opakované epizody odhadují varianci z výběru podpory. Pro prompting může pořadí příkladů, formulace štítků, formát a podobnost ukázek podstatně měnit výsledky. Porovnávejte se zero-shot, nejbližším sousedem, lineárním probe, a běžnými doladěnými baselinemi používajícími stejnou reprezentaci a datový rozpočet.
Kvalita dat, nejistota a negativní transfer
U málo příkladů mají špatně označené nebo atypické případy nepřiměřený vliv. Definujte pravidla anotace, prověřte každý podpůrný prvek a zachovejte možnost neznámého nebo odmítnutí výstupu. Augmentace dat a syntetické příklady mohou pomoci jen tehdy, když zachovávají úkol a přidávají realistickou variaci. Předtrénovaný model může přenést zkratky nebo bias ze svého zdrojového doménového kontextu. Testujte out-of-domain případy, vzácné skupiny a citlivost na odstranění jednoho podpůrného příkladu. Uveďte intervaly spolehlivosti napříč úkoly a náhodnými semeny, ne jen jeden příznivý prompt.
Aktivní učení může žádat o štítky u informativních případů, zatímco semi‑supervised metody používají neoznačená data za dalších předpokladů. Retrieval může dynamicky vybírat relevantní ukázky, ale musí se vyhnout úniku testovacích štítků. Adaptace může rychle přeučovat, proto omezujte aktualizace, používejte regularizaci a validujte na oddělených příkladech. Pro úkoly s vysokým rizikem několik štítků zřídka ospravedlňuje autonomní rozhodnutí; model by měl sloužit k prioritizaci nebo asistenci revize, dokud nebudou k dispozici dostatečné důkazy o výsledku.
Provoz v produkci
Verzujte základní model, embedding nebo šablonu promptu, ukázky, schéma štítků a parametry adaptace. Chraňte příklady, protože prompt nebo gradienty mohou odhalit citlivé záznamy. Sledujte výkon při změnách tříd a jazyka a obnovujte podpůrné příklady prostřednictvím řízené revize místo automatického samoznačování. Few-shot learning snižuje požadavek na označená cílová data využitím předchozí struktury; neodstraňuje potřebu reprezentativního hodnocení, pečlivé definice úkolu, doménové expertízy ani bezpečného záložního řešení, když nový úkol spadá mimo předchozí znalosti.
Praktický příklad: few-shot klasifikace pro nový produkt
Tým podpory potřebuje směrovací štítky pro produkt, kde je k dispozici jen pět zkontrolovaných příkladů na problém. Porovnává nejbližší prototypy v předtrénovaném embeddingu, lineární hlavu, parametricky úsporné doladění a in‑context prompting. Produktové rodiny, zákazníci a pozdější zprávy jsou vynechány z meta‑tréninku a výběru modelu. Opakovaný výběr podpůrné sady uvádí recall tříd, kalibraci, varianci a citlivost na jeden špatně označený demonstrační příklad.
Nízkou důvěru a nepodporované zprávy směrují na obecnou podporu a revizoři opravuji štítky prostřednictvím řízené fronty. Příklady jsou anonymizovány, verzovány a nikdy nevybrány z finální testovací sady. Monitoring sleduje novou slovní zásobu, poměry tříd, korekce a nesoulad. Jakmile se nashromáždí dostatek štítků, few-shot systém se porovná s běžným supervizovaným tréninkem. Rychlé nasazení je užitečné, ale neospravedlňuje automatizaci, pokud výkon zůstává nestabilní nebo pokud se nový produkt podstatně liší od předchozích úkolových rodin.
Důkazy o implementaci a připravenost na provoz
Rozhodnutí o nasazení vyžaduje víc než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Zaveďte reprodukovatelný baseline a verzovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadky závislostí, zneužití a skupiny či prostředí, která jsou nejčastěji nedostatečně obsloužena. Měřte kvalitu úkolu společně s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a rozlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoci pro vydání, výjimky, změny, rollback a ukončení. Použijte postupné nasazení, zachovejte bezpečnou zálohu a ověřte monitorování pomocí záměrně vložených selhání. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky bez sběru zbytečných citlivých dat. Definujte prahové hodnoty alarmů a odpovědného, poté po nasazení revidujte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte kdykoli se změní datové zdroje, uživatelé, modely, dodavatelé, zásady, hardware nebo cíle. Udržovaný systém také potřebuje zdokumentované postupy obnovy, učení z incidentů, mazání a archivace a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Je one-shot learning totéž jako few-shot learning?
One-shot learning je speciální případ, kdy je pro každou třídu nebo úkol k dispozici jen jeden označený podpůrný příklad. Zero-shot learning používá žádné označené cílové příklady.
Eliminuje few-shot learning potřebu dat?
Ne. Posouvá závislost směrem k předtrénovacím datům, souvisejícím úkolům, reprezentacím a předpokladům. Cílové štítky jsou málo; celková historie učení je obvykle velká.
Primární reference












