
Základy AI
Co je meta-učení?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Meta-učení trénuje systém napříč rozdělením úloh, aby se dokázal přizpůsobit nové, související úloze s omezenými daty nebo výpočetními zdroji. Často se shrnuje jako “learning to learn”, ale technický cíl je přesnější: optimalizovat učící se model tak, aby zkušenosti z předchozích úloh zlepšovaly adaptaci na pozdější úlohu.
Meta-učení se překrývá s few-shot learning a transfer learning, ale termíny nejsou zaměnitelné. Few-shot popisuje množství cílových dat; transfer popisuje opětovné využití; meta-učení explicitně zahrnuje adaptaci napříč úlohami jako součást tréninku.
Klíčové poznatky
- Meta-trénink používá mnoho úloh, ne jen mnoho nezávislých příkladů.
- Epizoda N‑way K‑shot obsahuje N tříd a K označených podpůrných příkladů pro každou třídu.
- Gradientové, metrické, paměťové a metody s naučeným optimalizátorem se přizpůsobují různými způsoby.
- Výkon silně závisí na tom, zda úlohy meta‑tréninku připomínají cílovou úlohu.
Úlohy, podpůrné sady a dotazové sady
Dataset pro meta-učení je uspořádán jako úlohy. V few-shot klasifikaci může být epizoda 5‑way 1‑shot: pět tříd, jeden označený podpůrný příklad pro každou třídu a další dotazové příklady použité k vyhodnocení adaptace. Úloha 5‑way 5‑shot má pět podpůrných příkladů pro každou z pěti tříd – ne pět příkladů celkem.
Během meta‑tréninku se učící model opakovaně přizpůsobuje na podpůrné sadě a je vyhodnocován na dotazové sadě. Vnější cíl zlepšuje budoucí výkon na dotazech napříč úlohami. Meta‑validace ladí volby na samostatných úlohách a meta‑testování hodnotí skutečně neviděné úlohy nebo třídy.
Gradientové meta-učení
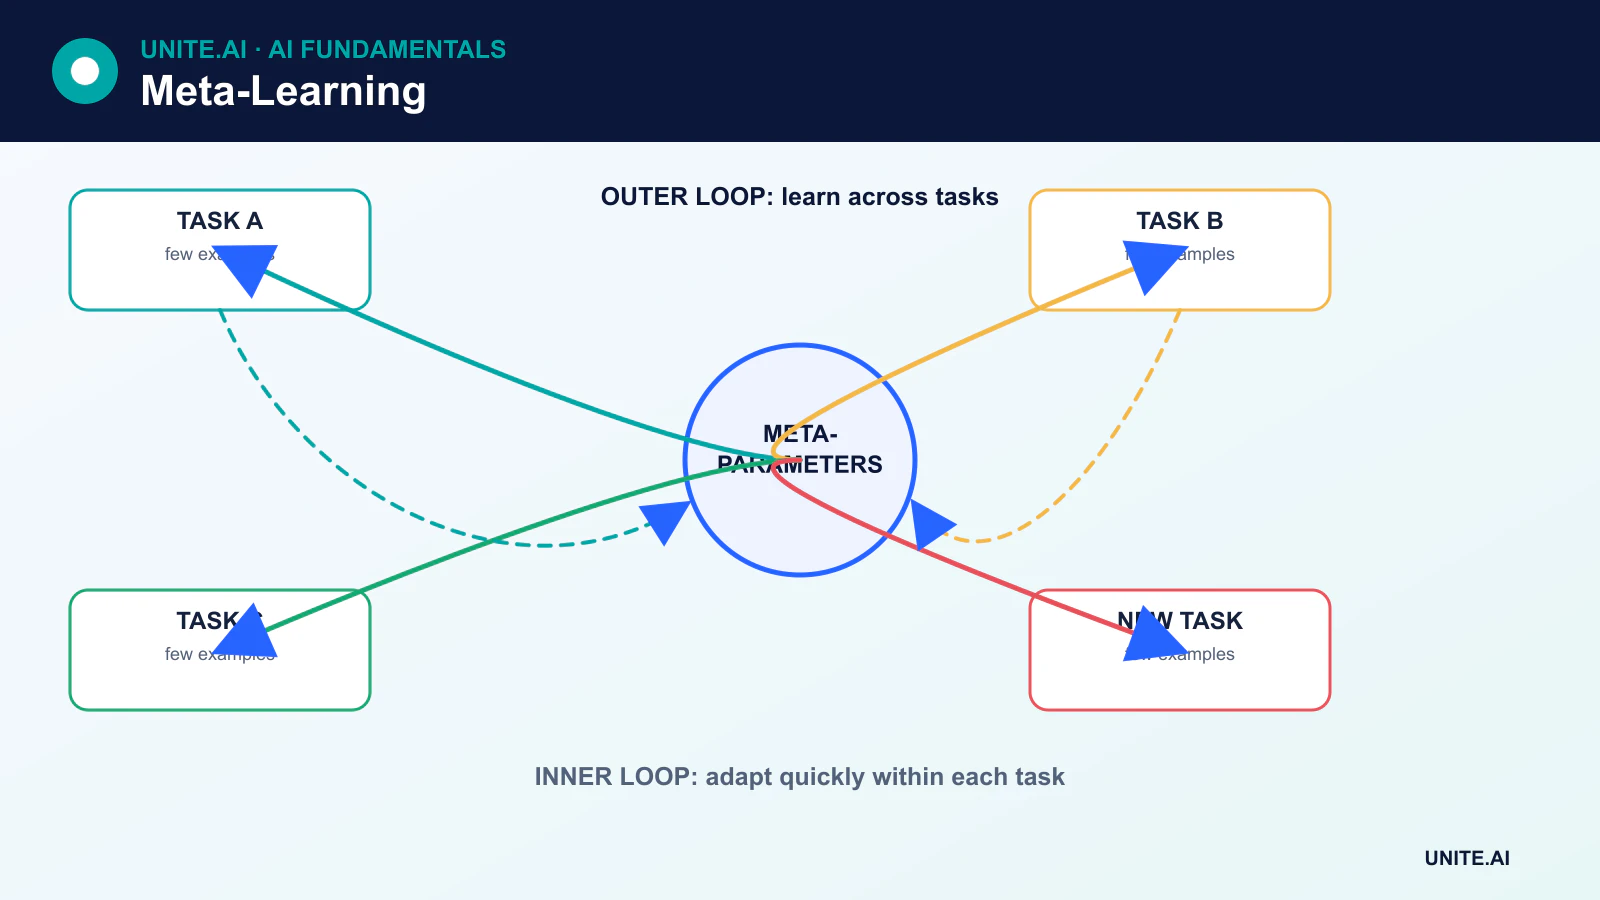
Model-Agnostic Meta-Learning (MAML) se učí inicializaci, ze které malý počet gradientových kroků přináší dobrý výkon na nové úloze. Vnitřní smyčka přizpůsobuje parametry modelu pomocí podpůrných dat. Vnější smyčka aktualizuje sdílenou inicializaci pomocí ztráty na dotazech napříč odebranými úlohami.
MAML není omezeno jen na klasifikaci; lze jej použít i pro regresi a reinforcement learning, pokud jsou model a úloha diferencovatelné. Reptile nabízí jednodušší první‑řádový přístup, který posouvá parametry směrem k řešením přizpůsobeným úloze, aniž by počítal celý meta‑gradient MAML.
Metrické meta-učení
Metrické metody se učí vložení, ve kterém jsou příklady ze stejné třídy blízko a různé třídy jsou odděleny. Prototypová síť průměruje podpůrná vložení a vytváří jeden prototyp pro každou třídu, poté klasifikuje dotazy podle vzdálenosti k těmto prototypům.
Matching a sítě ve stylu Siamese používají související mechanismy podobnosti. Tyto metody neprověřují jen, zda model “zasáhne cílovou metriku”; naučená vzdálenost nebo reprezentace je sama o sobě součástí predikčního postupu.
Paměťové metody a naučené optimalizátory
Paměťové systémy používají rekurentní nebo na pozornosti založený stav k uložení informací o aktuální úloze. Naučené optimalizátory přijímají gradienty nebo tréninkové signály jako vstupy a učí se, jak aktualizovat jiný model. Tyto metody mohou objevit pravidla adaptace, ale přidávají parametry, výpočet a další úroveň možného přeučení.
Meta-učení a učení v kontextu
Velké transformery mohou přizpůsobit svůj výstup na základě příkladů uvedených v promptu, aniž by aktualizovaly váhy. Toto se nazývá učení v kontextu. Připomíná chování meta‑učení a tréninková data mohou podporovat inferenci úlohy, ale učící se v kontextu není automaticky trénováno klasickým epizodickým meta‑učeníovým cílem.
Kde je meta-učení užitečné
Potenciální aplikace zahrnují personalizaci, robotiku, rozpoznávání s nízkými zdroji, vědecké úlohy s málo měřeními a rychlou adaptaci na nové prostředí. Meta-učení je nejatraktivnější, když je k dispozici mnoho souvisejících zdrojových úloh, ale data cílové úlohy jsou omezená.
Omezení
Meta-učení může být výpočetně náročné, protože trénink vkládá adaptaci do optimalizace. Výsledky jsou citlivé na konstrukci úloh, únik podpůrných/dotazových dat, architekturu a posun domény. Model trénovaný na úzkých, homogenních úlohách může špatně adaptovat mimo tuto distribuci.
Srovnání by měla zahrnovat běžné transfer‑learning a multitaskové baseline. Silná předtrénovaná reprezentace následovaná standardním doladěním může být jednodušší a účinnější než specializovaný algoritmus meta‑učení.
Úlohy, adaptace a struktura vnitřní‑vnější optimalizace
Meta-učení trénuje nad rozdělením úloh, aby se učící model mohl přizpůsobit nové úloze s omezenými daty nebo aktualizacemi. Každá epizoda odebere úlohu, rozdělí příklady na podpůrnou sadu použité pro adaptaci a na dotazovou sadu použité pro hodnocení a aktualizuje sdílené znalosti napříč epizodami. Metrické metody se učí vložení a pravidlo porovnání; optimalizační metody se učí inicializaci nebo chování aktualizace; paměťové a modelové metody se podmiňují na příkladech úlohy. Rozdělení úloh je skutečná tréninková data a musí připomínat budoucí adaptační problémy.
V model‑agnostic meta‑learningu vnitřní smyčka adaptuje parametry na podpůrných příkladech a vnější smyčka optimalizuje výkon na dotazových příkladech po adaptaci. Vyšší řády gradientů mohou být nákladné; první‑řádové aproximace vyměňují přesnost za náklady. Prototypové sítě představují každou třídu pomocí centroidu podpůrné sady a klasifikují podle vzdálenosti. Tyto metody předpokládají, že geometrie třídy, kroky adaptace a konstrukce epizod odrážejí nasazení. Metoda může vypadat, že se učí rychle, zatímco využívá pevné štítky, artefakty sběru nebo překrytí mezi zdrojovými datovými sadami.
Vyhodnocení, baseline a omezení v reálném světě
Oddělte tréninkové, validační a testovací úlohy – ne jen příklady – pro měření adaptace na skutečně neviděné úlohy. Uveďte přesnost nebo ztrátu jako funkci počtu shotů a kroků adaptace, intervaly spolehlivosti napříč úlohami, výpočet, paměť a citlivost na složení podpůrné sady. Porovnejte s transfer learningem, doladěním předtrénovaného modelu, nejbližšími sousedy a modelem trénovaným společně na všech zdrojových datech. Mnoho zdánlivých výhod meta‑učení se zmenšuje, když baseline dostane ekvivalentní backbone, augmentaci a ladění.
Reálné nasazení potřebuje způsob, jak rozpoznat, kdy nová úloha leží mimo rozdělení meta‑tréninku. Špatné nebo špatně označené podpůrné příklady mohou způsobit rychlé a jisté selhání. Omezte velikost aktualizace, validujte adaptované modely, zachovejte záložní řešení a chraňte adaptační data před otrávením. Sledujte základní model, sampler úloh, semena epizod a adaptační kód. Meta‑učení je užitečné pro opakované rodiny problémů s malým množstvím dat, ale nevytváří obecnou schopnost učení z libovolných příkladů a neodstraňuje potřebu doménově specifického hodnocení.
Praktický příklad: few-shot adaptace napříč stroji
Výrobce považuje každý typ stroje za úlohu a meta‑trénuje reprezentaci anomálií napříč mnoha stroji s ověřenými výsledky údržby. Testovací stroje jsou z tréninku úloh zcela vyloučeny. Pro nový stroj malá podpůrná sada pokrývá normální provozní režimy místo libovolných minut dat. Meta‑učení je srovnáno s předtrénovaným zamraženým enkodérem, nejbližšími sousedy a běžným doladěním za použití stejných podpůrných příkladů a výpočetního výkonu.
Vyhodnocení opakuje mnoho výběrů podpory a uvádí připomenutí událostí, falešné poplachy, dobu adaptace a variabilitu. Systém se zdržuje, když senzorová sada nebo dynamika nového stroje spadá mimo rozdělení úloh. Aktualizace adaptace jsou omezené a přezkoumány před tím, než ovlivní údržbu. Štítky podpory a identita stroje jsou chráněny před otrávením a každý adaptovaný model si zachovává svou základní verzi a příklady. Rychlá adaptace je přijata jen tehdy, když konzistentně překonává jednodušší transfer při realistickém posunu úloh.
Důkazy o implementaci a operační připravenost
Rozhodnutí o nasazení vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Stanovte reprodukovatelný základ a verziovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislostí, zneužití a skupiny nebo prostředí, která jsou nejvíce nedostatečně obsloužena. Měřte kvalitu úlohy spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přidělte pravomoc pro vydání, výjimky, změny, rollback a ukončení. Použijte postupné nasazení, zachovejte bezpečnou záložní možnost a ověřte monitorování pomocí záměrně vložených selhání. Operační telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky, aniž by shromažďovala zbytečná citlivá data. Definujte prahové hodnoty upozornění a odpovědného za reakci, poté po nasazení přezkoumejte důkazy z reálného světa místo předpokladu, že offline výkon přetrvá. Přehodnoťte, kdykoli se změní zdroje dat, uživatelé, modely, dodavatelé, zásady, hardware nebo cíle. Udržovaný systém také potřebuje dokumentovanou obnovu, učení z incidentů, postupy mazání a uchovávání a jasný bod, kdy má být vypnut nebo nahrazen.
Často kladené otázky
Je few-shot prompting meta-učení?
Few-shot prompting je technika adaptace v kontextu. Může vykazovat chování spojené s učením napříč úlohami, ale není automaticky trénováno pomocí podpůrných/dotazových epizod nebo explicitní meta‑optimalizační smyčkou.
Jaké je největší riziko meta-učení?
Nesoulad mezi úlohami meta‑tréninku a cílovou úlohou může způsobit, že rychlá adaptace vypadá silně v benchmarku, ale selže v nasazení. Rozdělení úloh a původ zdrojů musí být auditovány stejně pečlivě jako běžná rozdělení trénink/test.
Primární reference











