Základy AI
Co je strojové učení?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Strojové učení (ML) je odvětví umělé inteligence, ve kterém systém získává vzory z dat, aby mohl provádět předpovědi, klasifikace, doporučení nebo rozhodnutí, aniž by vývojář musel psát samostatné pravidlo pro každý možný případ. Výsledkem není stroj, který „myslí“ jako člověk. Jedná se o statistický model, který mapuje vstupy na užitečné výstupy a lze jej vyhodnotit na datech, která během tréninku neviděl.
Strojové učení spadá do širšího pole AI, zatímco deep learning je rodina metod strojového učení postavených na vícevrstvých neuronových sítích. Toto rozlišení je důležité: ne každý systém AI používá ML a ne každý problém ML vyžaduje neuronovou síť.
Klíčové poznatky
- ML se učí vztah z příkladů, místo aby se spoléhalo jen na ručně psaná pravidla.
- Užitečný model musí zobecňovat na nová data, nikoli jen memorovat tréninkovou sadu.
- Supervizované, nesupervizované, polosupervizované, samosupervizované a posilovací učení řeší různé typy problémů.
- Kvalita dat, návrh hodnocení a monitorování jsou stejně důležité jako algoritmus.
Jak funguje strojové učení
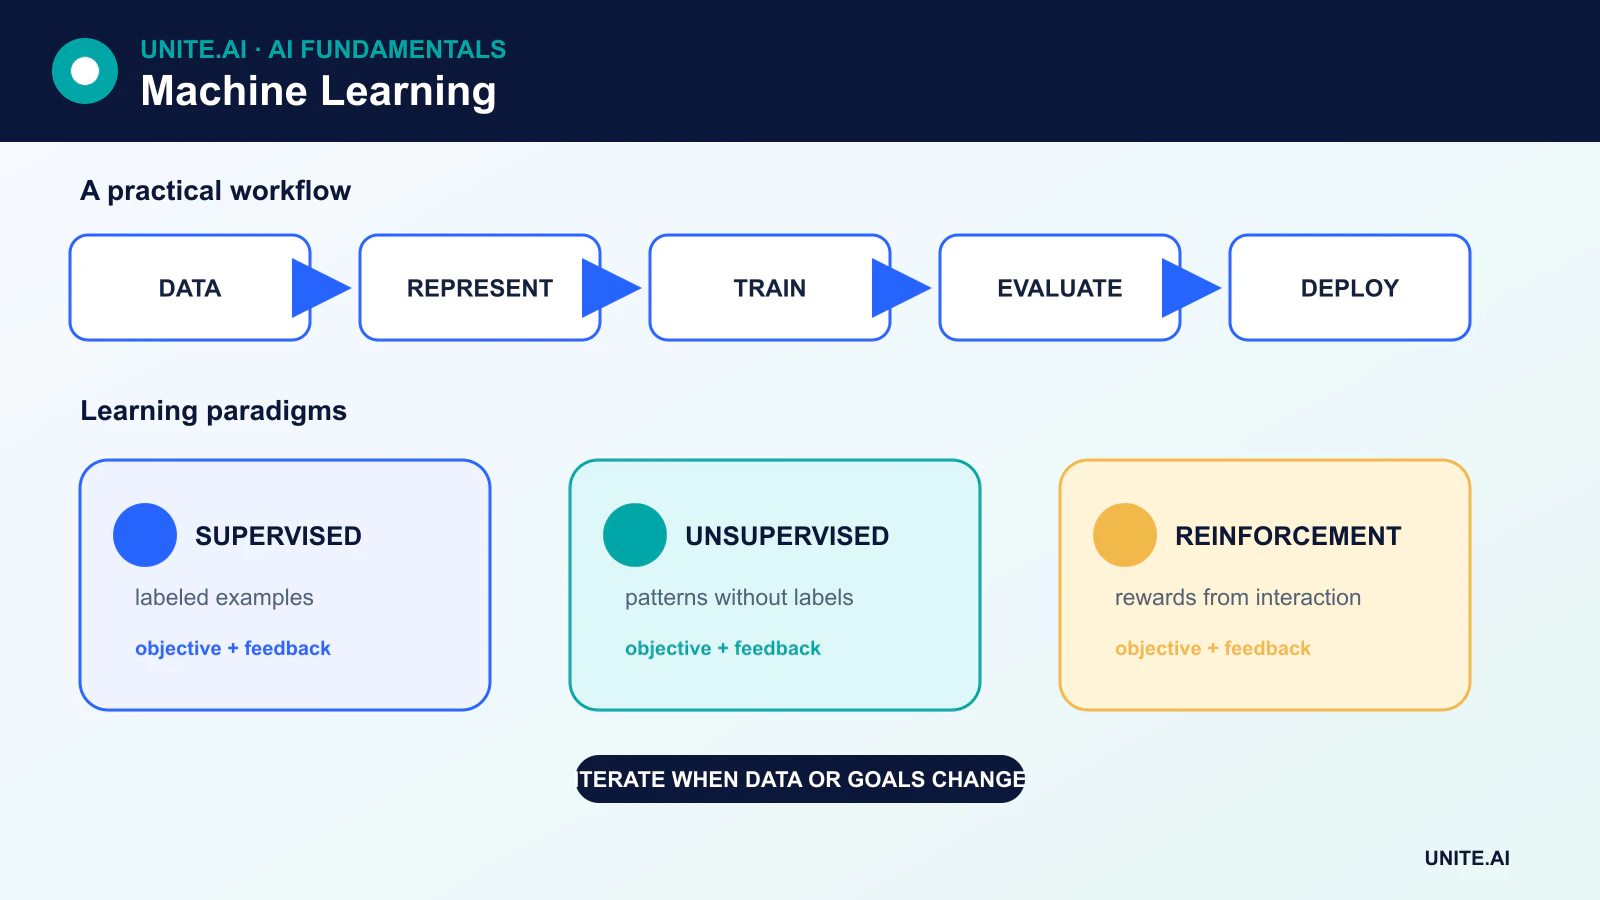
Většinu projektů ML lze pochopit jako posloupnost šesti fází:
- Definovat úkol. Rozhodněte, co by měl systém předpovídat nebo objevovat a co znamená úspěch v reálné aplikaci.
- Shromáždit a připravit data. Vyčistěte záznamy, řešte chybějící hodnoty, vytvořte užitečné rysy a zdokumentujte, odkud data pocházejí.
- Rozdělit data. Trénovací sada se používá k natrénování modelu, validační sada pomáhá vybrat nastavení a testovací sada poskytuje konečný odhad na dosud neviděných datech.
- Trénovat model. Algoritmus upravuje parametry modelu tak, aby snížil ztrátovou funkci nebo splnil jiný učební cíl.
- Vyhodnotit zobecnění. Metryky musí odrážet úkol, rovnováhu tříd, náklady na chyby a populaci, na které bude model fungovat.
- Nasadit a monitorovat. Reálná data se mohou měnit, takže týmy sledují drift, degradaci výkonu, bias a provozní selhání.
Proměnné dodávané modelu se běžně nazývají vlastnosti. V supervizovaném učení se požadovaná odpověď nazývá label nebo target. Naučené parametry modelu kódují vztah mezi vlastnostmi a výstupem; nejsou databází explicitních pravidel.
Hlavní učební paradigma
Supervizované učení
V supervizovaném učení příklady obsahují jak vstupy, tak známé cíle. Klasifikační model předpovídá kategorie, například zda je transakce podvodná. Regresní model předpovídá spojitou hodnotu, například očekávanou poptávku po energii.
Mezi běžné supervizované algoritmy patří rozhodovací stromy, support vector machines, K-nearest neighbors, lineární a logistická regrese, gradientně zesílené stromy a neuronové sítě. Klasifikační práh, například 0,5, je rozhodnutí zvolené po tom, co model vytvoří skóre nebo pravděpodobnost; není to neměnná vlastnost logistické regrese.
Nesupervizované učení
Nesupervizované učení pracuje s daty, která neobsahují cílové štítky. Cílem může být najít shluky, detekovat neobvyklé pozorování, odhadnout rozdělení nebo vytvořit nižší‑dimenzionální reprezentaci. Shluk je skupina navržená podobnostním pravidlem; není automaticky smysluplnou reálnou třídou.
Příklady zahrnují K-means clustering, analýzu hlavních komponent, odhad hustoty a některé formy autoenkodérů. Autoenkodér se učí rekonstruovat svůj vstup pomocí komprimované reprezentace. Automaticky nevytváří pravdivé štítky.
Polosupervizované a samosupervizované učení
Polosupervizované učení kombinuje malou označenou datovou sadu s větší neoznačenou datovou sadou. Samosupervizované učení vytváří tréninkový signál z dat samotných – například předpovídáním maskovaných slov nebo porovnáním dvou transformovaných pohledů na stejný obrázek. Samosupervize je ústřední pro mnoho moderních transformer a základních modelových pipeline, protože může využívat velké sbírky textu, obrázků, audia nebo videa bez nutnosti, aby člověk označoval každý příklad.
Posilovací učení
V posilovacím učení agent provádí akce v prostředí a získává odměny nebo náklady. Cílem je naučit se politiku, která maximalizuje očekávanou kumulativní odměnu. To se liší od supervizovaného učení, protože správná akce není poskytnuta pro každý stav a akce může ovlivnit, jaká data agent příště potká.
Trénink, validace a zobecnění
Model, který dobře funguje na svých tréninkových příkladech, může stále selhat na nových datech. Toto selhání se nazývá overfitting. Týmy jej snižují pomocí vhodné kapacity modelu, regularizace, křížové validace, augmentace dat, prevence úniku a skutečně nezávislé testovací sady.
Neexistuje jediná metrika pro každý úkol ML. Klasifikace může vyžadovat přesnost, recall, F1, kalibraci nebo míru váženou náklady místo čisté přesnosti. Regrese může používat průměrnou absolutní chybu, odmocninu střední kvadratické chyby nebo doménově specifickou ztrátu. Shlukování potřebuje různé formy interního nebo externě validovaného hodnocení. Metrika by měla odrážet, co chyba znamená pro uživatele nebo organizaci.
Algoritmy strojového učení jsou nástroje, ne záruky
Algoritmus nese předpoklady. Lineární modely předpokládají určitý tvar vztahu. K-nearest neighbors předpokládá, že vybraná vzdálenost představuje smysluplnou podobnost. Naivní Bayes předpokládá, že vlastnosti jsou podmíněně nezávislé vzhledem ke třídě. Rozhodovací stromy rozdělují prostor vlastností pomocí naučených pravidel rozdělení; jejich listy obsahují předpovědi založené na skupinách tréninkových pozorování, nikoli nutně na jednom pozorování.
Volba modelu tedy závisí na velikosti dat, typech vlastností, požadavcích na latenci, potřebě interpretovatelnosti a nákladech na chyby. Jednodušší model může překonat větší model, když jsou data omezená nebo provozní omezení upřednostňují rychlost a transparentnost.
Kde se strojové učení používá
ML podporuje řazení ve vyhledávání, doporučení, předpovídání, detekci anomálií, překlad, rozpoznávání řeči, počítačové vidění, prediktivní údržbu, detekci podvodů a vědeckou analýzu. Stejné techniky mohou také zesílit historické zkreslení, odhalit citlivé informace nebo se chovat nepředvídatelně při posunu distribuce. Odpovědné nasazení vyžaduje dokumentaci, lidský dohled tam, kde je to vhodné, bezpečnostní testování a kontinuální monitorování.
Od definice problému k platnému experimentu strojového učení
Projekt strojového učení by měl začínat rozhodnutím a měřitelným výsledkem, nikoli algoritmem. Definujte jednotku předpovědi, cíl, čas pozorování, čas rozhodnutí, dostupné vlastnosti a náklady na každou chybu. Například u modelu odchodu zákazníků by použití událostí zaznamenaných po zrušení úniku odpovědi. Stanovte jednoduché pravidlo nebo statistickou referenci a poté rozdělte data podle času, zákazníka, lokality nebo jiné hranice, která odráží nasazení. Náhodné rozdělení řádků může umístit téměř identické pozorování do tréninkové a testovací sady a vytvořit zavádějící skóre.
Feature engineering převádí surové záznamy na reprezentace, které model může použít, ale každá vlastnost potřebuje původ a záruku dostupnosti. Normalizaci, slovník, imputaci a redukci dimenzionality aplikujte pouze na tréninková data, poté použijte naučenou transformaci na validační a testovací data. Křížová validace odhaduje variabilitu napříč vzorky; konečná nedotčená testovací sada podporuje rozhodnutí o vydání. Vyberte metriky podle důsledků: přesnost a recall pro nerovnoměrné chyby klasifikace, kalibraci, když pravděpodobnosti řídí akci, a míry vážené náklady nebo užitečností, když mají chyby různé provozní dopady.
Nasazení, monitorování a odpovědný provoz
Produkční inference opakuje kompletní transformaci během tréninku a vrací předpověď v rámci omezení latence, propustnosti a dostupnosti. Zabalte předzpracování s modelem, ověřte vstupní schémata, verzujte artefakty a porovnejte výsledky mezi offline a nasazenými implementacemi. Zvolte práh pomocí provozní kapacity a kompromisu chyb místo výchozí hodnoty 0,5. Nasazujte prostřednictvím shadow hodnocení, omezené kohorty nebo experimentu s metrikami ochranných zábran. Uchovávejte deterministický fallback a cestu rollback pro selhání závislostí nebo nepřijatelné chování.
Sledujte kvalitu vstupu, drift vlastností, distribuci předpovědí, kalibraci, výsledky podskupin, latenci, náklady a potvrzené štítky, až dorazí. Drift je signálem k vyšetření, ne automatickým důkazem, že přeškolení pomůže. Přeučování vyžaduje revidovaná data, opakovatelné testy, schválení a srovnání s aktuálním vítězem. Dokumentujte zamýšlené i neplatné použití, práva k datům, soukromí, bezpečnost, lidský zásah a odvolání tam, kde jsou lidé postiženi. Strojové učení je udržovaný rozhodovací systém; soubor modelu je jen jednou vyměnitelnou součástí.
Praktický příklad: předpověď selhání zařízení
Výrobce definuje jednu předpověď na stroj‑den: zda do sedmi dnů nastane ověřené selhání, přičemž používá pouze telemetrii dostupnou na začátku toho dne. Data rozdělí podle stroje a času, porovná s pravidly založenými na věku a prahu, natrénuje předzpracování na tréninkových datech a vyhodnotí recall událostí, falešná upozornění, dobu varování, kalibraci a kapacitu údržby. Výměna senzorů a plánované odstávky jsou modelovány jako provozní kontext, nikoli jako běžná pozorování.
Model nejprve běží ve shadow režimu. Upozornění zobrazují přispívající telemetrii a nejistotu, ale správci rozhodují, zda provést kontrolu. Zjištění a potvrzené příčiny se stávají řízenými štítky; absence pracovního příkazu se nepředpokládá jako absence selhání. Fázované nasazení používá limity upozornění a manuální fallback, zatímco monitorování sleduje stav senzorů, drift vstupů, revidovanou přesnost, výpadky a zbytečnou údržbu. Přeučování proběhne až po revizi dat a prahů, která prokáže pravděpodobné zlepšení oproti aktuálnímu nasazenému systému.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Stanovte reprodukovatelnou referenci a verzovanou evaluační sadu před laděním. Testujte běžné případy, okrajové podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislostí, zneužití a skupiny či prostředí, která jsou nejpravděpodobněji nedostatečně obsloužena. Měřte kvalitu úkolu spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoc pro vydání, výjimky, změny, rollback a ukončení. Použijte fázované nasazení, zachovejte bezpečný fallback a ověřte monitorování pomocí záměrně vložených selhání. Provozní telemetrie by měla odhalit kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky bez sběru zbytečných citlivých dat. Definujte prahy upozornění a odpovědného za reakci, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte, kdykoli se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také vyžaduje dokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný okamžik, kdy by měl být deaktivován nebo nahrazen.
Primární reference