
Základy AI
Co jsou neuronové sítě?

 Přidejte Unite.AI mezi své preferované zdroje na Google
An umělá neuronová síť je parametrizovaný matematický model složený z vrstev propojených operací. Během trénování síť upravuje své parametry tak, aby vstupy byly mapovány na užitečné výstupy. Neuronové sítě dokážou aproximovat složité nelineární vztahy a učit se reprezentace přímo z textu, obrázků, zvuku, časových řad a dalších dat.
Název je historicky inspirován biologickými neurony, ale moderní sítě jsou inženýrské systémy spíše než realistické simulace mozku. Výrazy jako „neuron“ a „učení“ jsou užitečná zkratka a neměly by být zaměňovány za důkaz lidské podobnosti kognice.
Klíčové body
- Neuron vypočítá vážený součet, přidá trénovatelný bias a použije aktivační funkci.
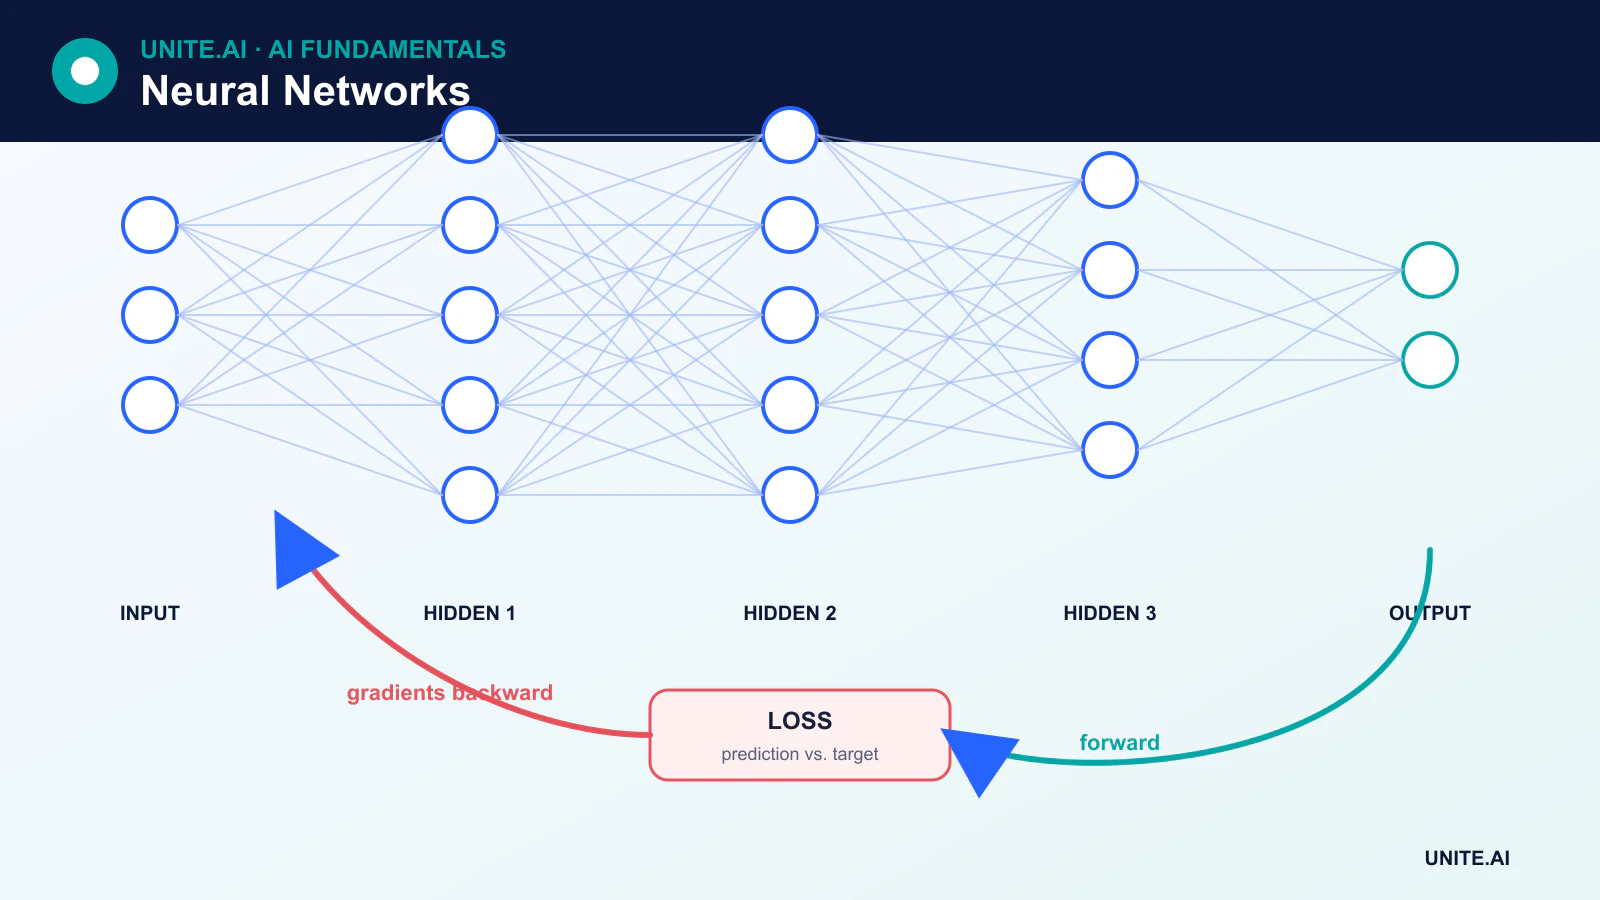
- Přední průchod vytváří predikce; ztrátová funkce měří chybu; zpětná propagace vypočítá gradienty; optimalizátor aktualizuje parametry.
- MLP, CNN, RNN a transformátory organizují spojení odlišně.
- Více vrstev nebo parametrů automaticky nevede k lepšímu nebo spolehlivějšímu modelu.
Od jediného umělého neuronu po síť
Pro vstupní vektor x základní jednotka vypočítá:
z = Wx + boutput = activation(z)
W obsahuje trénovatelné váhy a b je trénovatelný bias. Aktivační funkce zavádí nelinearitu. Váhy samy „neprocházejí“ aktivací; aktivace se aplikuje na vážený součet a bias.
Multivrstvý perceptron (MLP) skládá husté vrstvy. Vstupní vrstva představuje rysy, skryté vrstvy je transformují a výstupní vrstva je navržena pro konkrétní úlohu – například logity tříd nebo regresní hodnotu.
Jak se neuronové sítě učí
- Model inicializuje trénovatelné parametry.
- Přední průchod zpracuje dávku a vytvoří predikce.
- Ztrátová funkce porovnává predikce s tréninkovým cílem.
- Backpropagation používá řetězové pravidlo k výpočtu gradientů.
- Optimalizátor, jako je stochastický gradientní sestup nebo AdamW, aktualizuje váhy a biasy.
Backpropagation se stala ústředním prvkem trénování neuronových sítí díky práci vyvíjené a popularizované během několika desetiletí; nebyla poprvé vytvořena v nedávné éře hlubokého učení. Moderní frameworky implementují automatickou diferenciaci v reverzním režimu, takže uživatelé nemusí ručně odvozovat každý gradient.
Proč jsou aktivační funkce důležité
Bez nelineárních aktivací se více běžných lineárních vrstev sloučí do jedné lineární transformace. ReLU je široce používána, protože je jednoduchá a efektivní. GELU a SiLU jsou běžné v moderních architekturách. Sigmoid a softmax zůstávají užitečné pro specifické interpretace výstupu, avšak sigmoid může v skrytých vrstvách nasycovat a přispívat k mizení gradientů.
Hlavní architektury neuronových sítí
Konvoluční neuronové sítě
CNNs aplikují naučené filtry přes lokální sousedství a sdílejí parametry napříč pozicemi. Tyto vlastnosti je činí efektivními pro obrázky a další signály podobné mřížce.
Rekurentní sítě
RNNs, LSTMs, and GRUs aktualizují skrytý stav během sekvence. Stále jsou užitečné pro streaming a úlohy časových řad, ačkoliv rekurence omezuje paralelní zpracování a může mít potíže s dlouhými závislostmi.
Transformátory
Transformers používají pozornost k vytváření kontextově závislých reprezentací. Zbytkové spojení, normalizace, poziční informace a bloky feed-forward jsou základní součástí architektury. Transformátory nyní tvoří základ mnoha velkých jazykových a multimodálních modelů.
Autoenkodéry a generativní sítě
Autoencoders se učí reprezentace prostřednictvím rekonstrukce. GANs, difuzní modely a autoregresivní sítě generují nové vzorky pomocí různých cílů a tréninkových postupů.
Komponenty, které umožňují trénovatelnost hlubokých sítí
Moderní systémy používají více než jen vrstvy a aktivace. Zbytková spojení umožňují informacím a gradientům obcházet bloky. Normalizace stabilizuje aktivace. Regularizace, augmentace dat, dropout a útlum váhy mohou snížit přeučení. Vrstvy vkládání (embedding) mapují diskrétní položky, jako jsou tokeny, na vektory. Pozornost umožňuje, aby reprezentace dynamicky závisela na dalších prvcích.
Silné stránky a omezení
Neuronové sítě mohou učit rysy z vysoce dimenzionálních surových dat a škálovat s množstvím dat a výpočetní kapacitou. Mohou však také vyžadovat velké datové sady, specializovaný hardware a pečlivé ladění. Jejich predikce mohou být špatně kalibrované, křehké při posunu distribuce, zranitelné vůči adversariálním útokům nebo obtížně vysvětlitelné.
Architektura by měla odpovídat úloze a nasazovacím omezením. Pro mnoho tabulkových problémů může být stromový ensemble nebo lineární model rychlejší a snazší k validaci. Pro aplikace s vysokými sázkami musí být výkonnost modelu hodnocena podle podskupin a režimů selhání, nejen podle souhrnného benchmarku.
Vrstvy, aktivace a tok informací
Neuronová síť skládá parametrizované funkce. Každá jednotka tvoří váženou kombinaci vstupů, přidá bias a výsledek projde aktivací, jako je ReLU, sigmoid, tanh nebo GELU. Vrstvení vrstev umožňuje hierarchické rysy a nelineární rozhodovací hranice. Šířka řídí počet jednotek ve vrstvě; hloubka řídí následné transformace; konektivita a sdílení vah definují architekturu. Výstup sítě závisí na předzpracování, parametrech, normalizaci a režimu inference dohromady. Neuron je matematická operace, nikoli doslovný biologický neuron nebo samostatně smysluplný pojem.
Přední propagace vypočítává predikce; ztráta kvantifikuje chybu; zpětná propagace aplikuje řetězové pravidlo na gradienty; optimalizátor aktualizuje parametry. Inicializace, učební rychlost, statistiky dávky, zbytkové cesty a normalizace ovlivňují, zda gradienty mizí, explodují nebo zůstávají užitečné. Regularizace zahrnuje útlum váhy, dropout, augmentaci, předčasné zastavení a architektonická omezení. Vykreslete chování tréninku a validace, prozkoumejte statistiky gradientů a aktivací a porovnejte opakované běhy. Velká síť může zapamatovat tréninková data, zatímco malá může podfitovat nebo postrádat potřebnou strukturu.
Výběr architektury, hodnocení a nasazení
Multivrstvé perceptrony zpracovávají pevné vektory; konvoluční sítě využívají lokální strukturu; rekurentní a state-space modely zpracovávají sekvence; transformátory používají pozornost; grafové sítě vyměňují informace podél hran. Hybridy jsou běžné. Volte na základě induktivního biasu, dat, velikosti sekvence nebo obrazu, latence, paměti, interpretovatelnosti a dostupného hardwaru. Hodnoťte vůči lineárnímu nebo stromovému baseline a provádějte ablaci, abyste zjistili, která složitost má význam. Pouze počet parametrů nepredikuje kvalitu, náklady na inference nebo požadavek na data.
Nasazení vyžaduje zmražené předzpracování, exportovaný nebo zkompilovaný graf, numerickou validaci a testy zdrojů při realistickém zatížení. Kvantizace a ořezávání mohou zmenšit velikost, ale mohou změnit chování vzácných tříd. Sledujte vstupy, výstupy, kalibraci, latenci a potvrzené výsledky; testujte adversariální a posunutá data. Chraňte modely, závislosti a data pomocí podepsaných artefaktů, řízení přístupu a revize dodavatelského řetězce. Vysvětlení z jednotlivých aktivací nebo saliency vyžadují kauzální a behaviorální verifikaci. Neuronové sítě jsou flexibilní aproximátory funkcí, nikoli záruky porozumění, pravdy nebo robustnosti.
Praktický příklad: neuronový prognostik poptávky
Maloobchodník předpovídá týdenní poptávku po položkách na základě prodejů, akcí, ceny, svátků, dostupnosti a počasí. Síť je srovnávána s sezonně naivními, lineárními a stromovými baseline pomocí posuvných časových rozdělení. Budoucí akce jsou zahrnuty pouze tehdy, když jsou skutečně známy v čase prognózy, zatímco výpadky zásob jsou modelovány, protože pozorované prodeje mohou podhodnocovat poptávku. Hodnocení používá váženou absolutní chybu, bias, pokrytí intervalů a výsledky podle rychlosti položky a obchodu.
Nasazovací pipeline verze zahrnují dostupnost funkcí, model a horizont a odmítne prognózu, pokud jsou požadované vstupy zastaralé. Plánovači vidí intervaly a mohou je přepsat zaznamenanými důvody. Monitorování detekuje chybějící kanály, měnící se chybu, bias a neobvyklé prognózy; obchodní výsledky jsou odděleny od přesnosti prognózy, protože objednávková politika také ovlivňuje zásoby. Aktualizace modelu je stínována během několika cyklů a předchozí prognostik zůstává k dispozici pro rollback během sezónních nebo dodavatelských výpadků.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledek každého důležitého selhání. Zaveďte reprodukovatelný baseline a verzovaný evaluační soubor před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislosti, zneužití a skupiny nebo prostředí, která jsou nejpravděpodobněji nedostatečně obsloužena. Měřte kvalitu úlohy spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoci pro vydání, výjimky, změny, rollback a ukončení. Použijte postupné nasazení, zachovejte bezpečnou záložní možnost a ověřte monitorování pomocí úmyslně vložených selhání. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, zdraví závislostí, lidské zásahy a potvrzené výsledky, aniž by sbírala zbytečná citlivá data. Definujte prahy upozornění a odpovědného, poté přezkoumejte reálné důkazy po nasazení místo předpokladu, že offline výkon přetrvá. Přehodnoťte kdykoli se změní zdroje dat, uživatelé, modely, dodavatelé, zásady, hardware nebo cíle. Udržovaný systém také potřebuje zdokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být vypnut nebo nahrazen.
Často kladené otázky
Je každá neuronová síť hluboké učení?
Ne. Malá síť s jednou skrytou vrstvou je neuronová síť, zatímco hluboké učení se obecně vztahuje na architektury s více naučenými zpracovatelskými stupni. Hranice je konvenční, nikoli přísný vědecký práh.
Ukládají neuronové sítě svá tréninková data?
Ukládají naučené parametry, nikoli běžnou prohledávatelnou kopii datové sady. Přesto mohou velké modely memorovat a reprodukovat jednotlivé tréninkové příklady, což vytváří rizika soukromí a autorských práv, která je třeba testovat.
Primární reference












