
Základy AI
Co je redukce dimenzionality?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Redukce dimenzionality představuje data s menším počtem proměnných při zachování informací užitečných pro úlohu. Může snížit úložiště a šum, zlepšit vizualizaci, omezit nadbytečné rysy a usnadnit trénink následných modelů.
Žádná metoda neuchovává všechny vztahy. Užitečná redukce začíná vymezením toho, co má přežít: varianci, oddělení tříd, lokální sousedství, globální geometrii, kvalitu rekonstrukce nebo interpretovatelnost.
Klíčové poznatky
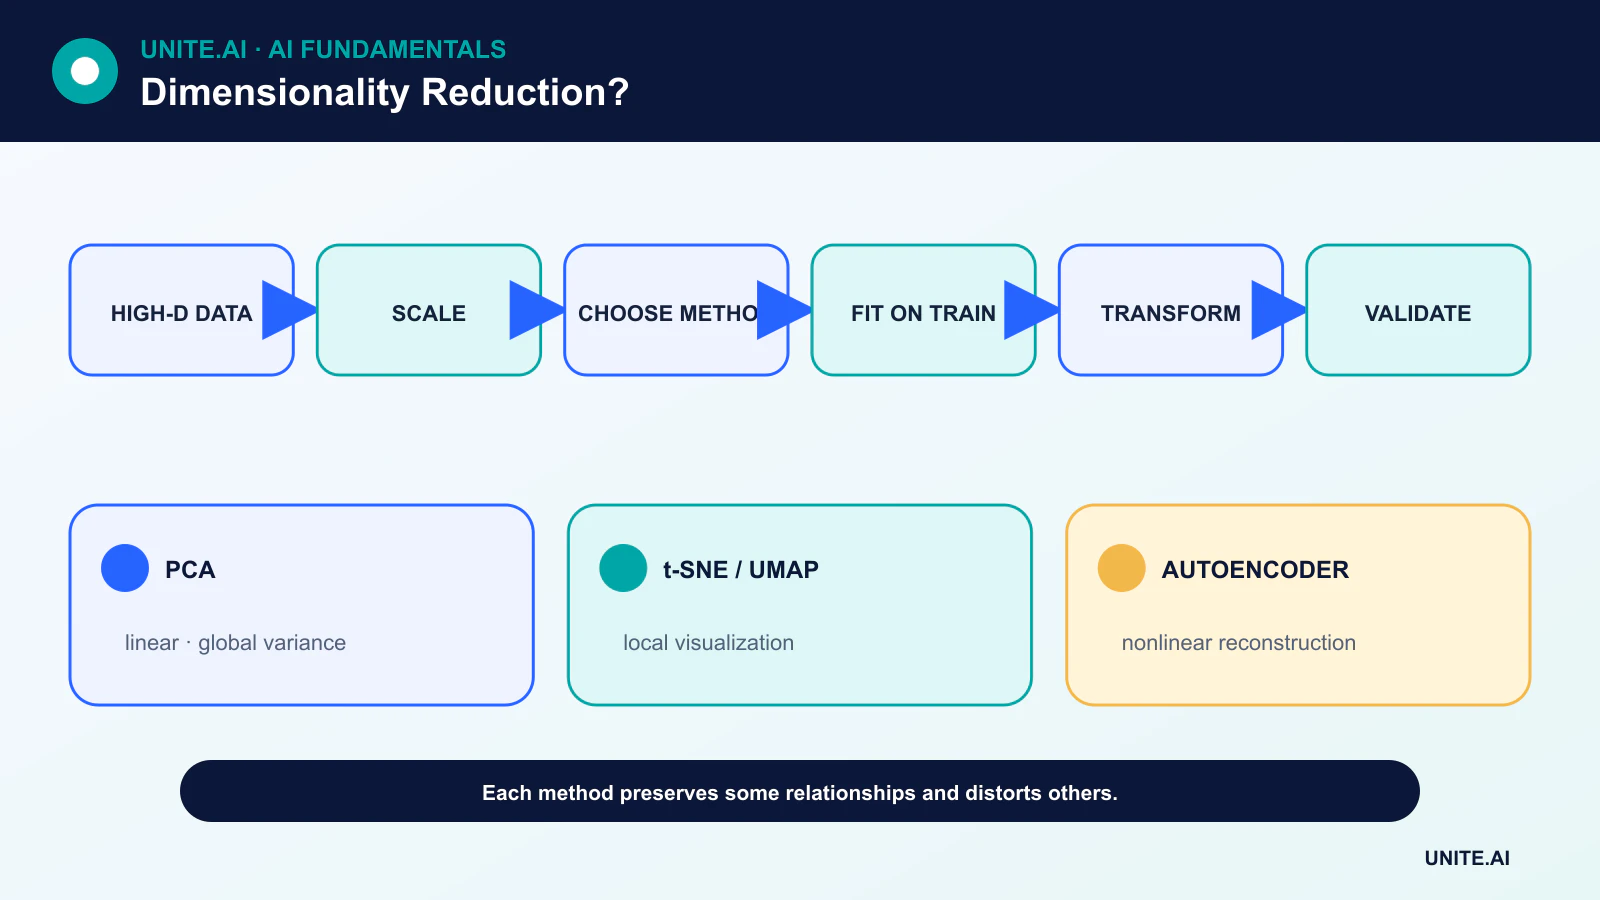
- Výběr rysů zachovává původní proměnné; extrakce rysů vytváří nové nižší‑dimenzionální souřadnice.
- PCA je lineární a zaměřená na varianci; t‑SNE a UMAP zdůrazňují strukturu sousedství pro vizualizaci.
- Vizualizační embedování může zkreslovat vzdálenosti, velikosti shluků a globální oddělení.
- Redukci aplikujte jen na tréninková data a poté použijte naučenou transformaci na validační a testovací data.
Výběr rysů versus projekce
Výběr rysů odstraňuje proměnné pomocí doménových pravidel, chybějících hodnot, redundance, prediktivních testů nebo regularizace. Zachovává původní významy, což může napomoci správě a vysvětlitelnosti.
Projekční metody kombinují proměnné do nových souřadnic. Dokážou zachytit distribuovanou strukturu, ale mohou ztížit interpretaci jednotlivých souřadnic. Autoenkodér se učí nelineární projekci prostřednictvím rekonstrukce.
PCA a SVD
Analýza hlavních komponent (PCA) identifikuje ortogonální směry klesající variance po vycentrování dat. Rozklad singulárních hodnot (SVD) poskytuje běžnou numerickou cestu. Škálování má význam: jednotka s vysokou variancí může dominovat komponentám.
PCA je deterministická až na znaménko a opakované vlastní hodnoty, podporuje transformaci mimo vzorek a poskytuje souhrny vysvětlené variance. Vysoká variance není vždy relevantní pro úlohu a lineární komponenty nemohou rozvinout každou zakřivenou mnohost.
t‑SNE a UMAP
t‑SNE vytváří pravděpodobnostní rozdělení nad sousedy a optimalizuje nízkodimenzionální mapu, která zdůrazňuje lokální podobnost. UMAP buduje vážený graf sousedství a optimalizuje nízkodimenzionální reprezentaci s cíli souvisejícími s lokální strukturou.
Obě jsou výkonné nástroje pro průzkum, ale jsou citlivé na předzpracování, metriku vzdálenosti a hyperparametry. Prázdný prostor, plocha shluku a vzdálenost mezi shluky v 2D grafu by neměly být automaticky interpretovány jako reálné.
Supervizované metody a úlohou orientované reprezentace
Lineární diskriminační analýza (LDA) používá štítky tříd k hledání oddělení, čímž se liší od nesupervizované PCA. Učení neuronových reprezentací může optimalizovat predikci nebo kontrastní cíle místo rekonstrukce.
Pokud štítky řídí redukci, veškeré fitování a ladění musí zůstat uvnitř tréninkového procesu. Jinak může informace z testovací sady uniknout do výběru modelu a vytvořit optimistický výsledek.
Výběr a validace metody
Začněte předzpracováním a jednoduchým referenčním modelem. Pro kompresi měřte rekonstrukci nebo výkon následných úloh napříč dimenzemi. Pro vizualizaci testujte stabilitu napříč semeny a hyperparametry a porovnávejte zachování sousedství s doménovým znalostmi.
Pro produkci se zeptejte, zda metoda dokáže transformovat nové záznamy, jak zachází s chybějícími hodnotami, zda se mění při opětovném tréninku a zda uživatelé potřebují vysvětlení původních rysů. Přeučení může nastat i v kroku redukce, stejně jako v konečném modelu.
Lineární a nelineární metody redukce
Redukce dimenzionality mapuje vysoce dimenzionální data do menšího počtu souřadnic při zachování vybrané struktury. Analýza hlavních komponent nachází ortogonální směry maximální variance po vycentrování; škálování je potřeba, když jednotky mají přispívat srovnatelně. Rozklad singulárních hodnot vypočítává související nízkohodnotnou strukturu a podporuje řídké matice. Lineární diskriminační analýza používá štítky k nalezení směrů oddělujících třídy. Tyto metody poskytují explicitní transformace, ale variance nebo oddělení tříd nemusí zachovat informace potřebné pro následnou úlohu.
Metody mnohostroje, jako t‑SNE a UMAP, konstruují sousedství a optimalizují nízkodimenzionální rozložení. Jsou výkonné pro průzkum, ale zkreslují globální vzdálenost, hustotu, velikost shluku a někdy i oddělení. Výsledky závisí na předzpracování, metrice, počtu sousedů nebo perplexitě, inicializaci a semeni. Atraktivní shluk ve dvou rozměrech může vzniknout i bez diskrétních skupin. Používejte více nastavení, barvy aplikujte jen podle metadat, která nebyla použita při fitování, a ověřujte zdánlivou strukturu v původním prostoru nebo s nezávislými štítky.
Výběr rysů, embedování a hodnocení
Výběr rysů zachovává původní proměnné pomocí filtrů, obalů nebo důležitosti založené na modelu; učení reprezentací vytváří nové latentní rysy pomocí autoenkodérů nebo supervizovaných modelů. Náhodné projekce přibližně zachovávají vzdálenosti za určitých podmínek a nabízejí efektivní referenční body. Zvolte metodu podle komprese, vizualizace, redukce šumu, rychlosti, úložiště nebo výkonu modelu. Reduktor fitujte jen na tréninkových datech a poté transformujte validační a testovací sady. Supervizovaná redukce musí být vnořena do křížové validace, aby se zabránilo úniku štítků.
Pro lineární kompresi vyhodnocujte vysvětlenou varianci nebo rekonstrukci, pro vizualizaci spolehlivost a zachování sousedství, a pro predikci následnou přesnost, kalibraci, latenci a robustnost. Měřte stabilitu napříč vzorky a semeny. Zkontrolujte, zda jsou vzácné třídy nebo citlivé skupiny sloučeny a zda je možná inverzní mapování. Redukované souřadnice mohou stále obsahovat soukromé informace; dvourozměrný graf není anonymizací. Dokumentujte transformaci, škálovač, pořadí rysů a omezení.
Použití v produkci
Nasazení vyžaduje přesnou natrénovanou transformaci a vstupní schéma. Sledujte chybějící rysy, posun rozsahu, distribuci skóre komponent, chybu rekonstrukce a následné výsledky. Pokud se objeví nové kategorie nebo senzory, znovu trénujte a verzujte celý pipeline místo tichého přidávání sloupců. Redukce může zlepšit výpočetní výkon a odšumět model, ale může také odfiltrovat slabé signály důležité pro vzácné události. Považujte ji za naučený měřicí krok, jehož zachované i ztracené informace je třeba otestovat vůči rozhodnutí.
Praktický příklad: redukce rysů chování zákazníků
Analytik standardizuje 200 měřítek chování a aplikuje PCA jen na tréninkové zákazníky. Křížová validace volí počet komponent podle výkonu následného odlivu a stability, nikoli podle dvourozměrného rozptylového grafu. Načítání jsou kontrolována na dominující zdroje a chybějící hodnoty. PCA, výběr rysů, náhodná projekce a neredukovaný regularizovaný model jsou porovnávány z hlediska kalibrace, latence a výsledků pro vzácné segmenty zákazníků. Opakované vzorky také testují, zda hlavní komponenty a následné závěry zůstávají stabilní.
Nasazený pipeline fixuje pořadí rysů, škálovač a komponenty a odmítá chybějící verze schématu. Monitoring sleduje distribuce komponent, chybu rekonstrukce a následné výsledky. Vizualizace s apparentními shluky se používá k vytváření otázek, nikoli k přiřazování zákaznických person. Protože latentní komponenty stále kódují chování, přístup a uchování zůstávají kontrolovány. Pokud se změní definice zdrojů, celý transform a model jsou znovu postaveny a validovány místo projekce nekompatibilních dat do starých komponent.
Důkazy o implementaci a operační připravenost
Rozhodnutí o nasazení vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Zaveďte reprodukovatelný výchozí stav a verzovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadky závislostí, nesprávné použití a skupiny nebo prostředí, která jsou nejpravděpodobněji nedostatečně obsloužena. Měřte kvalitu úlohy spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoc pro vydání, výjimky, změny, rollback a ukončení. Použijte postupné nasazení, zachovejte bezpečný fallback a ověřte monitoring s úmyslně injektovanými selháními. Provozní telemetrie by měla odhalit kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky bez sběru zbytečných citlivých dat. Definujte prahové hodnoty upozornění a odpovědného za reakci, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte kdykoli se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také potřebuje zdokumentované postupy obnovy, učení z incidentů, mazání a uchování a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Zlepšuje redukce dimenzionality vždy model?
Ne. Může odfiltrovat prediktivní informace nebo ztížit interpretaci. Porovnejte s referenčním modelem bez redukce na vyhrazených datech.
Dokazují oddělené shluky t‑SNE, že skutečně existují třídy?
Ne. Mapa je optimalizovaná vizualizace vztahů sousedství a může vytvořit zdánlivé oddělení. Ověřte shluky nezávislým důkazem.
Primární reference












