
Základy AI
Co je hluboké učení?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Hluboké učení je rodina metod strojového učení, které používají neuronové sítě s více zpracovatelskými vrstvami k získávání užitečných reprezentací dat. Tyto modely pohánějí mnoho moderních systémů pro jazyk, obrázky, audio, doporučování, vědecké předpovědi a generativní AI.
Slovo deep odkazuje na počet transformací mezi vstupem a výstupem, nikoli na to, že stroj má hlubší porozumění. Hluboký model se učí číselné vztahy, které jsou užitečné pro jeho tréninkový cíl, a jeho výkon je stále nutné testovat na nových datech.
Klíčové body
- Hluboké učení je podmnožinou strojového učení.
- Vrstvy transformují tensory pomocí naučených parametrů, nelineárních aktivací, normalizace a dalších operací.
- Zpětná propagace vypočítává gradienty; optimalizátor používá tyto gradienty k aktualizaci trénovatelných parametrů, včetně vah a biasů.
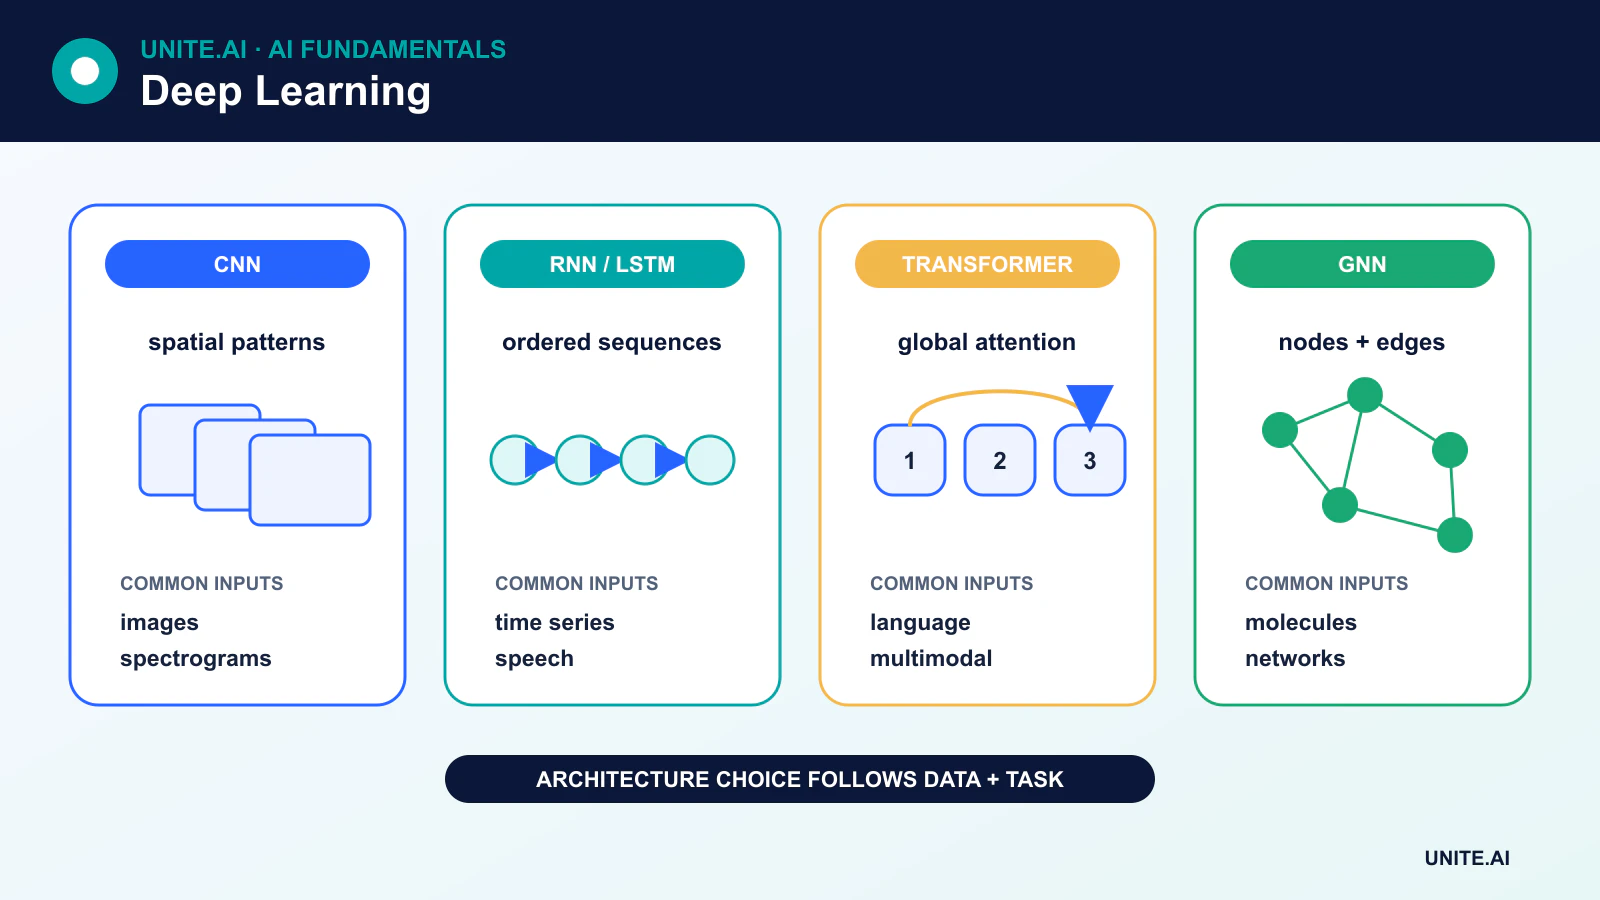
- CNN, rekurentní sítě, transformery, autoenkodéry a difúzní modely mají různé struktury a silné stránky.
Jak se učí hluboká neuronová síť
Neuronová síť přijímá data jako tensory, tedy vícerozměrná pole čísel. Tensor obrázku může kódovat kanály pixelů, zatímco jazykový model používá vektory představující tokeny. Každá vrstva provádí diferencovatelnou transformaci a předává výsledek další vrstvě.
V základní husté vrstvě model vypočítá vážený součet svých vstupů, přidá trénovatelný bias a poté použije aktivační funkci:
output = activation(Wx + b)
Aktivační funkce zavádí nelinearitu. Bez ní by skládání běžných lineárních vrstev stále představovalo pouze lineární transformaci. ReLU a její varianty jsou běžné ve skrytých vrstvách, zatímco výstupní aktivace závisí na úkolu.
Trénink obvykle zahrnuje čtyři kroky:
- forward pass vytváří predikce.
- loss function měří, jak se predikce liší od cíle.
- Backpropagation použije řetězové pravidlo k výpočtu gradientu ztráty vzhledem k jednotlivým trénovatelným parametrům.
- Optimalizátor, jako je stochastic gradient descent nebo AdamW, aktualizuje parametry.
Opakování těchto kroků po mnoho batchů může model zlepšit, ale nižší tréninková ztráta nezaručuje spolehlivé chování v reálném světě. Validace, regularizace, reprezentativní data a monitorování zůstávají nezbytné.
Hlavní architektury hlubokého učení
Vícevrstvé perceptrony
Vícevrstvý perceptron (MLP) používá plně propojené vrstvy, ve kterých každý výstupní jednotka závisí na všech vstupech z předchozí vrstvy. MLP jsou užitečné pro tabulární rysy a jako komponenty ve větších systémech, ale neobsahují předpoklady o lokálnosti obrazu nebo pořadí sekvence.
Konvoluční neuronové sítě
Konvoluční neuronové sítě (CNN) aplikují naučené filtry na lokální oblasti. Sdílení vah je činí efektivními pro mřížky jako jsou obrázky a spektrogramy. CNN zůstávají důležité pro počítačové vidění a nasazení na okraji, ačkoliv vision transformery a hybridní modely jsou také široce používány.
Rekurentní sítě, LSTM a GRU
Rekurentní neuronové sítě (RNN) aktualizují skrytý stav během zpracování sekvence. LSTM a gated recurrent units pomáhají zachovat informace a snižovat problém mizejících gradientů, který způsobuje, že základní RNN mají problémy s dlouhými závislostmi. Neodstraňují všechny omezení dlouhého kontextu, ale jsou užitečné pro streamování signálů, časové řady a kompaktní sekvenční modely.
Transformery
Transformery používají attention k modelování vztahů mezi prvky sekvence nebo množiny. Jejich schopnost paralelně zpracovávat mnoho pozic jim pomohla nahradit rekurenci ve většině rozsáhlých jazykových systémů a varianty transformerů nyní zpracovávají obrázky, audio, video, proteiny a multimodální data.
Autoenkodéry a generativní modely
Autoenkodér komprimuje vstup do reprezentace a z ní vstup rekonstruuje. Tím vzniká samosupervizní cíl rekonstrukce; automaticky nepřevádí neoznačená data na označené příklady.
Generativní adversariální sítě (GAN) trénují generátor a diskriminátor v soutěži. Difúzní modely se učí obracet postupný proces šumu. Autoregresivní transformery generují jeden token nebo jednotku po jedné. Tyto přístupy mají různé dynamiky tréninku, ovladatelnost a výpočetní nároky.
Proč hloubka pomáhá – a proč je architektura důležitá
Více vrstev umožňuje modelu skládání jednodušších transformací do složitějších. Ve vizuálním zpracování mohou některé naučené rysy postupovat od lokálních textur k úkolově specifickým vzorům. V jazyce vrstvy attention budují kontextově závislé reprezentace tokenů. Tyto popisy jsou užitečné intuice, nikoli pevná pravidla, co každá vrstva musí naučit.
Moderní sítě také spoléhají na reziduální spojení, normalizaci, pečlivou inicializaci, regularizaci a optimalizovaný hardware. Pouhé přidání vrstev nebo parametrů může model učinit těžší na trénink, pomalejší nebo náchylnější k overfittingu. Škála modelu pomáhá jen tehdy, když data, cíl, optimalizace a nasazení tuto možnost podporují.
Trénink versus inference
Trénink upravuje parametry a je obvykle výpočetně náročnou fází. Inference spouští natrénovaný model k vytvoření výstupu. Inference může být stále nákladná pro velké modely, proto týmy používají kvantizaci, destilaci, batchování, cachování, řídkost a specializovaný hardware jako neuronové procesorové jednotky.
Omezení a zodpovědné používání
Hluboké modely mohou zdědit bias, zapamatovat si citlivé informace, selhat při posunu distribuce a produkovat přesvědčivé, ale nesprávné výstupy. Mohou být také obtížně interpretovatelné a nákladné na trénink. Hodnocení by mělo zahrnovat více než průměr benchmarku: týmy potřebují výkonnost na úrovni třídy nebo podskupiny, robustnost, kalibraci, bezpečnost, latenci, spotřebu energie a důsledky selhání.
Reprezentace, optimalizace a volby architektury
Hluboké sítě se učí postupné reprezentace skrze parametrizované vrstvy. Lineární transformace míchají vstupy; nelineární aktivace umožňují síti aproximovat složité funkce; normalizace a reziduální spojení pomáhají optimalizaci; attention, konvoluce, rekurence nebo operace stavového prostoru kódují různé strukturální předpoklady. Hloubka zvyšuje počet transformací, nikoli zaručenou inteligenci. Architektura by měla odrážet modalitu, objem dat, latenci, paměť a invariance úkolu. Menší konvoluční model může překonat transformer, když jsou data omezená a dominuje lokální prostorová struktura.
Trénink vypočítá ztrátu, diferencuje ji pomocí zpětné propagace a aktualizuje parametry pomocí optimalizátoru, jako je stochastic gradient descent nebo Adam. Velikost batch, učební rychlost, plán, inicializace, regularizace a číselná přesnost spolu interagují. Křivky tréninkové a validační ztráty pomáhají rozlišit podtrénování, overfitting, nestabilitu a únik, ale neprokazují užitečnost v reálném světě. Používejte nezávislá evaluační data, opakované běhy, kde variance záleží, ablace a srovnání s jednoduššími baseline. Velký počet parametrů také zvyšuje potřebu správy dat, plánování výpočetního výkonu a reprodukovatelné konfigurace.
Nasazení hlubokých modelů bezpečně a efektivně
Nasazení může využívat hostovaný endpoint, dedikovaný akcelerátor, prohlížeč, telefon nebo vestavěné zařízení. Export a kompilace mohou sloučit operátory, kvantizovat váhy a aktivace nebo změnit číselné chování, proto ověřte nasazený artefakt, nikoli jen tréninkový checkpoint. Měřte cold start, stabilní latenci, propustnost, paměť, spotřebu energie a kvalitu při realistických velikostech batch a sekvence. Metody komprese – ořezávání, destilace, kvantizace a adaptace nízkého řádu – vyměňují velikost nebo rychlost za přesnost a technickou složitost a musí být posouzeny na citlivých třídách a okrajových případech.
Hluboké modely mohou selhat sebejistě při posunu distribuce, adversariálním vstupu, falešné korelaci a špatně reprezentovaných skupinách. Sledujte distribuce vstupů a výstupů, výsledky úkolu, kalibraci, využití zdrojů a verze závislostí. Používejte řízení přístupu, podepsané artefakty, chráněná tréninková data, red teaming a limitování rychlosti vhodné pro model hrozby. Vysvětlení jako saliency mapy nebo pohledy attention jsou diagnostické důkazy, nikoli důkaz příčinnosti. Kombinujte je s behaviorálními testy, kontrafaktuálními scénáři, lidským přezkumem, reakcí na incidenty a explicitními limity automatizovaných rozhodnutí.
Praktický příklad: trénink detektoru vad na obrázcích
Továrna sbírá obrázky produktů z různých kamer, směn, materiálů a známých tříd vad, poté je rozděluje podle výrobní šarže, aby se blízké duplikáty nepřekrývaly. Malý konvoluční baseline se porovnává s předtrénovanou hlubokou sítí. Augmentace reprodukuje ověřené osvětlení a variaci úhlů pohledu bez vymazání vad. Hodnocení uvádí recall na úrovni jednotlivých vad, míru falešného odmítnutí, kalibraci, latenci inference a robustnost vůči rozmazání, oslnění, výměně kamery a vzácným barvám materiálu.
Exportovaný model a přesný kód pro změnu velikosti, barvu a normalizaci jsou testovány na hardwaru linky pro udržitelné propustnost a tepelný chování. Případy s nízkou důvěrou jsou předány inspektorům; nezávislé pravidlo zastaví linku při selhání kritického senzoru. Obrázky jsou uchovávány jen podle povolení a artefakty modelu jsou podepsané. Monitorování spojuje predikce s následnými výsledky inspekcí a výrobními šaržemi. Nová kamera nebo materiál spustí kontrolované přehodnocení místo tichého online učení z neprověřených štítků.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Zaveďte reprodukovatelný baseline a verzovanou evaluační sadu před laděním. Testujte běžné případy, okrajové podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislostí, zneužití a skupiny či prostředí, která jsou nejvíce opomíjena. Měřte kvalitu úkolu spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoc pro vydání, výjimky, změny, rollback a ukončení. Použijte postupné nasazení, zachovejte bezpečný fallback a ověřte monitorování s úmyslně vloženými selháními. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky bez sběru zbytečných citlivých dat. Definujte prahy alertů a odpovědnost za reakci, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte vždy, když se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také potřebuje zdokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být deaktivován nebo nahrazen.
Primární reference












