
Základy AI
Co jsou RNN a LSTM v hlubokém učení?

 Přidejte Unite.AI mezi své preferované zdroje na Google
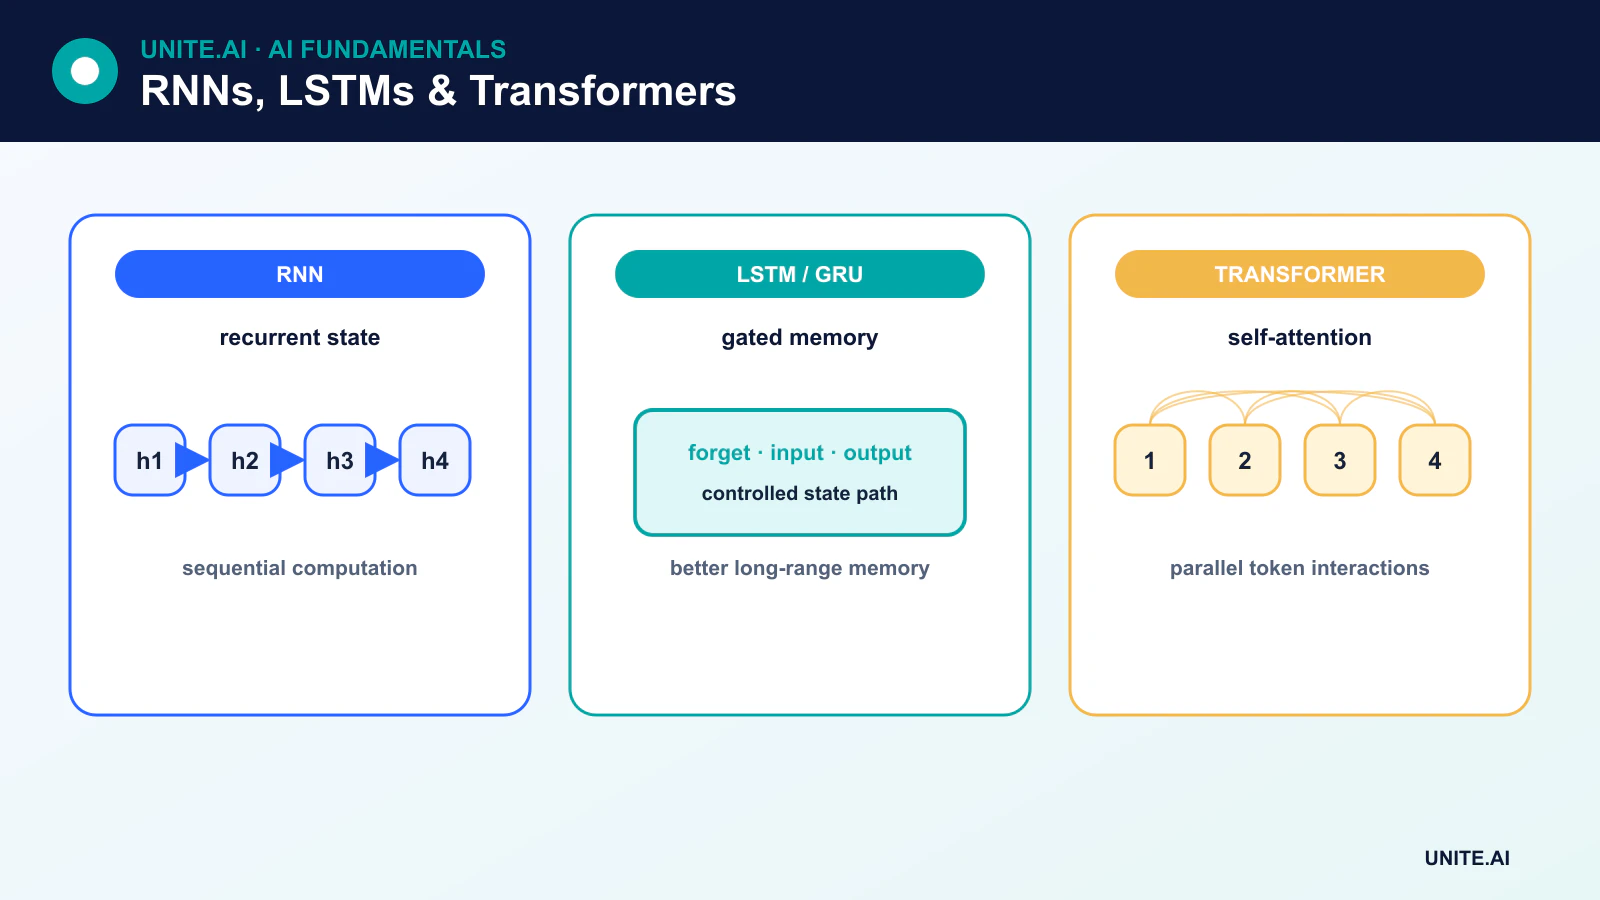
Rekurentní neuronové sítě (RNN) zpracovávají sekvence aktualizací skrytého stavu v čase. Long short-term memory (LSTM) sítě jsou řízené RNN navržené tak, aby uchovávaly a kontrolovaly informace účinněji než základní rekurentní jednotka.
RNN a LSTM dříve dominovaly mnoha jazykovým úlohám, ale moderní velké chatboty jsou převážně založeny na transformerech. Rekurentní modely zůstávají užitečné pro streamování, časové řady, řeč, řízení a systémy s omezenými zdroji, kde je důležitý inkrementální stav a nízká latence.
Klíčové poznatky
- RNN znovu používá stejné parametry v každém kroku sekvence a přenáší skrytý stav dopředu.
- Trénink v čase může způsobit mizerné nebo explodující gradienty.
- LSTM přidává stav buňky a vstupní, zapomínací a výstupní brány.
- Transformery zpracovávají dlouhodobé vztahy a paralelní trénink odlišně; žádná architektura není nejlepší pro každé nasazení.
Jak funguje základní RNN
V kroku t jednoduchá rekurentní jednotka kombinuje aktuální vstup xₜ s předchozím skrytým stavem hₜ₋₁:
hₜ = activation(Wₓxₜ + Wₕhₜ₋₁ + b)
Skrytý stav je naučený souhrn používaný pro další krok a v závislosti na úloze i výstup. „Rozvinutý“ diagram vykresluje jednu kopii pro každý časový krok, ale všechny kopie sdílejí parametry. Výstup není jen jednoduše zkopírován zpět jako nový surový vstup; rekurence předává skrytý stav skrze definovanou transformaci.
Zpětná propagace v čase
RNN se trénují pomocí zpětné propagace v čase (BPTT). Rozvinutá sekvence tvoří hluboký výpočetní graf a zpětná propagace vypočítává, jak ztráta závisí na sdílených rekurentních parametrech.
Opakované násobení může způsobit, že gradienty klesnou k nule nebo neomezeně rostou. Mizející gradienty brání učení dlouhých závislostí; explodující gradienty způsobují nestabilní aktualizace. Ořezávání gradientů řeší explodující gradienty, zatímco brány, inicializace, normalizace a kratší tréninková okna mohou pomoci.
Uvnitř buňky LSTM
LSTM udržuje stav buňky cₜ kromě skrytého stavu hₜ. Jeho brány jsou naučené, na datech závislé ovládací prvky:
- Zapomínací brána řídí, kolik předchozího stavu buňky se zachová.
- Vstupní brána řídí, kolik kandidátních informací se zapíše.
- Výstupní brána řídí, kolik informací buňky přispívá ke skrytému stavu.
Sigmoidové výstupy mezi nulou a jednou fungují jako měkké brány, zatímco tanh‑transformovaný kandidát poskytuje nový obsah. Přídavná cesta stav buňky pomáhá gradientům přetrvávat, ale LSTM nezaručují neomezenou paměť ani neodstraňují všechny optimalizační problémy.
GRU a obousměrná rekurence
Gated recurrent unit (GRU) kombinuje bránové mechanismy do jednodušší rekurentní buňky bez samostatného stavu buňky ve stylu LSTM. GRU mohou trénovat rychleji a dosahovat podobných výsledků u některých úloh.
Obousměrný RNN zpracovává kompletní sekvenci v obou směrech a kombinuje stavy. Může využívat budoucí kontext pro označování nebo kódování, ale není vhodný pro kauzální streamování, když budoucí vstupy ještě nejsou k dispozici.
Modely sekvence‑na‑sekvenci
RNN typu enkodér‑dekodér mapují jednu sekvenci na druhou. Pozornost (attention) byla zavedena, aby dekodér mohl konzultovat různé stavy enkodéru místo spoléhaní se na jeden pevný vektor. Tento směr vedl k architektuře transformer, která nahradila rekurenci bloky založenými na pozornosti.
RNN vs transformery
Transformery zpracovávají tréninkové pozice paralelně a vytvářejí krátké pozornostní cesty mezi vzdálenými tokeny. RNN zpracovávají stav sekvenčně, což omezuje paralelismus, ale poskytuje během streamování stav konstantní velikosti. Inference transformeru může vyžadovat rostoucí mezipaměť klíč‑hodnota, zatímco RNN komprimuje historii do svého skrytého stavu a může ztratit detail.
Volbu určujte podle délky sekvence, rozsahu dat, hardwaru, latence, paměti a toho, zda je úloha offline nebo streamovaná. Hybridní a stavové architektury nabízejí další kompromisy.
Aktuální případy použití
RNN a LSTM jsou stále relevantní pro předpovídání, detekci anomálií, zpracování senzorů, komponenty řeči, ruční psaní, vestavěné řízení a modelování sekvencí s nízkou latencí. Nejsou výchozím vysvětlením pro současné velké jazykové modely nebo AI chatboty.
Rekurence, brány a paměť sekvence
Rekurentní neuronová síť zpracovává sekvenci kombinací aktuálního vstupu se skrytým stavem přenášeným z předchozích kroků. Sdílené váhy umožňují proměnnou délku sekvence a rozvinutí odhaluje výpočet v čase pro trénink. Základní RNN dokážou reprezentovat časovou závislost, ale gradienty opakovaně násobené napříč dlouhými sekvencemi mají tendenci mizet nebo explodovat. Zkrácená zpětná propagace omezuje paměť a výpočet, zatímco ořezávání gradientů kontroluje extrémní aktualizace. Skrytý stav je naučený souhrn, ne věrná zásoba každého předchozího tokenu.
Long short-term memory sítě přidávají stav buňky a vstupní, zapomínací a výstupní brány, které regulují zápis, uchování a vystavení informací. Gated recurrent units používají jednodušší strukturu resetu a aktualizace. Obousměrné varianty využívají budoucí kontext a proto nemohou streamovat kauzálně bez zpoždění. Stohované, reziduální a pozorností rozšířené rekurentní modely zvyšují kapacitu. Padding a masky musí zabránit, aby umělé sekvenční elementy ovlivnily stav nebo ztrátu, a stav by měl být resetován na skutečných hranicích sekvence, aby se předešlo úniku mezi příklady.
Trénink, srovnání a stavové nasazení
RNN a LSTM zůstávají užitečné pro streamování, kompaktní modely na zařízení, časové řady a pracovní zatížení, kde je sekvenční stav efektivní. Transformery paralelizují trénink a modelují dlouhodobé interakce odlišně, ale mohou vyžadovat větší paměť a cache. Porovnávejte architektury podle přesnosti, latence, propustnosti, paměti, spotřeby energie a výkonu při změně délky sekvence. Hodnoťte předpovědi pomocí posuvných časových rozdělení, jazyk pomocí sekvenčně‑citlivých metrik a detekci anomálií pomocí měření na úrovni událostí. Sledujte selhání po dlouhých mezerách, změnách režimu, chybějících vzorcích a náhlých hranicích sekvence.
Stavové nasazení musí přiřadit skrytý stav správné relaci, nastavit jeho expiraci, šifrovat jej, pokud je citlivý, a resetovat po chybách nebo změnách modelu. Události mimo pořadí nebo duplikáty mohou stav poškodit; zahrňte časové razítka, čísla sekvence a idempotenci. Monitorujte stáří stavu, délku sekvence, chybějící data, drift výstupu a latenci. Kvantizace vyžaduje validaci citlivou na brány, protože malé číselné změny se mohou časem akumulovat. Paměť RNN umožňuje kontext, ale může také uchovávat soukromé nebo zastaralé informace, takže retenční a uživatelské kontroly patří do návrhu.
Praktický příklad: LSTM pro streamování senzorových sekvencí
Užitečná aplikace používá LSTM k předpovědi krátkodobé zátěže na základě nedávných měření, kalendáře a počasí. Sekvence jsou vytvářeny s přísným časovým pořadím; skrytý stav se resetuje na hranicích napájecích zdrojů a padding je maskován. Sezónně‑naivní a gradient‑boostované baseline jsou porovnávány s LSTM napříč posuvnými okny. Testy zahrnují chybějící intervaly, zpožděné počasí, svátky, výpadky a délky sekvencí přesahující typický trénink.
Streamovací služba přiřazuje stav jednomu napájecímu zdroji, odmítá duplikáty mimo pořadí a expiruje stav po dlouhých mezerách nebo aktualizacích modelu. Bezpečná statistická předpověď nahrazuje výstup, když jsou senzory nebo stav neplatné. Kvantizovaná inference je kontrolována na dlouhých sekvencích kvůli akumulovanému driftu. Monitorování sleduje stáří stavu, chybějící data, latenci, bias a chybu intervalu. Model je přeškolen pouze po změnách rozvodu a revize výsledků ukazuje, že naučené časové vztahy již neobecňují.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení do produkce vyžaduje víc než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Zaveďte reprodukovatelný výchozí stav a verzovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadky závislostí, nesprávné použití a skupiny nebo prostředí, která jsou pravděpodobně nedostatečně obsloužena. Měřte kvalitu úlohy společně s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a prahovou hodnotu, aby nezávislý recenzent mohl výsledek reprodukovat a rozlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoci pro vydání, výjimky, změny, rollback a ukončení. Použijte fáze nasazení, zachovejte bezpečnou zálohu a ověřte monitorování pomocí úmyslně zavedených selhání. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav zdraví závislostí, lidské zásahy a potvrzené výsledky bez sběru zbytečných citlivých dat. Definujte prahové hodnoty alarmů a odpovědného vlastníka, poté po nasazení revidujte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte kdykoli se změní zdroje dat, uživatelé, modely, dodavatelé, zásady, hardware nebo cíle. Udržovaný systém také potřebuje zdokumentované postupy obnovy, učení z incidentů, mazání a uchovávání dat a jasný bod, kdy by měl být deaktivován nebo nahrazen.
Často kladené otázky
Je LSTM vždy lepší než základní RNN?
Ne. Brány pomáhají řešit mnoho problémů s dlouhými závislostmi, ale zvyšují výpočetní náročnost a počet parametrů. Základní RNN může být dostačující pro krátké, jednoduché sekvence, a jiná architektura může být lepší pro velmi dlouhý kontext.
Může LSTM zpracovat neomezenou historii?
Ne. Jeho stav má omezenou kapacitu, gradienty a tréninková data ukládají limity a relevantní detaily mohou být přepsány. Výkon při dlouhém kontextu je nutné měřit, nikoli jen odvozovat z názvu architektury.
Primární reference












