
Základy AI
Co je ensemble learning?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Učení pomocí ansámblu kombinuje předpovědi z více modelů. Hlavní myšlenkou je, že modely s různými chybami mohou dosáhnout přesnějšího nebo stabilnějšího výsledku, když se jejich výstupy zprůměrují, hlasují nebo předají meta‑učiteli.
Přidání modelů nestačí. Pokud se každý člen naučil stejnou zkratku, jejich chyby budou korelované a ansámbl může jen zesílit důvěru ve stejnou chybu.
Klíčové poznatky
- Ansámbly fungují nejlépe, když jsou jednotlivé modely užitečné a dělají podstatně odlišné chyby.
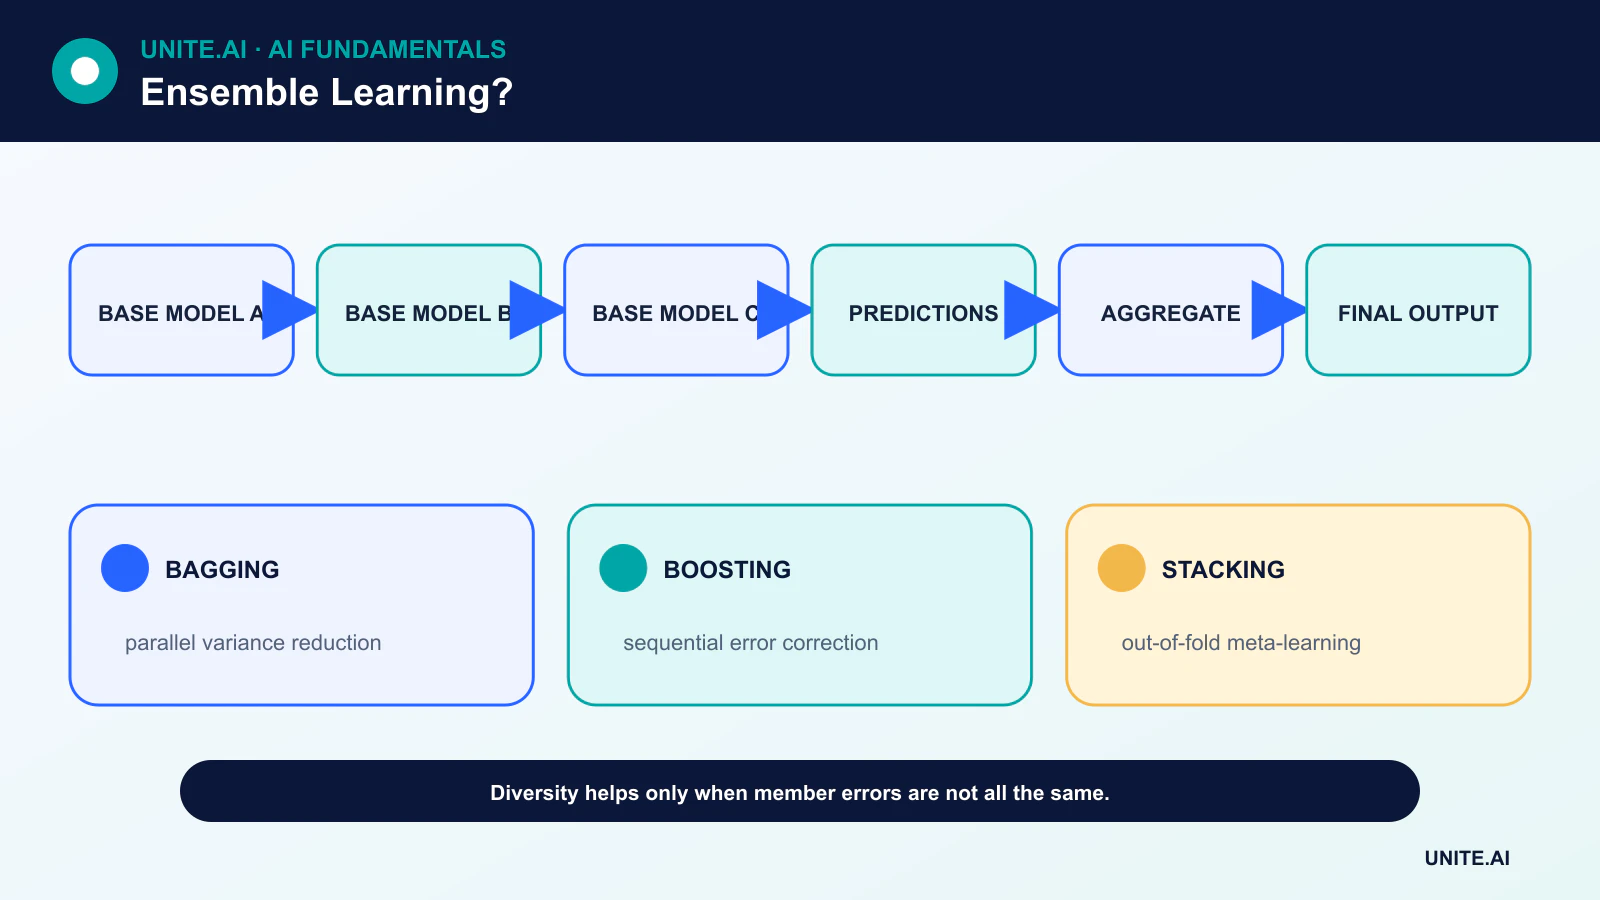
- Bagging trénuje členy paralelně na resamplovaných datech; boosting trénuje učitele sekvenčně, aby opravoval chyby.
- Stacking trénuje meta‑model na predikcích mimo skládku (out‑of‑fold), nikoli na predikcích v rámci tréninkových dat.
- Zisky v přesnosti je třeba vyvážit proti latenci, kalibraci, interpretovatelnosti a nákladům na údržbu.
Hlasování a průměrování
Tvrdo‑hlasování (hard voting) vybírá třídu s nejvíce hlasy. Měkké hlasování (soft voting) zprůměruje pravděpodobnosti tříd, obvykle po kalibraci. Regresní ansámbly často průměrují číselné předpovědi. Vážené verze dávají větší vliv silnějším členům.
Průměr může snížit rozptyl, pokud chyby nejsou dokonale korelované. Nemůže opravit společnou datovou vadu, chybu štítku nebo chybějící podskupinu. Rozmanitost by měla být měřena nesouladem a překryvem chyb, nikoli předpokládána jen na základě různých názvů modelů.
Bagging a náhodné lesy
Bootstrap aggregating (bagging) trénuje modely na resamplovaných datových sadách a průměruje je. Rozhodovací strom má vysoký rozptyl, což z něj dělá přirozeného kandidáta pro bagging.
Náhodné lesy přidávají náhodný výběr příznaků při rozděleních, čímž snižují korelaci mezi stromy. Příklady out‑of‑bag lze použít k odhadu výkonnosti, ale finální nedotčená testovací sada zůstává cenná pro výběr modelu a tvrzení o nasazení.
Boosting
Boosting vytváří aditivní model po etapách. Pozdější učitelé se zaměřují na příklady nebo reziduální vzory, které současný ansámbl zvládá špatně. AdaBoost mění váhy příkladů; gradient boosting přizpůsobuje učitele záporným gradientům zvolené ztrátové funkce.
Boostované stromy dokážou modelovat složité tabulkové vztahy, ale hluboké stromy, příliš mnoho kol a únik informací mohou stále vést k přeučení. Klíčovými parametry jsou rychlost učení, hloubka stromu, podvzorkování a předčasné zastavení.
Stacking a blending
Stacking vytváří model druhé úrovně, který se učí, jak kombinovat základní predikce. Aby se předešlo úniku informací, každý tréninkový řádek pro meta‑model musí pocházet ze základního modelu, který na tomto řádku nebyl trénován. Křížová validace generuje tyto out‑of‑fold predikce.
Blending používá samostatnou holdout sadu pro meta‑model, což je jednodušší, ale snižuje množství dat dostupných pro trénink. Oba přístupy vyžadují stejnou předzpracování a správu verzí při inferenci.
Operační kompromisy
Ansámbl může násobit paměť, výpočetní nároky a typy selhání. Může být obtížnější jej vysvětlit, kalibrovat a konzistentně aktualizovat. Distilace může ansámbl zkomprimovat do menšího modelu, ale student musí být hodnocen nezávisle.
Praktický výběr porovnává výkonnost, latenci v ocase, kalibraci, využití zdrojů a náklady na chyby. Někdy je výhodnější jeden dobře regularizovaný model než malý nárůst přesnosti z křehkého stacku.
Proč ansámbly fungují
Učení pomocí ansámblu kombinuje více modelů tak, aby se jejich chyby částečně rušily nebo aby jejich silné stránky pokrývaly různé oblasti. Bagging trénuje modely na resamplovaných datech a průměruje predikce, čímž snižuje rozptyl; náhodné lesy přidávají náhodný výběr příznaků k odkorrelaci stromů. Boosting trénuje učitele sekvenčně, aby se zaměřil na reziduální chyby, často snižuje bias, ale zvyšuje citlivost na šum a ladění. Stacking trénuje meta‑model na predikcích základních modelů. Rozmanitost musí být užitečná: průměrování identických modelů přináší náklady bez výrazného snížení chyb.
Korelace mezi chybami určuje přínos. Rozmanitost může pocházet ze vzorků dat, příznaků, algoritmů, hyperparametrů, náhodné inicializace nebo časových oken. Tvrdo‑hlasování (hard voting) zruší důvěru; měkké hlasování (soft voting) průměruje pravděpodobnosti, ale vyžaduje kompatibilní kalibraci. Regrese může průměrovat nebo použít robustní agregaci. Ve stacking je nezbytné mít out‑of‑fold predikce – trénování meta‑modelu na predikcích základních modelů ze stejných natrénovaných dat vede k úniku informací. Uchovávejte jednoduchý průměrný základ, než přejdete na složitější kombinátor.
Vyhodnocení, kalibrace a nejistota
Porovnejte každého člena a ansámbl na odložené sadě se stejným předzpracováním. Uveďte metriky úlohy, kalibraci, chyby podskupin, rozptyl napříč skládky nebo semeny a náklady na zdroje. Ansámbl může zlepšit průměrnou kvalitu, zatímco zakrývá společný slepý bod způsobený společnými daty nebo štítky. Prozkoumejte nesoulad: může odhalit nejistotu, ale korelované modely, které jsou sebejistě špatné, mohou souhlasit. Kalibrujte finální ansámbl, ne jen členy, a ověřte prahy abstinence vůči kapacitě revize a důsledkům.
Odhady out‑of‑bag jsou užitečné pro bagged modely, ale nenahrazují finální test reprezentativní pro nasazení. U časových dat se vyhněte resamplování, které narušuje pořadí. Pro bezpečnostně citlivé použití testujte selhání členů, zastaralé modely a adversariální vstupy. Vážené ansámbly mohou přeučit validační data, pokud je zkoušeno mnoho kandidátů. Zaznamenejte výběr kandidátů a použijte vnořenou validaci, pokud je ladění rozsáhlé.
Nasazení a údržba
Ansámbly násobí paměť, latenci, spotřebu energie a provozní závislosti. Distilace může sloučit chování do jednoho modelu, s novým požadavkem na validaci. Verzionujte členy, předzpracování, váhy a směrování jako jeden artefakt; definujte chování, když člen vyprší čas nebo poskytne neplatný výsledek. Sledujte predikce členů a nesoulad, aby byl tichý selhání viditelné. Vyřaďte redundantní členy a záměrně je přetrénujte. Ansámbly zlepšují predikci, když je rozmanitost chyb skutečná, ale nepromění zaujatá tréninková data nebo neplatný cíl na spolehlivý důkaz.
Praktický příklad: ansámbl pro výstrahy před extrémním počasím
Predikční tým kombinuje sadu fyzikálních modelových příznaků, gradientně boostovaný strom, neurální sekvenční model a kalibrovanou statistickou základnu. Out‑of‑fold predikce trénují jednoduchý meta‑model a hodnocení používá budoucí bouře zcela vyloučené ze tréninku členů. Metriky zahrnují záchyt událostí, falešné poplachy, předstih, kalibraci, geografický výkon a spolehlivost během vzácných extrémních podmínek. Korelace chyb členů se zkoumá, protože sdílená vstupní data mohou vytvořit společné slepé body.
Nasazení uchovává každou predikci i kombinovaný výsledek. Pokud je některý člen nedostupný, systém použije předvalidovanou degradovanou konfiguraci místo tichého přenormování. Nesoulad vyvolá další revizi, ale ne vždy se považuje za nejistotu. Monitorování sleduje drift členů, latenci a výsledky bouří, přičemž váhy jsou aktualizovány jen řízenou validací. Veřejná varování zůstávají pod oprávněnými meteorologickými rozhodovacími procesy; ansámbl zlepšuje důkazy, ale ne redefinuje politiku výstrah autonomně.
Důkazy o implementaci a operační připravenost
Rozhodnutí o nasazení vyžaduje víc než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Stanovte reprodukovatelný výchozí stav a verzovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislosti, nesprávné použití a skupiny nebo prostředí, která jsou pravděpodobně nedostatečně obsloužena. Měřte kvalitu úlohy spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoc pro vydání, výjimky, změny, rollback a vyřazení. Použijte postupné nasazení, zachovejte bezpečnou záložní možnost a ověřte monitorování s úmyslně vloženými selháními. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky, aniž by shromažďovala zbytečná citlivá data. Definujte prahy výstrah a odpovědného za reakci, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte, kdykoli se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také potřebuje zdokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Je náhodný les ansámbl?
Ano. Kombinuje mnoho náhodně vytvořených rozhodovacích stromů, obvykle hlasováním nebo průměrováním.
Mohou identické modely vytvořit užitečný ansámbl?
Mohou, pokud tréninková data, inicializace nebo vzorkování vytvoří dostatečně odlišné chyby, ale pouhá duplikace nepřináší žádný přínos.
Primární reference












