
Základy AI
Co jsou podpůrné vektorové stroje?

 Přidejte Unite.AI mezi své preferované zdroje na Google
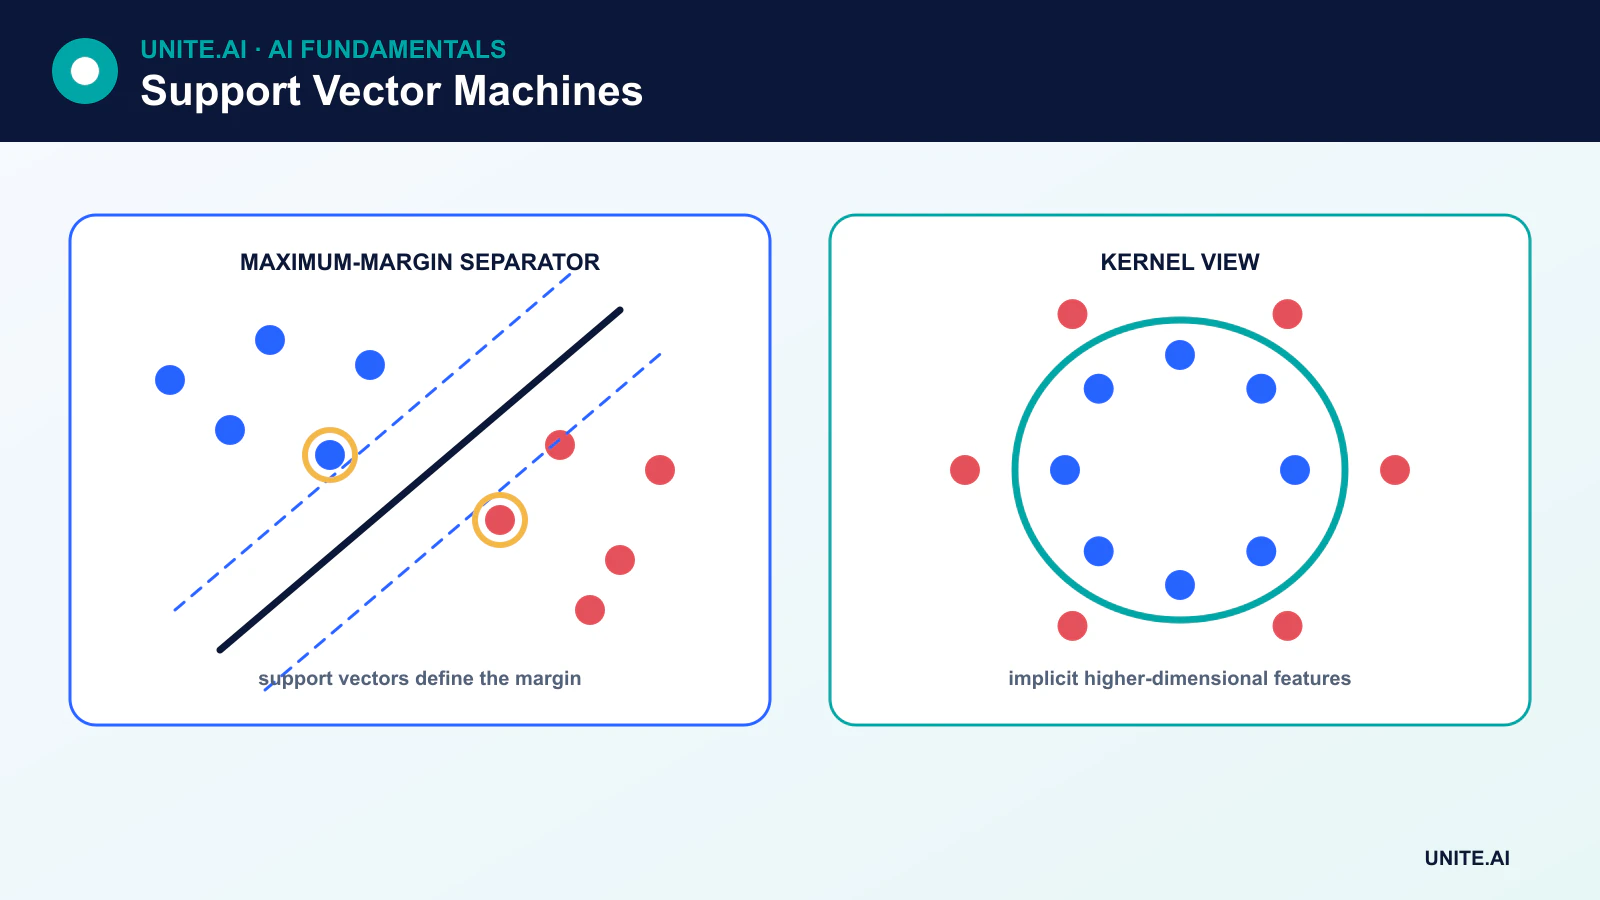
A podpůrný vektorový stroj (SVM) je metoda učení s učitelem, která nachází rozhodovací hranici s co nejširším možným okrajem mezi třídami. Tréninkové příklady, které tuto hranici určují, jsou podpůrné vektory.
SVM mohou provádět lineární nebo nelineární klasifikaci, regresi a detekci novinek. Jsou zvláště užitečné pro malé až středně velké datové sady s informativními rysy, včetně vysoce dimenzionálních řídkých dat, ale jejich náklady na trénink mohou být nepraktické u velmi velkých datových sad.
Klíčové body
- SVM maximalizuje minimální okraj mezi hranicí a nejbližšími tréninkovými body.
- Podpůrné vektory jsou datové body, nikoli další hyperroviny.
- Parametr C vyvažuje šířku okraje proti penalizacím za porušení.
- Jádra (kernely) počítají podobnost v implicitním prostoru rysů, aniž by explicitně materializovala každý transformovaný rys.
Myšlenka maximálního okraje
Pro lineární binární klasifikátor je rozhodovací hranice hyperrovina:
w · x + b = 0
Vektor w určuje orientaci a b posunutí. Mnoho hyperrovin může oddělovat tréninkové třídy. SVM vybírá tu, která maximalizuje vzdálenost k nejbližším příkladům na obou stranách. Tyto nejbližší příklady jsou podpůrné vektory a mají největší vliv na nastavenou hranici.
Cílem není maximalizovat vzdálenost hranice od každého bodu samostatně. Maximuje minimální okraj při splnění nebo penalizaci omezení tříd.
Pevné a měkké okraje
SVM s pevnými okraji vyžaduje dokonalé lineární oddělení a je citlivý na odlehlé body. Reálné datové sady obvykle potřebují měkký okraj, který zavádí volné proměnné pro pozorování uvnitř okraje nebo na špatné straně hranice.
Hyperparametr C řídí penalizaci těchto porušení:
- Větší hodnota C penalizuje porušení silněji a často vede k užšímu okraji, který přesněji sleduje tréninkové příklady.
- Menší hodnota C umožňuje více porušení výměnou za širší, více regularizovaný okraj.
Počet podpůrných vektorů je výsledkem dat a řešení; zvýšení C nezaručuje konkrétní počet podpůrných vektorů.
Trik s jádrem
Některé třídy nelze oddělit přímou hyperrovinou v původním prostoru rysů. Jádro (kernel) vyhodnocuje vnitřní součin odpovídající jinému prostoru rysů. To umožňuje SVM vytvořit nelineární hranici, aniž by explicitně počítalo každou transformovanou souřadnici.
Mezi běžná jádra patří:
- Lineární: efektivní pro vysoce dimenzionální řídké rysy, jako je text.
- Polynomické: modeluje interakce až do zvolené stupně.
- Radiální základní funkce (RBF): vytváří flexibilní lokální hranice založené na vzdálenosti.
- Sigmoidní: připomíná neuronovou aktivaci, ale méně často je výchozí volbou.
Pro RBF SVM parametr gamma řídí, jak lokálně každý tréninkový příklad ovlivňuje hranici. Velké gamma může vytvořit vysoce detailní oblasti a přeučit; malé gamma produkuje hladší vliv.
Více-třídová klasifikace
Klasický cíl SVM je binární. Knihovny jej rozšiřují pomocí strategií, jako je one-vs-rest (jeden proti všem), která trénuje jeden klasifikátor pro každou třídu, nebo one-vs-one (jeden proti jednomu), která trénuje klasifikátory pro dvojice tříd a kombinuje jejich rozhodnutí. Více-třídové SVM nevyužívají jen o jednu čáru méně než počet tříd.
Regrese podpůrného vektorového stroje a SVM jedné třídy
Regrese podpůrného vektorového stroje (SVR) přizpůsobuje funkci a ignoruje chyby uvnitř epsilon-široké trubice a penalizuje větší odchylky. SVM jedné třídy odhaduje hranici kolem typických dat a může podporovat detekci novinek. Neobvyklý bod není automaticky podvod nebo selhání; je neobvyklý vzhledem k naučenému reprezentaci.
Praktické požadavky
SVM jsou závislé na vzdálenostech a vnitřních součinech, takže číselné rysy je obecně nutné škálovat. C, jádro, gamma a váhy tříd by měly být vybírány pomocí validace. Odhady pravděpodobnosti nejsou součástí okraje a často vyžadují kalibraci, což zvyšuje náklady a mělo by být hodnoceno samostatně.
Trénink kernelových SVM může škálovat od kvadratické po kubickou časovou složitost vzhledem k počtu vzorků, v závislosti na datech a implementaci. Varianty lineárních SVM nebo stochastické lineární modely jsou vhodnější pro velmi velké datové sady. Pro surové obrázky, audio nebo jazyk mohou být naučené reprezentace z hlubokého učení účinnější, zatímco SVM může stále klasifikovat pevně dané vložení.
Silné stránky a omezení SVM
SVM mohou dobře fungovat s mnoha rysy, nabízejí jasný regularizovaný cíl a při predikci se primárně opírají o podpůrné vektory. Omezení zahrnují citlivost na škálování a hyperparametry, potenciálně nákladný trénink, sníženou interpretovatelnost u nelineárních jader a požadavky na kalibraci pravděpodobnosti.
Okraje, jádra a optimalizační cíl
Podpůrný vektorový stroj hledá oddělující hyperrovinu s velkým okrajem mezi třídami. Pouze podpůrné vektory na okraji nebo uvnitř okraje určují hranici. SVM s měkkým okrajem zavádějí volnost pro překrytí a chybně označené body; parametr C vyměňuje širší okraj za porušení během tréninku. Vstupy by měly být obvykle škálovány, protože vzdálenost a skalární součiny řídí řešení. Váhy tříd nebo pře‑vzorkování pomáhají, když jsou náklady na chyby a prevalence nerovné, ale prahy a pravděpodobnosti stále vyžadují nezávislou validaci.
Trik s jádrem vyhodnocuje podobnost, jako by byly vstupy mapovány do vyššího dimenzionálního prostoru rysů. Lineární, polynomické, radiální základní a specializovaná jádra zakódují různé předpoklady. Pro RBF jádro gamma řídí, jak lokálně každý bod ovlivňuje hranici: vysoké gamma může vytvořit složité oblasti a přeučit model, zatímco nízké gamma může podfitovat. Matice jader rostou kvadraticky s počtem vzorků, což činí nelineární SVM nákladnými na velkých datových sadách. Lineární řešiče nebo aproximativní mapy rysů jsou často výhodnější při velkém měřítku.
Více-třídové použití, kalibrace a provozní limity
Binární SVM se rozšiřují na více tříd pomocí one-vs-rest, one-vs-one nebo strukturovaných formulací. Hyperparametry musí být laděny v rámci křížové validace, s použitím seskupených nebo časových rozdělení, kde je to potřeba. Hodnoťte přesnost a odvolání specifické pro třídu, distribuce okrajů, kalibraci a výkon při posunu. Surové rozhodovací skóre nejsou pravděpodobnosti; Plattova škálování nebo izotonická kalibrace používají oddělená data a mohou se zhoršit, pokud se prevalence změní. Porovnávejte s logistickou regresí, stromy a moderními metodami založenými na reprezentacích při srovnatelném předzpracování a úsilí o ladění.
Nasazení vyžaduje přesný škálovač, pořadí rysů, parametry jádra, podpůrné vektory a mapování tříd. Náklady na predikci pro kernelové SVM rostou s počtem podpůrných vektorů, takže je třeba měřit latenci a paměť na realistických dávkách. Vstupy vzdálené od tréninkových podpůrných mohou stále získat jisté štítky; přidejte kontroly mimo rozdělení nebo politiku abstinence, kde je to vhodné. Prohlédněte chyby kvůli citlivým proxy a artefaktům datových sad. SVM zůstávají silné pro středně velké, vysoce dimenzionální problémy, ale maximální geometrický okraj není důkazem kauzální struktury ani bezpečnosti.
Praktický příklad: SVM pro směrování vzácných dokumentů
Právní tým klasifikuje krátké podání do kategorií směrování pomocí rysů TF–IDF a lineárního SVM. Rozděluje podle záležitosti a času, aby se zabránilo úniku šablon, škáluje váhy tříd na základě nákladů na chyby po revizi a ladí C vnořenou validací. Lineární model je porovnáván s logistickou regresí a transformátorem. Přesnost, odvolání, kalibrace a zátěž recenzentů pro každou třídu jsou důležitější než celková přesnost.
Rozhodovací skóre jsou kalibrována na oddělených datech a dokumenty s nízkým okrajem nebo nepodporovaným jazykem jsou směrovány do manuálního zpracování. Nasazovací artefakt zahrnuje tokenizér, slovník, vážení, model, kalibraci a mapu štítků. Monitoring sleduje nové termíny, prevalenci kategorií, okraje a opravené trasy. Dokumenty a podpůrné vektory jsou chráněny, protože textové rysy mohou odhalit důvěrné informace. Nelineární jádro je odmítnuto, když jeho malý přírůstek kvality neospravedlňuje latenci, paměť a náklady na interpretovatelnost.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Stanovte reprodukovatelný výchozí stav a verzovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislostí, zneužití a skupiny nebo prostředí, která jsou pravděpodobně nedostatečně obsloužena. Měřte kvalitu úkolu spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoc pro vydání, výjimky, změny, návrat a ukončení. Použijte postupné nasazení, zachovejte bezpečnou záložní možnost a ověřte monitoring pomocí úmyslně vložených selhání. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky, aniž by sbírala zbytečná citlivá data. Definujte prahové hodnoty výstrah a odpovědného za reakci, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte vždy, když se změní zdroje dat, uživatelé, modely, dodavatelé, zásady, hardware nebo cíle. Udržovaný systém také potřebuje zdokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Provádějí SVM pouze klasifikaci?
Ne. Regrese podpůrného vektorového stroje předpovídá spojité cíle, zatímco SVM jedné třídy může odhadnout hranici novinek. Každá varianta má jiný cíl a sadu hyperparametrů.
Kdy je lineární SVM silnou volbou?
Lineární SVM jsou často účinné pro vysoce dimenzionální řídké rysy, včetně tradičních textových reprezentací, kde by flexibilní jádro přidalo náklady bez zřejmých výhod.
Primární reference












