Základy AI
Učení pod dohledem vs učení bez dozoru

 Přidejte Unite.AI mezi své preferované zdroje na Google
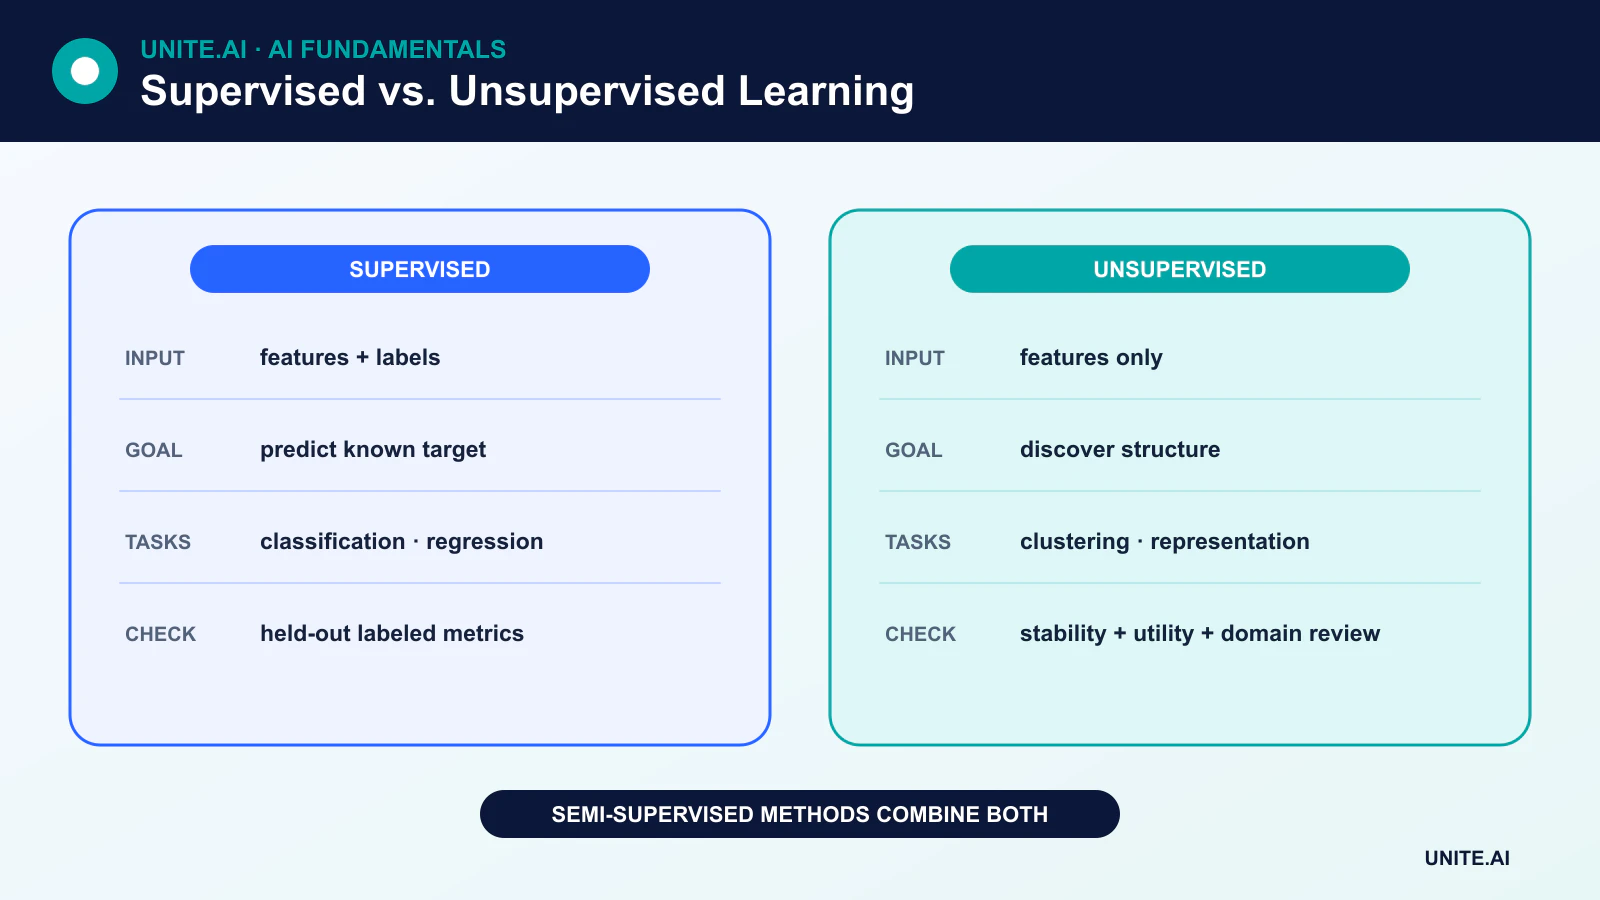
Učení pod dohledem se učí z příkladů spárovaných s cílovými odpověďmi. Učení bez dozoru hledá strukturu v datech bez cílových štítků. Rozdíl není v tom, který přístup je inteligentnější nebo přesnější; jde o typ dostupného učícího signálu a otázku, na kterou má systém odpovědět.
Jedná se o dva hlavní paradigmata v strojovém učení, ale moderní systémy také využívají semi‑supervised, self‑supervised a reinforcement learning.
Klíčové poznatky
- Učení pod dohledem předpovídá známý cíl; učení bez dozoru objevuje vzory nebo reprezentace.
- Klasifikace a regrese jsou úkoly pod dohledem; clustering, odhad hustoty a mnoho metod redukce dimenzí jsou bez dozoru.
- Výstupy bez dozoru nejsou automaticky reálné třídy a mohou být obtížnější k vyhodnocení.
- Výpočetní náročnost a přesnost závisí na algoritmu, datech, úkolu a hodnocení – nejen na paradigmatu.
Jak funguje učení pod dohledem
Dataset pod dohledem obsahuje rysy X a cíl y. Trénink upravuje model tak, aby jeho předpovědi co nejvíce odpovídaly cílům. Hodnocení používá odložené označené příklady k odhadu, jak dobře model generalizuje.
Klasifikace
Klasifikace předpovídá kategorii: spam nebo ne‑spam, jedno téma dokumentu z několika možností nebo jeden či více objektů na obrázku. Relevantní metriky zahrnují přesnost, recall, F1, kalibraci a nákladově‑citlivá měření. Přesnost může být zavádějící, pokud je jedna třída vzácná; matice záměn odhalí, které třídy jsou zaměňovány.
Regrese
Regrese předpovídá spojitou hodnotu, například poptávku, dobu trvání nebo teplotu. Lineární regrese může využívat jeden či mnoho rysů; není omezena jen na vztah mezi dvěma proměnnými. Regresní metriky zahrnují průměrnou absolutní chybu, odmocninu průměrné čtvercové chyby a úkolově specifické náklady.
Obvyklé algoritmy pod dohledem
Mezi metody pod dohledem patří lineární a logistické modely, rozhodovací stromy, náhodné lesy, gradient boosting, support vector machines, K‑nejbližší sousedé a neuronové sítě.
Logistická regrese poskytuje skóre nebo pravděpodobnost, kterou lze převést na třídu pomocí zvoleného prahu. List rozhodovacího stromu obsahuje předpověď založenou na regionu prostoru rysů, ne nutně na jedné trénovací pozorování. KNN předpovídá na základě blízkých označených trénovacích příkladů a stále vyžaduje dobře navržený train/validation/test proces.
Jak funguje učení bez dozoru
Učení bez dozoru přijímá rysy bez cílového sloupce. Jeho cíl je definován nepřímo – například minimalizovat vzdálenost uvnitř clusterů, rekonstruovat vstup, odhadnout hustotu dat nebo zachovat co nejvíce variance v menším počtu dimenzí.
Clustering
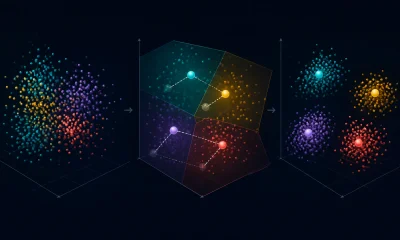
K‑means přiřazuje body k předem zvolenému počtu clusterů a aktualizuje středy clusterů tak, aby se snížila čtvercová vzdálenost uvnitř clusteru. Algoritmus objevuje geometrické seskupení podle konkrétní metriky vzdálenosti a reprezentace rysů. Tyto skupiny automaticky neodpovídají smysluplným typům zákazníků, diagnózám či jiným doménovým štítkům.
Redukce dimenzí
Redukce dimenzí představuje data pomocí menšího počtu proměnných. Analýza hlavních komponent (PCA) nachází ortogonální směry, které zachovávají co nejvíce variance při lineární projekci. Ostatní metody uchovávají odlišné představy o struktuře a mohou vést k velmi odlišným vizualizacím.
Detekce anomálií a odhad hustoty
Metody bez dozoru mohou odhadnout, kde jsou data hustá, a označit neobvyklé pozorování. Skóre anomálie neprokazuje podvod, selhání ani škodlivé chování; jen identifikuje odchylku v rámci zvolené reprezentace a modelu.
Jak se hodnotí učení bez dozoru
Neexistuje univerzální pojem „přesnost“ pro bez‑dozorové učení. Praktik může použít interní metriky jako silhouette score, porovnat stabilitu napříč vzorky, testovat užitečnost v následném úkolu nebo se zeptat odborníků, zda je objevená struktura smysluplná. Pokud jsou k hodnocení k dispozici pravdivé štítky, lze použít externí metriky clusteringu, aniž by se tréninkový proces proměnil v učení pod dohledem.
Za hranicemi dvou‑cestného srovnání
Semi‑supervised learning
Semi‑supervised learning kombinuje menší označenou sadu s větší neoznačenou sadou. Příklady jsou pseudo‑labelování, regularizace konzistence a metody založené na grafech. Neoznačená data musí stále dostatečně připomínat cílovou distribuci, aby byla užitečná.
Self‑supervised learning
Self‑supervised learning odvozuje cíle přímo ze vstupu, například předpovídáním maskovaných tokenů nebo porovnáváním transformovaných pohledů. Je to základ moderních jazykových, vizuálních a multimodálních modelů, včetně transformerů.
Reinforcement learning
Reinforcement learning optimalizuje rozhodnutí pomocí odměn generovaných interakcí. Liší se od obou – označené predikce i statického objevování vzorů.
Výběr správného přístupu
Začněte s rozhodnutím nebo poznatkem, který má systém dodat. Pokud existují spolehlivé cíle a cílem je predikce, je přirozené použít učení pod dohledem. Pokud je cílem průzkum, reprezentace nebo seskupení, může být vhodná metoda bez dozoru. Když jsou štítky vzácné, může být efektivnější předtrénování self‑supervised nebo semi‑supervised a následné hodnocení pod dohledem.
V každém případě mohou úniky dat, zaujatý výběr, slabé proxy a posun distribuce převážit volbu algoritmu. Technicky správný model trénovaný na špatný cíl může i tak selhat.
Učební signály, cíle a reprezentativní metody
Učení pod dohledem používá příklady spárované s cílovými štítky nebo hodnotami a optimalizuje predikční chybu. Klasifikace, regrese, ranking a strukturovaná predikce se liší výstupem a ztrátovou funkcí. Učení bez dozoru hledá strukturu bez cílových štítků pomocí clusteringu, odhadu hustoty, redukce dimenzí, učení reprezentací nebo generativního modelování. Self‑supervised learning vytváří predikční cíle z dat samotných, zatímco semi‑supervised learning kombinuje malou označenou sadu s větší neoznačenou. Tyto kategorie popisují učící signál; stejná neuronová architektura může být trénována pod několika paradigmami.
Štítky činí cíl explicitním, ale zavádějí náklady na anotaci, šum, předpoklady politiky a časové zpoždění. Neoznačená data se snadněji sbírají, ale neříkají algoritmu, která objevená struktura je užitečná. Cluster může odrážet osvětlení, délku dokumentu nebo zdroj akvizice místo smysluplné kategorie. Definujte hodnocení nezávisle: modely pod dohledem používají odložené označené výstupy, zatímco modely bez dozoru potřebují stabilitu, rekonstrukci, pravděpodobnost, vyhledávání, užitečnost v následných úlohách nebo validaci odborníky. Pouhá vizuální separace není důkazem platné struktury.
Volba paradigmatu a prevence častých chyb
Používejte učení pod dohledem, když existuje stabilní cíl a reprezentativní štítky. Používejte bez‑dozorový průzkum k sumarizaci, detekci novinek, kompresi nebo generování hypotéz, ale výstupy považujte za provizorní. Self‑supervised předtrénování je cenné, když je surových dat hodně a následné úkoly sdílejí reprezentace. Semi‑supervised metody pomáhají jen tehdy, když platí předpoklady o neoznačených datech a struktuře tříd. Porovnávejte s jednoduchými baseline a zohledněte celkové náklady na sběr, anotaci, revizi, výpočet a chyby, místo aby se předpokládalo, že neoznačená data jsou automaticky levná.
Prevence úniku dat spočívá v oddělení souvisejících entit před odvozením štítků, augmentací či pseudo‑štítků. Sledujte rovnováhu tříd, shodu anotací, stabilitu clusterů, kolaps a drift. Pseudo‑štítky mohou posilovat rané chyby; clustering může zakódovat citlivé atributy; předtrénovaná reprezentace může přenášet zdrojové zaujetí. Lidská revize by se měla soustředit na hraniční případy a jejich důsledky. V produkci dokumentujte, jak byl učící signál vytvořen a kdy se stane zastaralým. Paradigma určuje, kde do systému vstupuje supervision, ne to, zda jsou v něm přítomny lidské volby a hodnoty.
Praktický příklad: objevování a označování témat podpory
Společnost nejprve použije neoznačené embeddingy a clustering k prozkoumání témat v de‑identifikovaných podporných zprávách. Analytici zkoumají reprezentativní i hraniční příklady a zjistí, že některé clustery odrážejí délku zprávy a kanál místo skutečných problémů. Vyvinou označenou taxonomii s neznámou třídou, pokyny pro anotaci a měřenou shodu. Klasifikátor je pak vyhodnocen na pozdějších časových obdobích, jazycích a produktech proti klíčovým slovům a baseline K‑nearest neighbor.
Nové neoznačené zprávy podporují detekci driftu, ale automaticky netrénují klasifikátor. Recenzenti označují vybrané nejisté a vznikající případy pomocí aktivního učení, s kontrolou kvality a uzavřenou evaluační sadou. Monitoring sleduje prevalenci témat, jistotu, neshodu a výsledky směrování. Když se uvede nový produkt, aktualizuje se taxonomie a kapacita downstream týmů. Pracovní tok používá metody bez dozoru k tvorbě hypotéz a podklady pod dohledem pro operativní směrování.
Důkazy o implementaci a operační připravenost
Rozhodnutí v produkci vyžaduje víc než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého kritického selhání. Zaveďte reprodukovatelný baseline a verzovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadky závislostí, zneužití a skupiny či prostředí, která jsou nejčastěji nedostatečně obsloužena. Měřte kvalitu úkolu spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a oddělit důkazy od atraktivního prototypu.
Před nasazením přiřaďte odpovědnost za vydání, výjimky, změny, rollback a ukončení. Použijte stupňované nasazení, zachovejte bezpečný fallback a ověřte monitoring pomocí záměrně injektovaných selhání. Operační telemetrie by měla odhalovat kvalitu vstupu, chování výstupu, verzi modelu nebo pravidla, zdraví závislostí, lidské zásahy a potvrzené výsledky, aniž by sbírala zbytečná citlivá data. Definujte prahové hodnoty alarmů a vlastníka reakce, poté po nasazení revidujte reálná data místo předpokladu, že offline výkon přetrvá. Přehodnoťte vždy, když se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také potřebuje zdokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy by měl být deaktivován nebo nahrazen.
Primární reference