
Základy AI
Co je shlukování K-means?

 Přidejte Unite.AI mezi své preferované zdroje na Google
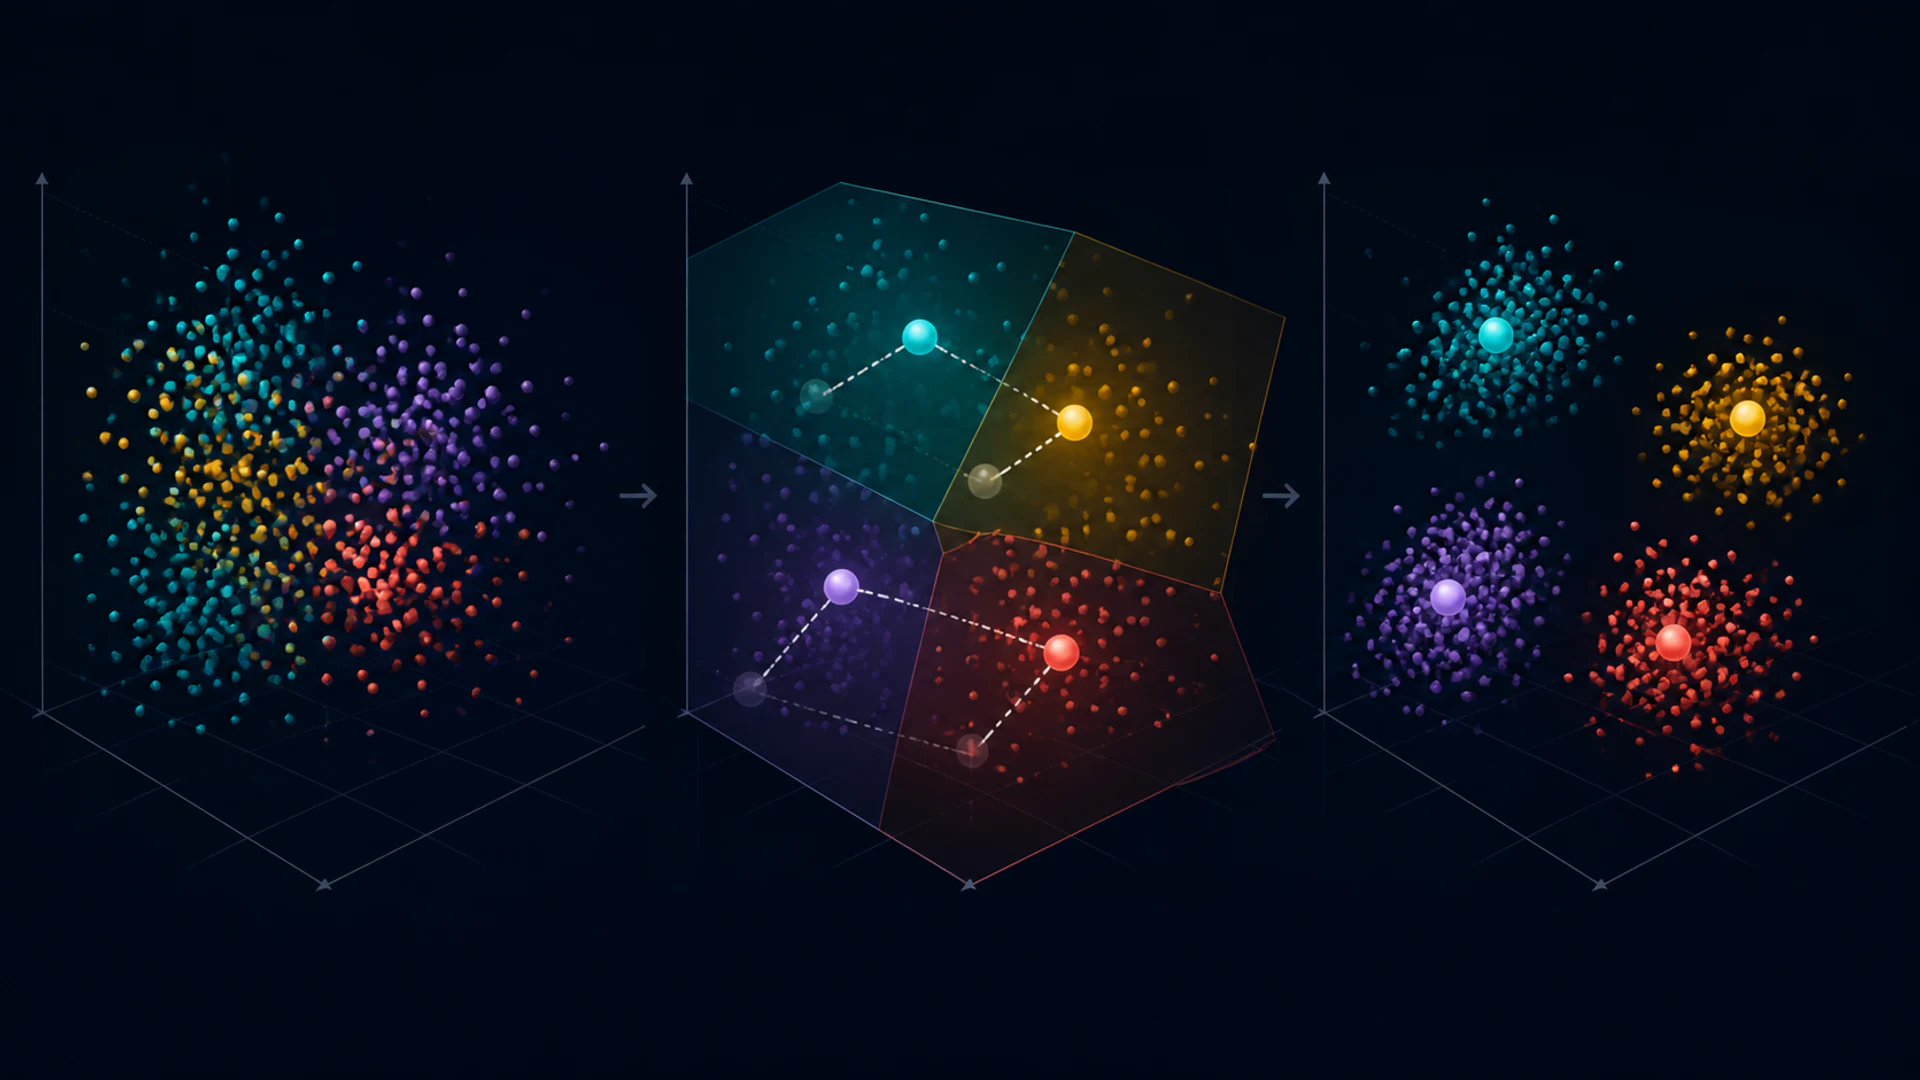
K-means je nesupervizovaný algoritmus, který rozděluje číselná pozorování do k shluků. Střídavě přiřazuje každý bod k nejbližšímu centroidu a přepočítává každý centroid jako průměr přiřazených bodů.
Algoritmus je rychlý a užitečný, ale jeho výsledek je ovlivněn škálováním, vzdáleností, inicializací a zvoleným k. Shluk je matematické rozdělení, ne nutně reálná kategorie.
Klíčové poznatky
- K-means minimalizuje čtvercovou eukleidovskou vzdálenost uvnitř shluku k centroidům.
- Inicializace má význam; k-means++ rozprostírá počáteční centroidy a obvykle zlepšuje výsledky.
- Standardizujte rysy, pokud jejich jednotky nebo měřítka mají přispívat srovnatelně.
- K-means má potíže s odlehlými hodnotami, nesférickými shluky, nerovnoměrnou hustotou a kategorickými daty.
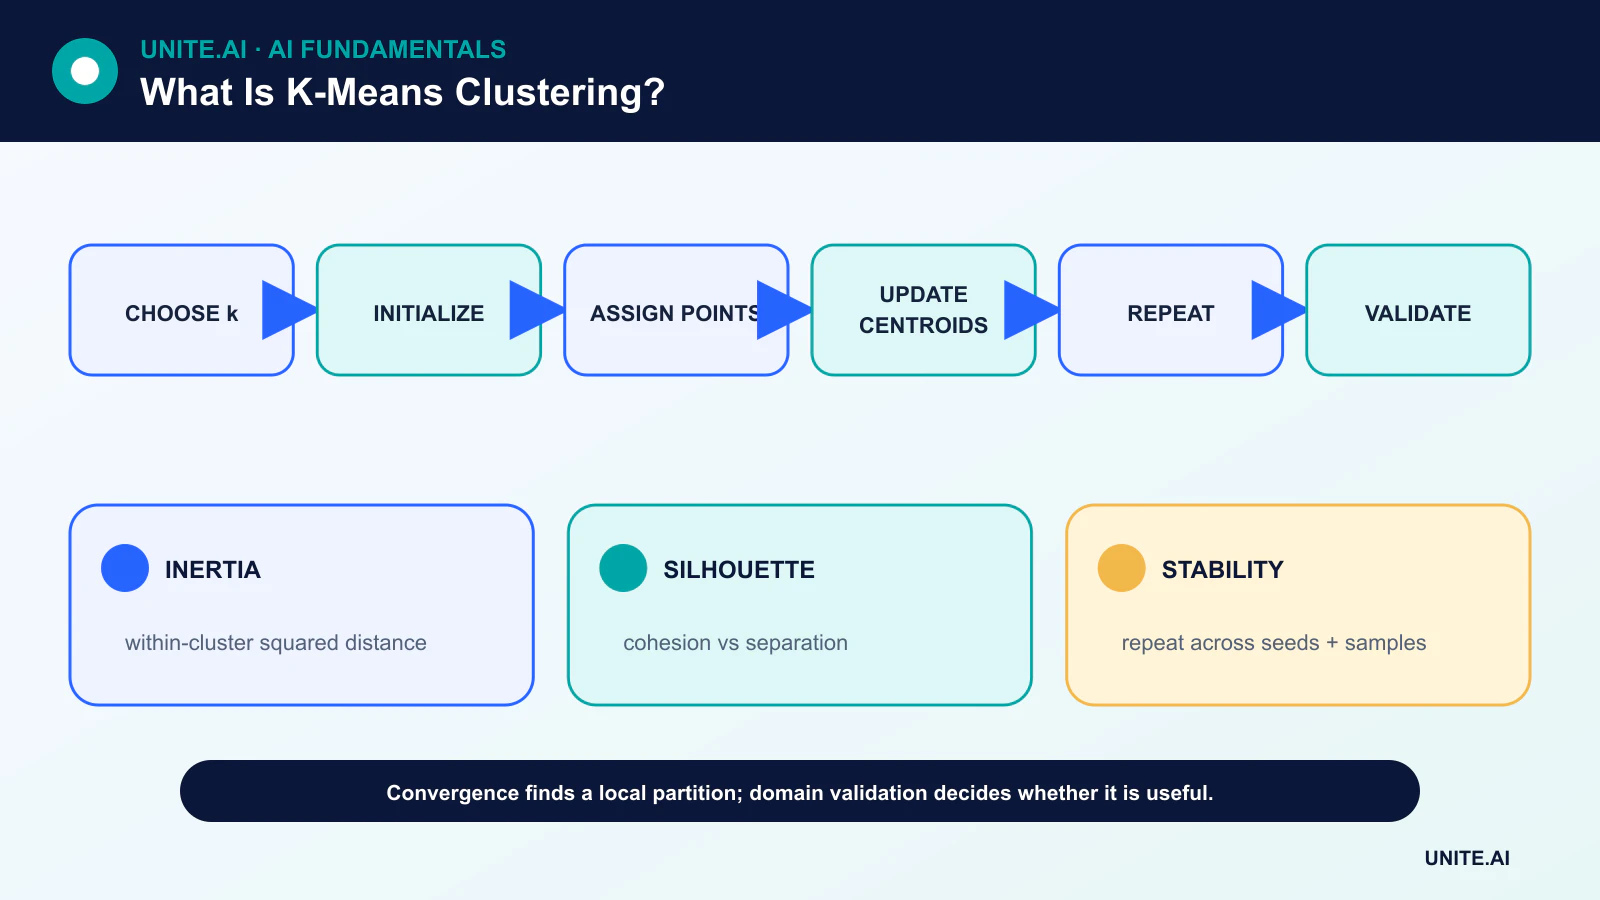
Cíl a smyčka aktualizace
Při daných k centroidách přiřazuje krok přiřazení každé pozorování k nejbližšímu. Krok aktualizace nahradí každý centroid průměrem jeho přiřazených pozorování. Součet čtverců uvnitř shluku nemůže těmito kroky růst, takže proces konverguje k lokálnímu optimu.
Konvergence nezaručuje globální optimum. Různé počáteční centroidy mohou vést k odlišným rozdělením, proto implementace provádějí několik inicializací a zachovávají řešení s nejnižší inercí.
Inicializace a k-means++
Náhodný výběr všech počátečních centroidů z jedné husté oblasti může vést k špatnému řešení nebo pomalé konvergenci. K-means++ vybírá semena s pravděpodobností související se vzdáleností od již existujících semen, čímž podporuje pokrytí celého datového souboru.
Více běhů zůstává užitečných. Zaznamenejte náhodné semeno a počet inicializací, aby bylo možné výsledky reprodukovat.
Škálování a vzdálenost
Čtvercová eukleidovská vzdálenost činí K-means citlivým na jednotky. Vlastnost měřená v tisících může převažovat nad jinou měřenou mezi nulou a jednou. Standardizace je běžná, ale doménové znalosti by měly rozhodnout, zda stejná standardizovaná variance odráží stejnou důležitost.
Odlehlé hodnoty mohou táhnout průměr daleko od typických bodů. Robustní škálování, ořezávání nebo metody založené na medoidách mohou být lepší. One-hot kategorie vytvářejí geometrii vzdáleností, která nemusí odpovídat podobnosti kategorií.
Volba k a validace shluků
Inerce klesá s každým zvýšením k, takže sama o sobě nemůže vybrat k. Heuristika loket hledá klesající zlepšení. Analýza siluety porovnává soudržnost a oddělení. Stabilita napříč vzorky a semeny přidává další kontrolu.
Nejsilnější validací je užitečnost pro zamýšlenou doménu. Porovnejte shluky se známými výsledky, expertním hodnocením nebo následnou úlohou, aniž byste předstírali, že popozdější štítky byly objeveny objektivně.
Omezení a alternativy
K-means upřednostňuje kompaktní, přibližně sférické skupiny podobného měřítka. Modely směsů Gaussiánů představují pravděpodobnostní elipsoidální komponenty; metody typu DBSCAN identifikují husté oblasti a šum; hierarchické shlukování vytváří strom sloučení.
Redukce dimenzionality může zlepšit rychlost nebo odšumět vstupy, ale její natrénování na celém datovém souboru může změnit otázku validace. Mini‑batch K-means snižuje výpočetní náročnost pro velké datové sady za cenu přibližné aktualizace.
Cíl, inicializace a konvergence
K-means rozděluje číselná pozorování do k shluků minimalizací čtvercové eukleidovské vzdálenosti uvnitř shluku k centroidům. Lloydův algoritmus střídavě přiřazuje každý bod k nejbližšímu centroidu a přepočítává centroidy, dokud se přiřazení nebo cíl nestabilizují. Konverguje k lokálnímu optimu, ne nutně k globálnímu nejlepšímu. Inicializace K-means++ rozprostírá počáteční středy a obvykle zlepšuje výsledky, ale více semen zůstává důležitých. Standardizujte rysy, pokud mají jednotky přispívat srovnatelně, protože čtvercová vzdálenost zesiluje proměnné s vysokým měřítkem a odlehlé hodnoty.
Metoda předpokládá přibližně kompaktní, sférické, podobně měřítkové shluky pod eukleidovskou geometrií. Má potíže s protáhlými manifoldy, nerovnoměrnou hustotou, kategorickými daty, silnými odlehlými hodnotami a vnořenou strukturou. Prázdné shluky a duplicitní body vyžadují definované zacházení. Mini‑batch k-means škáluje na velká data s kompromisem aproximace. Pro řídký text může kosinová orientovaná sférická k-means lépe odpovídat směru, zatímco směsi, hustotní metody, hierarchické shlukování nebo k‑medoidy zohledňují jiné předpoklady.
Volba k a validace významu
Křivky loketu, skóre siluety, informační kritéria v souvisejících modelech a stabilita mohou napomoci výběru k, ale žádná neodhalí jedinečně správné číslo. Obchodní užitečnost a doménová interpretace jsou důležité. Přetrénujte napříč vzorky a semeny, porovnejte pohyb centroidů a konzistenci přiřazení a validujte shluky na nezávislých výsledcích, které nebyly použity při jejich tvorbě. Dvourozměrná projekce může zkreslit oddělení, proto zkoumejte vzdálenosti a příklady v původním nebo validovaném reprezentativním prostoru.
Shluky jsou popisné skupiny vytvořené na základě vybraných rysů a metriky; nejsou to přirozené typy ani kauzální segmenty. Profily založené na stejných proměnných, které se používají pro shlukování, mohou být kruhové. Používejte vyhrazené atributy a kvalitativní revizi a zkoumejte, zda shluky především reprodukují geografii, zdroj dat nebo citlivé charakteristiky. Malé shluky mohou být anomálie nebo artefakty. Pojmenování shluku neznamená, že každý jeho člen odpovídá štítku.
Nasazení a údržba
Ukládejte škálování, pořadí rysů, centroidy, definici vzdálenosti a štítky shluků společně. Pro nové body sledujte vzdálenost k přiřazenému centroidu a podíl bodů daleko mimo tréninkovou podporu; nabídněte stav „neznámý“ místo nucení každého případu do shluku. Sledujte velikosti shluků, centroidy a relevanci výsledků v čase. Přetrénování mění identitu shluků, proto mapujte nebo verzujte následná pravidla místo tichého používání starých názvů. K-means je užitečná základna pro kompresi a segmentaci, pokud jeho geometrie odpovídá otázce, nikoli univerzální nástroj pro objevování.
Praktický příklad: segmentace zákazníků pomocí k-means
Předplatitelská společnost standardizuje využití funkcí během pevného časového okna, odstraňuje identifikátory účtů a testuje k napříč semeny. Hodnotí se stabilita, silueta a vyhrazené obchodní výsledky, ale produktové týmy také kontrolují reprezentativní a hraniční účty. Zjistí, že jeden shluk představuje jednoduše nové zákazníky s kratším pozorováním, takže délka trvání je řešena explicitně. K-means je srovnáván s hierarchickými a hustotními alternativami místo předpokladu vhodnosti. Cvičení je považováno za nesupervizované učení, nikoli objevování štítků.
Segmenty řídí výzkum a experimenty s komunikací, nikoli způsobilost nebo cenu. Nové účty daleko od všech centroidů získají přiřazení „neznámý“. Škálování, rysy, centroidy a názvy jsou verzovány a přetrénování mapuje nové shluky na staré pouze s důkazy. Monitoring sleduje velikost shluku, vzdálenost a relevanci výsledků. Citlivé atributy a proxy jsou auditovány a tým se vyhýbá popisu shluků jako přirozených typů osobnosti, když jsou to matematické rozdělení vybraného chování.
Důkazy o implementaci a operační připravenost
Rozhodnutí o nasazení vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Zaveďte reprodukovatelný základ a verzovanou evaluační sadu před laděním. Testujte běžné případy, okrajové podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislosti, zneužití a skupiny nebo prostředí, která jsou pravděpodobně nedostatečně obsloužena. Měřte kvalitu úlohy spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a rozlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoci pro vydání, výjimky, změny, návrat a ukončení. Použijte postupné nasazení, zachovejte bezpečnou záložní možnost a ověřte monitoring pomocí záměrně vložených selhání. Operační telemetrie by měla odhalit kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky bez sběru zbytečných citlivých dat. Definujte prahové hodnoty výstrah a odpovědného, poté přezkoumejte reálné důkazy po nasazení místo předpokladu, že offline výkon přetrvá. Přehodnoťte kdykoli se změní zdroje dat, uživatelé, modely, dodavatelé, zásady, hardware nebo cíle. Udržovaný systém také potřebuje zdokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Je K-means supervizovaný nebo nesupervizovaný?
Je to nesupervizovaný algoritmus, protože dostává rysy a zvolený počet shluků, nikoli cílové štítky.
Klasifikuje K-means nová data?
Po natrénování může být nový bod přiřazen k nejbližšímu centroidu. Jedná se o přiřazení ke shluku, nikoli nutně o supervizovanou predikci třídy.
Primární reference












