Základy AI
Co je autoenkodér?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Autoenkodér (autoencoder) je neuronová síť trénovaná k rekonstrukci svého vstupu. Enkodér mapuje vstup na latentní reprezentaci; dekodér mapuje tuto reprezentaci zpět na rekonstrukci. Trénink minimalizuje ztrátu rekonstrukce, někdy s dalšími omezeními.
Dokonalé kopírování vstupu není automaticky užitečné. Architektura nebo cíl musí vytvořit úzký průchod, přidat šum, vynutit řídkost nebo jinak zabránit triviálnímu identickému mapování, aby latentní kód zachytil užitečnou strukturu.
Klíčové body
- Enkodér komprimuje nebo transformuje vstup; dekodér jej rekonstruuje z latentního kódu.
- Podúplný úzký průchod, šum nebo regularizace povzbuzují model učit se strukturu místo pouhého kopírování.
- Chyba rekonstrukce může podpořit detekci anomálií, ale není zaručeno, že anomálie budou mít vysokou chybu.
- Variacionální autoenkodéry se učí pravděpodobnostní latentní model a liší se od deterministických autoenkodérů.
Enkodér, latentní prostor a dekodér
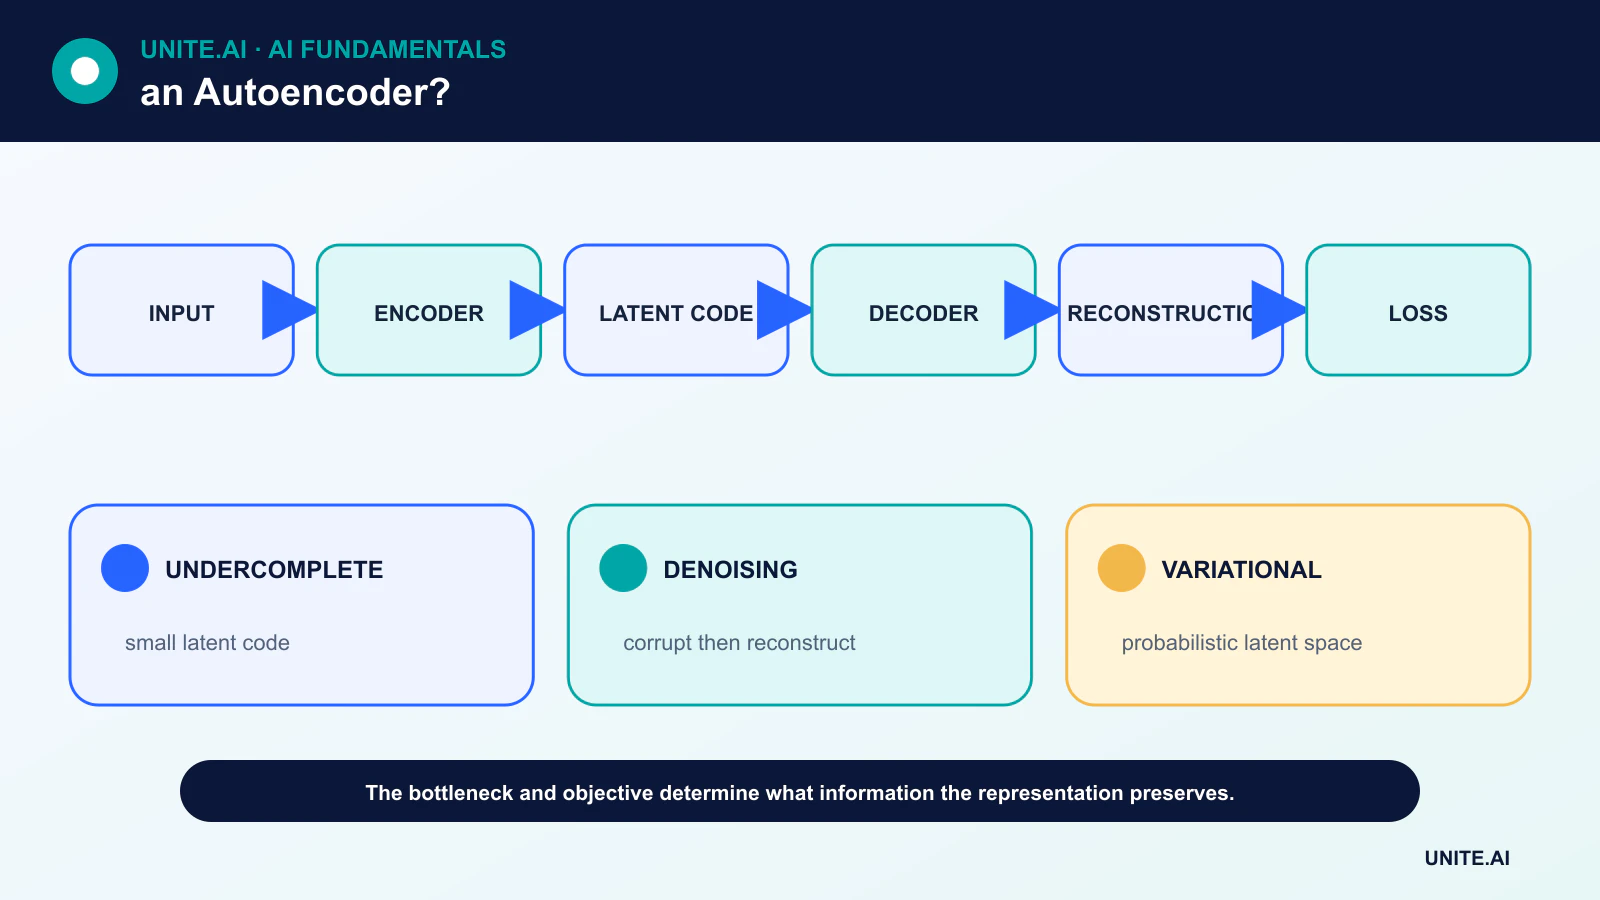
Pro vstup x enkodér vytváří latentní kód z = f(x) a dekodér vytváří rekonstrukci x̂ = g(z). Ztráta porovnává x a x̂, například pomocí střední kvadratické chyby pro spojité hodnoty nebo pravděpodobnosti vhodné pro data.
Latentní rozměr může být menší než vstup, čímž vzniká podúplný autoenkodér. Hluboká síť může také učit nelineární reprezentace, rozšiřující myšlenku za dimenzionálním snížením.
Běžné varianty autoenkodérů
Řídký autoenkodér penalizuje rozšířenou aktivaci. Denoising autoenkodér přijímá poškozený vstup a rekonstruuje čistou verzi. Kontraktivní autoenkodér penalizuje citlivost kódu na malé změny vstupu.
Variacionální autoenkodér (VAE) kóduje parametry pravděpodobnostního rozdělení, vzorkuje latentní hodnotu a vyvažuje rekonstrukci s regularizačním členem, který formuje latentní prostor. To podporuje vzorkování, ale mění cíl a interpretaci.
Trénink a vyhýbání se triviálním řešením
Autoenkodéry používají zpětnou propagaci jako jiné neuronové sítě. Síť s nadměrnou kapacitou může memorovat tréninkové příklady nebo se naučit téměř identickou funkci. Velikost úzkého průchodu, poškození, penalizace a validace na neviděných datech ji omezují.
Volba ztrátové funkce má význam. Pixelová ztráta může vést k rozmazaným rekonstrukcím obrazu, zatímco percepční ztráty přebírají předpoklady z jiné sítě. Nejlepší metrika rekonstrukce není nutně nejlepší měřítko sémantické podobnosti.
Použití a omezení
Autoenkodéry mohou učit rysy, odstraňovat šum ze signálů, komprimovat data, inicializovat modely a vytvářet latentní proměnné pro vizualizaci. Pro detekci anomálií může model trénovaný na normálních datech přiřadit vyšší chybu rekonstrukce neobvyklým vstupům.
Tento přístup může selhat, když autoenkodér také dobře rekonstruuje anomálie nebo když neškodná variace je obtížnější k rekonstrukci než cílová anomálie. Prahy vyžadují označená nebo pečlivě revidovaná validační data a chyba by měla být sledována podle podskupin a provozních podmínek.
Autoenkodéry vs. jiné generativní modely
Deterministický autoenkodér není automaticky pravděpodobnostní generativní model. VAE definují strukturované latentní rozdělení; GANy trénují generátor proti diskriminátoru; difúzní modely se učí denoising proces.
Volba závisí na tom, zda je cílem rekonstrukce, reprezentace, pravděpodobnost, věrnost vzorku, ovladatelnost nebo skórování anomálií. Menší úlohově specifický model je často praktičtější než velký generátor obrázků.
Cíle enkodér‑dekodér a latentní reprezentace
Autoenkodér se učí enkodér, který mapuje vstup x na latentní kód z, a dekodér, který z rekonstruuje x. Pokud je kapacita neomezená, může se naučit identické mapování s málo užitečnou strukturou. Úzké průchody, regularizace, poškození, řídkost nebo architektonická omezení vynutí reprezentaci, která zachovává vybrané informace. Ztráta rekonstrukce definuje, co se považuje za podobné: střední kvadratická chyba upřednostňuje průměrnou věrnost pixelů, zatímco percepční nebo modalitně specifické ztráty zdůrazňují různé rysy. Nízká ztráta nezaručuje sémantický význam.
Podúplné autoenkodéry omezují latentní rozměr. Denoising autoenkodéry rekonstruují čistá data z poškozeného vstupu. Řídké varianty penalizují aktivaci; kontraktivní varianty penalizují citlivost. Variacionální autoenkodéry se učí pravděpodobnostní latentní rozdělení kombinací rekonstrukce s divergencí, což umožňuje vzorkování, ale mění cíl. Konvoluční, sekvenční, grafové a transformerové autoenkodéry kódují strukturu modality. Zvolte velikost latentního prostoru a regularizaci prostřednictvím downstream validace, ne jen na základě atraktivních dvourozměrných grafů.
Detekce anomálií, komprese a hodnocení
Pro detekci anomálií trénujte na reprezentativních normálních datech a hodnotěte chybu rekonstrukce nebo pravděpodobnost latentního prostoru, ale anomálie se někdy mohou dobře rekonstruovat a vzácné normální případy špatně. Vyberte prahy na základě označených nebo revidovaných validačních případů, hlaste úroveň připomenutí událostí a falešná poplachy a testujte změny v provozním stavu. Porovnejte s jednoduchými statistickými a jednojádrovými baseline. Pro kompresi spočítejte kompletní kodek – včetně velikosti modelu, kvantizace, metadat a výpočetního výkonu dekodéru – a porovnejte kvalitu při odpovídajícím bitrate s etablovanými kodeky.
Kvalitu reprezentace lze hodnotit pomocí lineárních sond, stability shlukování, vyhledávání, rekonstrukce a downstream úkolů, z nichž každý odpovídá na jinou otázku. Vyhněte se úniku informací při učení enkodéru a výběru prahů. Prozkoumejte, které rysy ztráta ignoruje a zda citlivé atributy zůstávají zakódovány. Komprimovaný latent není automaticky anonymizován; inverze a inferování atributů mohou obnovit soukromé informace. Generované rekonstrukce mohou také vypadat věrohodně, zatímco mění kritické detaily.
Nasazení a monitorování
Verzujte enkodér a dekodér společně, validujte číselné změny po exportu a zachovejte škálování vstupu. Sledujte distribuci rekonstrukcí, drift latentního prostoru, prahová upozornění a potvrzené výsledky. V průmyslovém monitorování podmíněte model provozním režimem, aby normální přechody nebyly považovány za poruchy. Pro medicínskou nebo vědeckou rekonstrukci nikdy nepředkládejte generovaný detail jako měřený důkaz bez validace a provenance. Autoenkodéry jsou flexibilní učební reprezentace, ale omezení a ztráta – nikoli název architektury – určují, jaké informace jsou zachovány, zahazovány nebo vytvořeny.
Praktický příklad: autoenkodér pro anomálie čerpadel
Podúplný autoenkodér se učí vibrační okna z ověřeného zdravého provozu čerpadel napříč zatížením a teplotou. Porovnává se se statistickými prahy a jednojádrovými metodami a prahová hodnota rekonstrukce je vybrána na základě revidovaných normálních přechodů a známých poruch. Hodnocení používá připomenutí událostí, dobu varování, falešná upozornění na provozní hodinu a výsledky podle čerpadla, nikoli náhodná okna, která umisťují sousední vzorky do tréninku a testu.
Produkční model je podmíněn stavem provozu a odhaluje zbytkové vzory inženýrům. Vysoká chyba vyžaduje inspekci; ne diagnostikuje součást ani automaticky nezastaví čerpadlo. Odpojení senzoru, oříznutí a neviděné zatížení vytvářejí explicitní neplatné stavy. Monitorování sleduje distribuci rekonstrukcí, potvrzení upozornění a stav senzoru. Když údržba nebo změna hardwaru změní základní linii, starý model zůstává dostupný, zatímco kandidát je trénován na revidovaných datech a přehráván proti historickým incidentům.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Zaveďte reprodukovatelný výchozí stav a verzovanou evaluační sadu před laděním. Testujte běžné případy, okrajové podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislostí, zneužití a skupiny či prostředí, která jsou pravděpodobně nedostatečně obsloužena. Měřte kvalitu úlohy spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoc pro vydání, výjimky, změny, rollback a ukončení. Použijte postupné nasazení, zachovejte bezpečnou záložní možnost a ověřte monitorování s úmyslně vloženými selháními. Provozní telemetrie by měla odhalit kvalitu vstupu, chování výstupu, verzi modelu nebo pravidla, zdraví závislostí, lidské zásahy a potvrzené výsledky bez sběru zbytečných citlivých dat. Definujte prahová upozornění a odpovědnost za reakci, poté přezkoumejte reálné důkazy po nasazení místo předpokladu, že offline výkon přetrvá. Přehodnoťte kdykoli se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také potřebuje dokumentované postupy obnovy, učení se z incidentů, mazání a uchovávání a jasný bod, kdy by měl být deaktivován nebo nahrazen.
Často kladené otázky
Jsou autoenkodéry bezztrátová komprese?
Obecně ne. Obvykle se učí ztrátové reprezentace specifické pro úlohu a distribuci a vyžadují trénovaný dekodér k rekonstrukci dat.
Je každý úzký průchod interpretovatelný?
Ne. Kompaktní kód může být užitečný, aniž by každá dimenze odpovídala lidsky čitelnému konceptu.
Primární reference