Andersonův úhel
Jak poznat, kdy systémy syntézy obrazu vytvářejí skutečně originální materiál

 Přidejte Unite.AI mezi své preferované zdroje na Google

Klíčové bodySkóre vzácnosti (Rarity Score) od KAIST a NAVER měří originalitu obrázků pomocí…
Zobrazit více
- Skóre vzácnosti (Rarity Score) od KAIST a NAVER měří originalitu obrázků pomocí vzdáleností k nejbližším sousedům.
- Stávající metriky, jako je Truncation Trick, upřednostňují autentičnost před novostí u generovaných obrázků.
- Skóre vzácnosti by mohlo identifikovat skutečně vynalézavé výstupy ze systémů, jako je DALL-E 2.
Nová jihokorejská studie navrhuje metodu, jak určit, zda systémy syntézy obrazu vytvářejí skutečně nové obrazy, nebo jen drobné varianty trénovacích dat, což by mohlo mařit cíl těchto architektur: tvorbu nových a originálních obrazů.
Podle studie velmi často platí druhá možnost, protože dosavadní metriky používané ke zlepšování generativních schopností během trénování nutně zvýhodňují obrazy blízké skutečným zdrojovým obrazům v datové sadě.
Je-li obraz vizuálně blízký zdrojovým datům, pravděpodobně získá lepší hodnocení autenticity než originality, protože je věrný předloze, byť nepříliš nápaditý.
V odvětví příliš mladém a neprověřeném na to, aby byly známy právní důsledky, se z toho může stát významný právní problém, pokud se komerčně využívaný syntetický obrazový obsah dostatečně neliší od často autorsky chráněných zdrojů, které nyní mohou pronikat do výzkumu prostřednictvím populárních datových sad získaných z webu. Možnost takových budoucích nároků z porušení práv nedávno získala pozornost v souvislosti s GitHub Co-Pilot AI společnosti Microsoft.
U stále soudržnějších a sémanticky přesvědčivějších výstupů systémů jako DALL-E 2 od OpenAI, Imagen od Googlu, čínský CogView i méně výkonný DALL-E mini existuje jen velmi málo způsobů, jak originalitu vygenerovaného obrazu spolehlivě ověřit dodatečně.
Hledání nejpopulárnějších nových obrazů DALL-E 2 často podle použitého vyhledávače vede pouze k dalším kopiím týchž obrazů.

Nahrání celé devítiobrázkové skupiny výstupů DALL-E 2 vede jen k dalším takovým skupinám, protože mřížka je nejsilnějším rysem. Oddělení a nahrání prvního obrazu z tohoto příspěvku na Twitteru z 8. června 2022, z účtu Weird Dall-E Generations, přiměje Google soustředit se na basketbalový míč a zavede obrazové hledání do sémantické slepé uličky. Yandex u stejného obrazu alespoň zřejmě skutečně analyzuje pixely a porovnává příznaky.
Yandex sice pravděpodobněji než Google Search používá skutečné příznaky obrazu, tedy jeho odvozené či vypočítané charakteristiky, nikoli nutně rysy lidských tváří, a vizuální namísto sémantických vlastností pro hledání podobných obrazů, ale všechny obrazové vyhledávače mají určité cíle nebo postupy, které mohou ztěžovat odhalení plagiátorství typu zdroj>vygenerovaný obraz pomocí webového hledání.
Trénovací data generativního modelu navíc nemusí být veřejná v celém rozsahu, což dále komplikuje forenzní zkoumání originality výstupů.
Zajímavé je, že obrazové hledání jedné ze syntetických ukázek na webu Imagen Googlu nenajde nic srovnatelného s námětem obrázku, pokud by měl vyhledávač skutečně posoudit obraz a nestranně hledat podobné. Google Images se opět upíná k významu a neumožní čistě obrazové hledání bez doplnění omezujících slov imagen google:

Yandex naproti tomu nachází mnoho podobných nebo alespoň vizuálně souvisejících skutečných obrazů od amatérských umělců:

Bylo by lepší, kdyby se novost či originalita výstupů dala měřit bez získávání příznaků ze všech webově dostupných obrazů v době trénování modelu nebo z neveřejných sad, které mohou využívat autorsky chráněný obsah.
Výzkumníci z Kim Jaechul Graduate School of AI při Korea Advanced Institute of Science and Technology (KAIST AI) proto spolu s globální ICT a vyhledávací společností NAVER Corp vyvinuli skóre vzácnosti (Rarity Score), které může pomoci rozpoznat originálnější výtvory obrazových generátorů.

Obrazy vznikly pomocí StyleGAN-FFHQ. Sloupce zleva doprava ukazují nejhorší až nejlepší výsledky. Metriky Truncation trick a Realism mají vlastní cíle, zatímco nové skóre vzácnosti v horním řádku hledá obrazy soudržné i originální, nikoli pouze soudržné. Kvůli omezené velikosti obrázků v článku najdete podrobnosti a vyšší rozlišení v původní studii. Zdroj: https://arxiv.org/pdf/2206.08549.pdf
Nová studie se nazývá Rarity Score: A New Metric to Evaluate the Uncommonness of Synthesized Images (Skóre vzácnosti: nová metrika hodnocení neobvyklosti syntetických obrazů) a pochází od tří výzkumníků z KAIST a tří z NAVER Corp.
Za hranice levného triku
Mezi starší metriky, které nová práce chce zlepšit, patří Truncation trick navržený v roce 2019 ve spolupráci britské Heriot-Watt University a DeepMind společnosti Google.
Truncation trick používá pro vzorkování jiné latentní rozdělení než při trénování generativního modelu.
Autoři byli překvapeni, že metoda funguje, ale přiznávají, že omezuje pestrost výstupů. Přesto se stala účinnou a oblíbenou jako jakýsi levný trik k získání autenticky vyhlížejících výsledků, které neobsáhnou všechny možnosti dat a mohou se zdroji podobat více, než je žádoucí.
Autoři nové práce uvádějí:
„Metoda není určena k vytváření vzácných vzorků trénovacích dat, ale ke stabilnější syntéze typických obrazů. Předpokládáme, že současné generativní modely mohou vytvářet vzorky bohatší z hlediska skutečného rozdělení dat, pokud generátor přimějeme účinně produkovat vzácné vzorky.“
K běžnému spoléhání na tradiční metriky jako Frechet Inception Distance (FID), která čelila silné kritice v prosinci 2021, Inception Score (IS) a Kernel Inception Distance (KID) coby ukazatele pokroku při trénování autoři dodávají*:
„Toto schéma učení vede generátor k tomu, aby nevytvářel mnoho vzácných, jedinečných vzorků s výraznými vlastnostmi, které v reálném rozdělení obrazů mají malý podíl. Příkladem z veřejných sad jsou lidé s různými doplňky v FFHQ, bílá zvířata v AFHQ a neobvyklé sochy v Metfaces.
„Schopnost vytvářet vzácné vzorky je důležitá nejen pro mezní možnosti generativních modelů, ale také proto, že jedinečnost je podstatná pro tvůrčí aplikace, například virtuální lidi.
„Kvalitativní výsledky několika nedávných studií však tyto vzácné příklady obsahují jen výjimečně. Domníváme se, že adversariální učení nutí rozdělení výstupů podobat se trénovací sadě. Jasně osobité či vzácné obrazy tak tvoří jen malý podíl výsledků.“
Technika
Nové skóre vzácnosti přizpůsobuje myšlenku z dřívějších prací: použití K nejbližších sousedů (KNN) k reprezentaci souborů skutečných trénovacích dat a syntetických výstupů systému.
Autoři o nové analýze uvádějí:
„Předpokládáme, že běžné vzorky budou blízko u sebe, zatímco jedinečné a vzácné budou v prostoru příznaků rozmístěny řídce.“
Obraz výsledků výše ukazuje vzdálenosti nejbližších sousedů (NND) od nejmenších po největší u architektury StyleGAN trénované na FFHQ.
„Ve všech sadách vzorky s nejmenšími NND ukazují reprezentativní a typické obrazy. Vzorky s největšími NND mají naopak silnou osobitost a výrazně se liší od typických obrazů s nejmenšími NND.“
Teoreticky by použití metriky jako diskriminátoru nebo součásti složitějšího diskriminátoru mohlo systém nasměrovat od pouhého napodobování k vynalézavějšímu algoritmu. Přitom by zachoval soudržnost pojmů zásadních pro autentickou tvorbu obrazů, například muž, žena, auto, kostel a podobně.
Srovnání a experimenty
Ve zkouškách výzkumníci porovnali skóre vzácnosti s Truncation trick a s Realism Score společnosti NVIDIA z roku 2019. Napříč různými systémy a datovými sadami metoda dokázala rozpoznat jedinečné výsledky.
Výsledky studie jsou příliš rozsáhlé pro uvedení zde, ale výzkumníci zřejmě ukázali, že nová metoda identifikuje vzácnost jak u skutečných zdrojových, tak u generovaných obrazů:
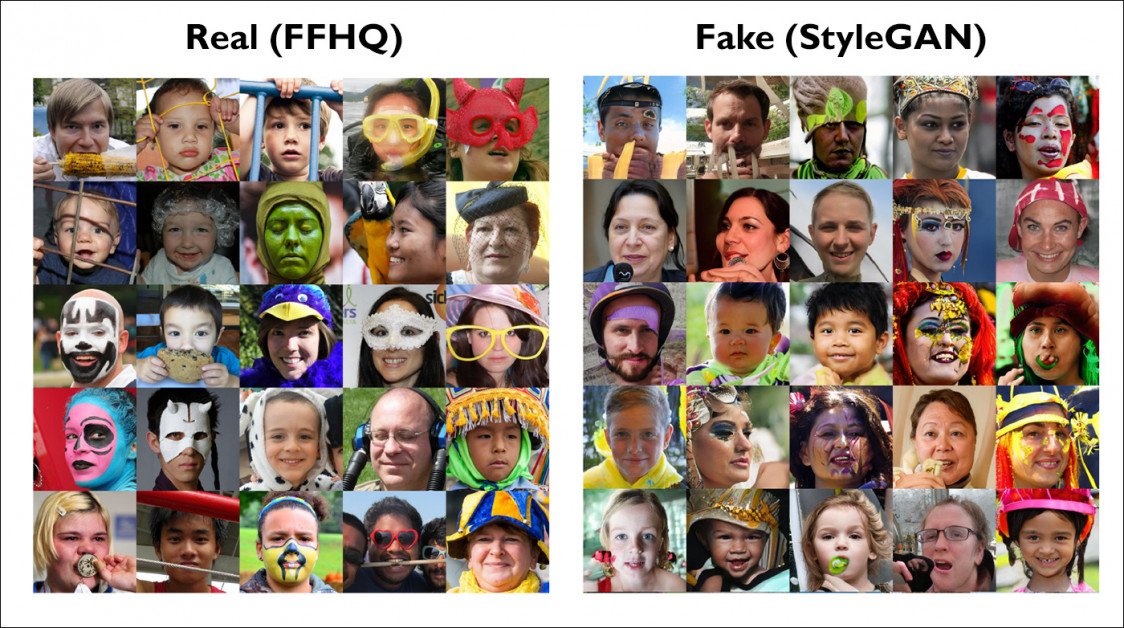
Vybrané příklady z rozsáhlých vizuálních výsledků studie; podrobnosti viz zdroj výše. Vlevo jsou skutečné příklady z FFHQ s velmi malým počtem blízkých sousedů v původní sadě, tedy nové a neobvyklé. Vpravo jsou syntetické obrazy vytvořené StyleGAN, které nová metrika označila za skutečně nové. Kvůli omezení velikosti obrázků viz původní studie pro podrobnosti a vyšší rozlišení.
Nové skóre vzácnosti nejen umožňuje rozpoznat nové výstupy jediné architektury, ale podle výzkumníků dovoluje porovnávat generativní modely různých architektur, například autoenkodéry, VAE či GAN.
Studie uvádí, že se metrika od starších liší zaměřením na schopnost vytvářet jedinečné a vzácné obrazy. Tradiční metriky omezeněji zkoumají pestrost mezi výstupy během trénování.
Za hranice omezených úloh
Ačkoli studie testovala systémy pro omezené oblasti, například generátor a datovou sadu pro obrazy lidí či koček, skóre vzácnosti by mohlo být použito pro libovolnou syntézu obrazů. Hledalo by výstupy využívající rozdělení odvozená z trénovacích dat místo zvyšování autenticity a snižování pestrosti vložením cizích latentních rozdělení nebo jiných zkratek obětujících novost ve prospěch autenticity.
Metrika by tedy mohla rozpoznat skutečně nové výstupy třeba u řady DALL-E pomocí vzdálenosti mezi zdánlivě odlehlým výsledkem, trénovacími daty a výsledky podobných pokynů či vstupů, včetně obrazových pokynů.
V praxi přesně nevíme, do jaké míry systém skutečně vstřebal vizuální a sémantické pojmy; často nám v tom brání omezené znalosti trénovacích dat. Přesto by metoda mohla identifikovat skutečný okamžik inspirace generativního systému: bod, kdy dostatek vstupních pojmů a dat vytvoří něco opravdu vynalézavého namísto něčeho příliš odvozeného nebo podobného zdrojům.
* Převedl jsem průběžné citace autorů na hypertextové odkazy.
Poprvé publikováno 20. června 2022.