
Základy AI
Co je KNN (K-Nearest Neighbors)?

 Přidejte Unite.AI mezi své preferované zdroje na Google
K-nearest neighbors (KNN) předpovídá výsledek na základě označených tréninkových příkladů nejbližších k dotazovacímu bodu. Pro klasifikaci sousedé hlasují o třídě. Pro regresi se jejich cílové hodnoty zprůměrují nebo jinak kombinují.
KNN je metoda založená na instancích, neobecňující: při trénování se převážně ukládají tréninkové příklady a volitelný vyhledávací index. To neodstraňuje potřebu rozdělení na trénovací, validační a testovací sadu. Vyhodnocení na vyhrazených datech je nezbytné pro výběr k, metriky vzdálenosti, zpracování vlastností a pravidla hlasování.
Klíčové poznatky
- KNN předpovídá lokálně; nejprve nedělí datovou sadu na shluky.
- Škálování vlastností je kritické, protože vzdálenost určuje, které příklady jsou považovány za sousedy.
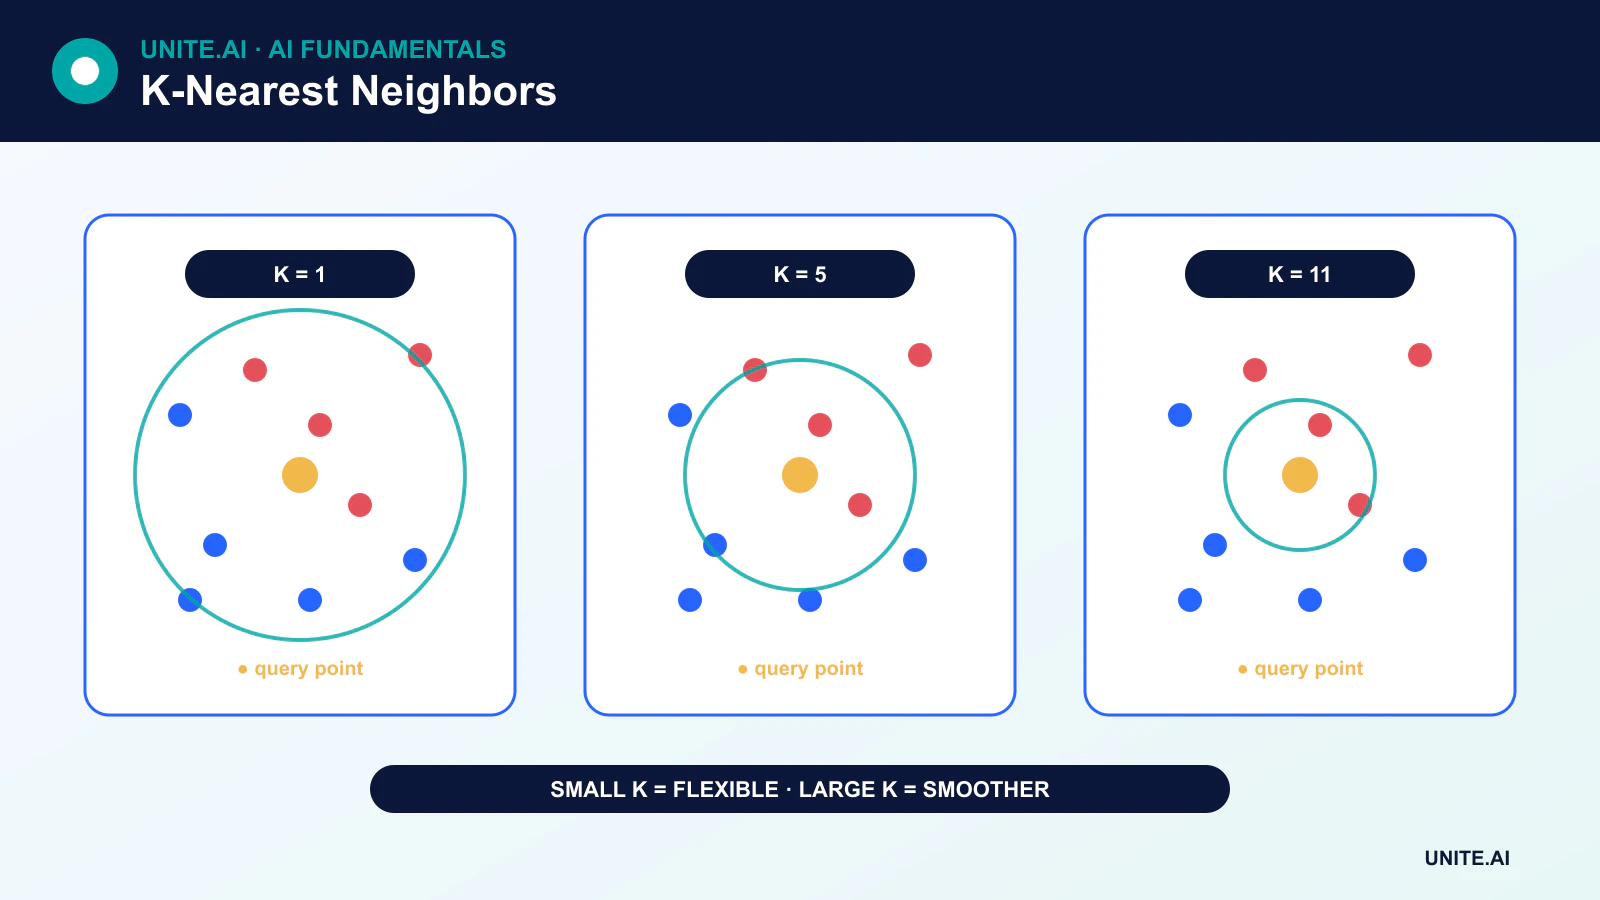
- Malé k může být hlučné, zatímco velké k může vyhladit místní strukturu.
- Vysoký počet rozměrů, irelevantní vlastnosti, nevyváženost tříd a pomalé vyhledávání mohou omezovat výkon.
Jak funguje klasifikace KNN
- Zobrazte dotaz a tréninkové příklady ve stejném prostoru vlastností.
- Vypočítejte vzdálenost od dotazu k tréninkovým příkladům.
- Vyberte k nejbližších příkladů.
- Predikujte většinovou třídu nebo použijte hlasování vážené vzdáleností.
Vážené hlasování dává bližším sousedům větší vliv. V případě remízy je potřeba dokumentované pravidlo a sousedé se stejnou vzdáleností a odlišnými štítky mohou způsobit, že výsledky závisí na pořadí nebo na detailech implementace.
Regrese KNN
U regrese je predikce obvykle průměrem cílových hodnot sousedů. Vážené vzdáleností může snížit vliv vzdálenějších pozorování. Medián nebo robustní agregace mohou být užitečné, když lokální cíle obsahují odlehlé hodnoty.
Metriky vzdálenosti
Eukleidovská vzdálenost je běžná pro spojité vlastnosti, Manhattanova vzdálenost sčítá absolutní rozdíly a kosinová vzdálenost se zaměřuje na směr spíše než na velikost. Ostatní metriky se používají pro binární, kategorické, geografické, sekvenční nebo naučené embedovací údaje.
Označení KNN jako „neparametrické“ znamená, že nepředpokládá pevnou konečně‑dimenzionální funkční formu rozhodovací hranice. Stále předpokládá, že zvolená reprezentace a metrika dělají blízké body relevantními k sobě navzájem.
Proč je škálování důležité
Pokud se jedna vlastnost pohybuje v rozmezí 0 až 1 a druhá od 0 do 100 000, běžná eukleidovská vzdálenost bude dominována druhou vlastností. Standardizaci, normalizaci nebo doménově specifické transformace je třeba nastavit na trénovací části a aplikovat na validační, testovací a produkční data.
Irrelevantní vlastnosti také zkreslují sousedství. Výběr vlastností, redukce dimenzionality nebo naučené reprezentace mohou pomoci, ale každé rozhodnutí musí být ověřeno bez úniku dat.
Volba k
Při k = 1 může model sledovat šum a špatně označené příklady. Jak k roste, predikce se stávají plynulejšími a méně citlivými na jeden bod. Pokud se k stane příliš velkým, dominují vzdálené třídy nebo oblasti a model podfituje.
Zvolte k pomocí cross‑validace na trénovacích datech. Pro binární klasifikaci liché k snižuje, ale neodstraňuje remízy. Váhy tříd, stratifikovaná rozdělení, výběr prahu a vhodné metriky jsou důležité, když jsou třídy nevyvážené.
Prokletí dimenzionality
Ve vysoce‑dimenzionálních prostorech mohou být vzdálenosti méně informativní, protože příklady jsou řídké a nejbližší i nejvzdálenější vzdálenosti se stávají relativně podobnými. KNN může vyžadovat obrovské množství dat k udržení smysluplných lokálních sousedství. Toto je prokletí dimenzionality.
Redukce dimenzionality nebo úlohově specifické embedování může pomoci, ale geometrie embedování by měla být ověřena pro zamýšlený pojem podobnosti.
Výkon vyhledávání
Brute‑force dotaz porovnává nový bod se všemi uloženými příklady. KD‑stromy a ball‑stromy zrychlují některá přesná vyhledávání, i když jejich výhody slábnou ve vysokých dimenzích. Přibližné indexy nejbližších sousedů vyměňují malý úbytek recall za velké zrychlení a úsporu paměti. Tento koncept také stojí za vyhledáváním vektorové podobnosti.
Silné stránky a omezení
KNN je jednoduchý, podporuje nepravidelné rozhodovací hranice a poskytuje intuitivní vysvětlení založené na příkladech. Může však také vyžadovat značnou paměť, odhalovat citlivé tréninkové příklady, predikovat pomalu a chovat se špatně, když vzdálenost nemá smysl. Je užitečnou referenční metodou – není to metoda, která je ve výchozím nastavení vysoce přesná pro většinu problémů.
Vzdálenost, sousedství a chování hyperparametrů
K‑nearest neighbors ukládá tréninkové příklady a predikuje z k nejbližších podle zvolené vzdálenosti. Klasifikace používá většinový nebo vážený hlas; regrese zprůměruje cíle sousedů. Škálování je zásadní, protože vlastnost s velkým rozsahem může dominovat eukleidovské vzdálenosti. Kategorická, řídká, sekvenční nebo geografická data mohou vyžadovat Hammingovu, kosinovou, editaci, velkokružní nebo naučené vzdálenosti. Metrika je modelovací předpoklad o podobnosti a měla by být ověřena vůči skutečnému významu blízkých případů.
Malé k vytváří flexibilní hranice s vysokou variancí a citlivostí na šum; velké k vyhlazuje predikce a může vymazat menšinovou strukturu. Liché k pouze eliminuje některé binární remízy a není obecné pravidlo. Zvolte k, vzdálenost, vážení, sadu vlastností a předzpracování v rámci cross‑validace. Nevyváženost tříd může způsobit, že lokální většinové hlasování ignoruje vzácné výsledky, proto je nutné sledovat recall pro každou třídu a složení sousedství. Vysokodimenzionální vzdálenosti mají tendenci koncentrovat se a irelevantní vlastnosti zhoršují sousedství; výběr, redukce dimenzionality nebo naučené embedování mohou pomoci.
Indexování, nejistota a provoz v produkci
Naivní inference porovnává dotaz se všemi tréninkovými body. KD‑stromy a ball‑stromy pomáhají v nízkých dimenzích; přibližné indexy nejbližších sousedů vyměňují přesnost za rychlost a škálovatelnost. Recall vyhledávání sousedů měřte odděleně od predikční kvality. Paměť zahrnuje uložené vlastnosti, štítky a struktury indexu. Aktualizace jsou konceptuálně jednoduché, ale mohou vyžadovat přestavbu indexu, konzistenci verzí a šíření mazání. Chraňte citlivé tréninkové příklady, protože vracení sousedů nebo vzdáleností může odhalit záznamy.
KNN může ukázat příklady, které činí predikci srozumitelnou, ale blízkost není příčinnost ani spravedlnost. Poskytněte vzdálenost, rozdíl hlasů a pravidlo abstinence, když jsou sousedství řídká nebo konfliktní. Sledujte vzdálenost dotazu, štítky sousedů, posun vlastností, latenci a potvrzené výsledky. Udržujte synchronizaci předzpracování a verzí indexu a po změnách testujte přesné versus přibližné výsledky. KNN je účinnou lokální referenční a vyhledávací metodou, když je vzdálenost smysluplná; má problémy, když podobnost nelze vyjádřit dostupnými vlastnostmi.
Praktický příklad: KNN pro nahrazení produktu
Maloobchodník reprezentuje produkty pomocí standardizovaných číselných atributů, kategoriální kompatibility a naučeného textového embedování, poté definuje váženou vzdálenost posuzovanou nákupčími. K a váhy jsou vybírány na základě pozdějších uvedení produktů, nikoli náhodných řádků položek. Vyhodnocení kontroluje relevantní recall substitutů, nekompatibilní doporučení, vzdálenost, pokrytí kategorií a výsledky pro vzácné položky. Populační referenční model ukazuje, zda lokální podobnost přináší hodnotu.
Přibližný index je benchmarkován oproti přesným sousedům z hlediska recall a latence. Dotazy bez blízké kompatibilní položky nevrací žádný návrh místo nuceného souseda. Odstranění produktů a opravy atributů se propagují do indexu prostřednictvím verzovaných aktualizací. Monitorování sleduje rozdělení vzdáleností, prázdné výsledky, přepsání a obchodní výsledky, aniž by docházelo ke zmatení prodeje s pravou kompatibilitou. Citlivé podmínky dodavatele jsou v vysvětleních vyloučeny a vrácené příklady zůstávají důkazem podobnosti – ne tvrzením, že produkty jsou ekvivalentní.
Důkazy o implementaci a připravenost na provoz
Rozhodnutí o nasazení do produkce vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Zaveďte reprodukovatelný základ a verzovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislostí, zneužití a skupiny či prostředí, které jsou nejvíce nedostatečně obslouženy. Měřte kvalitu úlohy spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a rozlišit důkazy od atraktivního prototypu.
Před nasazením přiřaďte pravomoc pro vydání, výjimky, změny, rollback a ukončení. Použijte postupné nasazení, zachovejte bezpečný fallback a ověřte monitorování pomocí úmyslně vložených selhání. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky, aniž by sbírala zbytečná citlivá data. Definujte prahové hodnoty upozornění a odpovědného, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte vždy, když se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také potřebuje dokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Má KNN tréninkovou fázi?
Má jen málo ladění parametrů, ale stále má vývojový proces: předzpracování se učí z trénovacích dat, může být vytvořen index a k, metrika, váhy a vlastnosti jsou vybírány pomocí validace.
Je KNN totéž jako K-means?
Ne. KNN je především metoda řízené lokální predikce. K-means je neřízený shlukovací algoritmus, ve kterém K je počet středů shluku.
Primární reference












