
Základy AI
Co je konverzační rozpoznávání řeči (CSR)?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Rozpoznávání konverzační řeči (CSR) rozšiřuje automatické rozpoznávání řeči (ASR) mimo izolovanou transkripci tím, že využívá kontext dialogu, signály střídání řeči, informace o mluvčím a zpracování s nízkou latencí. Cílem je podpořit živou interakci, ve které jsou důležitá slova, načasování, přerušení i předchozí tahy.
CSR je vznikající označení produktu i výzkumu, nikoli jednotná standardizovaná třída modelů. Silný systém kombinuje streamovací ASR s určením konce řeči, zpracováním mluvčích, kontextovým jazykovým modelováním, stavem dialogu a politikou odpovědí a poté hodnotí celou zkušenost od začátku do konce.
Klíčové poznatky
- Streamovací rozpoznávání vydává provizorní hypotézy a upravuje je, jakmile přichází další audio.
- Určování konce řeči a předpověď střídání jsou oddělené od přesnosti transkripce.
- Historie konverzace a hotwordy mohou rozpoznávání zlepšit, ale také šířit dřívější chyby.
- Hodnoťte latenci, přerušení, mluvčí, přízvuky, šum, soukromí a dokončení úkolu – ne jen chybovost slov.
Od ASR k živému dialogu
Tradiční ASR převádí audio na text. Konverzační systém musí rozhodnout, kdy poslouchat, kdy je tah ukončen, zda je řeč směrována k systému, a jak se zotavit, když je jeho transkript nebo odpověď nesprávná.
Streamovací modely zpracovávají snímky postupně a vytvářejí částečné transkripty. Nízká latence zvyšuje reakční rychlost, ale předčasné závazky mohou zvyšovat revize nebo chyby. Aplikace potřebuje politiku pro stabilní versus provizorní text.
Střídání řeči, překrytí a mluvčí
Délka ticha samotná je slabý signál konce řeči. Lexikální dokončení, prosodie, načasování, pohled a stav dialogu mohou pomoci předpovědět, zda osoba drží slovo nebo jej předává. Přerušení (barge‑in) umožňuje uživateli přerušit syntetizovanou řeč, aniž by ztratil kontext.
Překrývající se hlasy a diarizace zůstávají obtížné. Systémy by měly zachovat nejistotu ohledně mluvčího, vyhnout se přiřazení výroku nesprávné osobě a poskytnout cestu ke korekci – zejména u záznamů používaných ve zdravotnictví, financích nebo právní práci.
Kontextové rozpoznávání
Předchozí tahy mohou rozlišit jména a odkazy; seznamy hotwordů mohou nasměrovat rozpoznávání k doménovým termínům. Modely řeči a jazyka mohou zakódovat audio a textový kontext ve sdíleném promptovacím nebo pozornostním rámci.
Kontext může také posílit chybně vytvořený dřívější transkript nebo uniknout informace mezi sezeními. Omezte historii na aktuální účel, oddělte důvěryhodná metadata od uživatelské řeči a použijte transformerový kontext s explicitními pravidly pro uchovávání a přístup.
Hodnocení a odpovědné nasazení
Uveďte streamovací chybovost slov, latenci prvního tokenu a finalizace, míru revizí, chyby konce řeči, úspěšnost barge‑in, přiřazení mluvčího a dokončení úkolu. Testujte skutečné mikrofony, šum, přízvuky, kódové přepínání, postižení a emocionálně nabitou řeč.
Hlasová data mohou identifikovat nebo odhalit citlivé informace. Používejte souhlas, minimalizaci, šifrování, omezení uchovávání a lidskou kontrolu. Propojte generované odpovědi s bezpečnostními kontrolami chatbotu, protože přesná transkripce nezaručuje, že je odpověď správná nebo oprávněná.
Od akustického vstupu k konverzačnímu stavu
Systém konverzační řeči zachytí audio, provede podmínění signálu, detekuje řeč, rozpozná slova nebo sémantické jednotky, identifikuje mluvčího podle potřeby a aktualizuje stav dialogu. Streamovací systémy vytvářejí částečné hypotézy před koncem výpovědi. Tyto hypotézy se mohou měnit, takže komponenty v následujícím řetězci musí rozlišovat provizorní od konečných výsledků.
Detekce hlasové aktivity a určení konce řeči rozhodují, kdy řeč začíná a kdy uživatel skončil. Pevné prahy ticha selhávají u pomalých mluvčích, šumu v pozadí a přemýšlivých pauz. Modely střídání řeči mohou využívat slova, prosodii, pohled a kontext dialogu, ale musí vyvážit rychlou odezvu proti přerušení mluvčího.
Diarizace odpovídá na otázku, kdo kdy mluvil; rozpoznání mluvčího odhaduje identitu; separace zdrojů izoluje překrývající se hlasy. Jedná se o různé úkoly s různými riziky. V setkáních, zdravotnictví a zákaznickém servisu může přiřazení správných slov správné osobě mít stejný význam jako chybovost slov v transkriptu.
Kontext, překrytí, emoce a obnovení interakce
Konverzační kontext řeší zájmena, elipsy, opravy, doménové termíny a odkazy na předchozí tahy. Systém může kombinovat akustické důkazy s historií dialogu a získanými znalostmi, ale předchozí kontext může také nasměrovat rozpoznávání k nesprávnému očekávání. Zachovejte audio důkazy a jistotu, aby kontext tiše nepřepisoval nejistotu.
Přirozený dialog zahrnuje zpětné kanály, přerušení, falešné začátky, smích, kódové přepínání a simultánní řeč. Reagující agent potřebuje zpracování barge‑in: zastavit nebo snížit svůj výstup, zachytit novou řeč uživatele, rozhodnout, zda přerušení mění záměr, a zotavit se bez duplikace nebo ztráty akce.
Prosodie a paralingvistické signály mohou naznačovat důraz nebo nejistotu, ale odhadování emocí, zdraví či úmyslu z hlasu je náchylné k chybám a kulturně podmíněné. Používejte takové odhady zdrženlivě, zveřejněte je tam, kde je to vhodné, a nečinite zásadní rozhodnutí na základě neovězeného štítku emocí.
Hodnocení, soukromí a návrh produkce
Chybovost slov zůstává užitečná, ale konverzační hodnocení by mělo také měřit přiřazení mluvčího, přesnost entit, úspěšnost sémantického úkolu, stabilitu částečných hypotéz, latenci konce řeči, úspěšnost přerušení, zotavení a míru uživatelských oprav. Segmentujte podle přízvuku, jazyka, zařízení, šumu, překrytí, stylu mluvy a podmínek sítě.
Streamovací architektura vyžaduje omezené vyrovnávací paměti, zpětný tlak, opětovné připojení, sekvenční čísla a explicitní finalizaci. Udržujte rozpočty latence modelu a dialogu oddělené, sledujte každý krok a testujte degradované sítě. Když systém spouští akce, potvrďte úmysl s vysokým dopadem a zajistěte, aby opakování byla idempotentní, aby opakované audio nebo opětovná připojení nevedly k duplicitním transakcím.
Řeč obsahuje identitu, obsah, prostředí a informace o přihlížejících. Minimalizujte uchovávání, šifrujte přenos i úložiště, kontrolujte přístup, definujte mazání a rozlišujte audio od odvozených transkriptů a embedování. Poskytněte viditelné indikátory nahrávání a alternativy, pokud není souhlas. Lokální model může snížit přenos, ale stále vyžaduje povolení a řízení životního cyklu.
Praktický příklad: hlasový agent řešící přerušení a opravu
Volající říká: „Rezervujte úterý – ne, středu odpoledne“, zatímco agent začíná odpovídat po slově „úterý“. Streamovací rozpoznávání vydává měnící se částečné transkripty, určení konce řeči detekuje pokračující řeč a barge‑in zastaví výstup. Stav dialogu označí dřívější datum jako nahrazené místo vytvoření dvou požadavků. Potvrzení entity se soustředí na opravené datum a čas, přičemž systém zachovává jistotu a důkazy pro konečnou interpretaci.
Architektura odděluje zachytávání audia, detekci řeči, streamovací rozpoznávání, zpracování mluvčího, politiku dialogu, provádění nástroje a syntézu. Sekvenční čísla a finalizace zabraňují pozdním částečným výsledkům přepsat finální transkript. Rezervační nástroj přijímá strukturovaný požadavek, kontroluje oprávnění a dostupnost a používá klíč idempotence. Výsledná rezervace je přečtena zpět a potvrzena před provedením; opětovné připojení nemůže tiše opakovat.
Testování kombinuje přesnost slov a entit s latencí konce řeči, úspěšností přerušení, zpracováním opravy, přiřazením mluvčího, dokončením úkolu a mírou duplicitních akcí. Scénáře zahrnují šum, překrytí, přízvuky, kódové přepínání, pomalou řeč, asistenční zařízení, slabé sítě a syntetické útoky. Uchovávání audia je minimalizováno a zveřejněno, data o přihlížejících jsou explicitně zpracována a uživatelé mohou přejít na text nebo na člověka. Konverzační inteligence se měří podle bezpečného zotavení a výsledku, nikoli jen podle přesnosti transkriptu.
Seznam kontrol pro praktickou implementaci
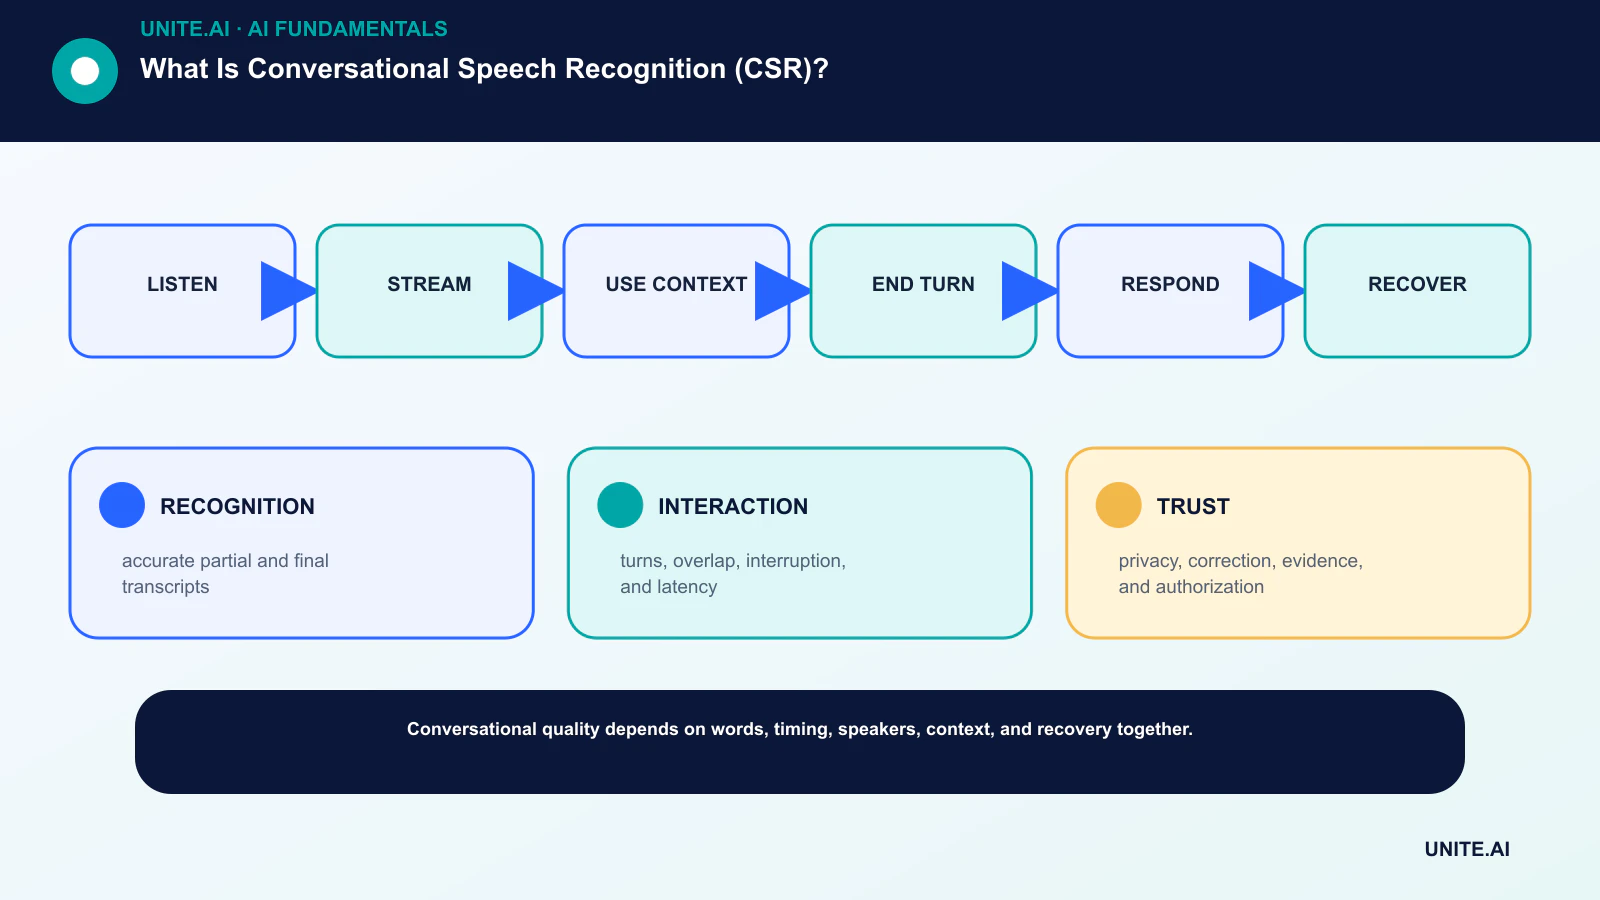
Přetvořte koncept na omezený, testovatelný pracovní postup: poslouchat → streamovat → použít kontext → ukončit tah → odpovědět → zotavit se. Určete odpovědnou osobu, zdokumentujte data a závislosti, vytvořte jednoduchý výchozí stav, stanovte kritéria přijetí a zastavení, otestujte reprezentativní selhání a definujte monitorování, rollback a revizi před rozšířením rozsahu. Zaznamenejte verze a předpoklady, aby jiný tým mohl výsledek reprodukovat a pochopit, co se změnilo.
Před nasazením proveďte zdokumentovanou revizi připravenosti s lidmi, kteří systém staví, provozují, zabezpečují a jsou jím ovlivněni. Testujte běžné případy, hraniční podmínky, selhání závislostí a zneužití; zachovejte důkazy a nevyřešená rizika. Definujte, kdo může schválit vydání, změnit práh, přepsat výstup nebo zastavit provoz. Rozhodnutí přehodnoťte po získání reálných dat, protože technicky úspěšný pilot nezaručuje spolehlivý výkon ve větším měřítku.
- ROZPOZNÁNÍ: přesné částečné a finální transkripty.
- INTERAKCE: tahy, překrytí, přerušení a latence.
- DŮVĚRA: soukromí, opravy, důkazy a oprávnění.
Často kladené otázky
Je CSR odlišné od ASR?
ASR je komponenta převodu řeči na text. CSR používá ASR spolu s kontextem dialogu, načasováním, zpracováním mluvčího a konce řeči a politikami interakce pro živou konverzaci.
Zaručuje nižší chybovost slov lepšího hlasového agenta?
Ne. Systém může přesně transkribovat, ale přesto přerušovat uživatele, odpovídat pomalu, nesprávně přiřazovat mluvčího nebo provést špatnou akci. Jsou vyžadovány metriky interakce od konce ke konci.
Primární reference












