Základy AI
Co je posilovací učení?

 Přidejte Unite.AI mezi své preferované zdroje na Google
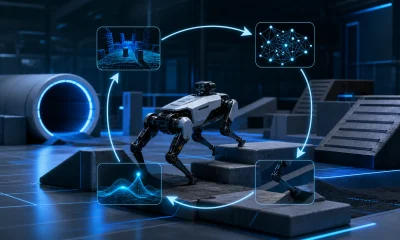
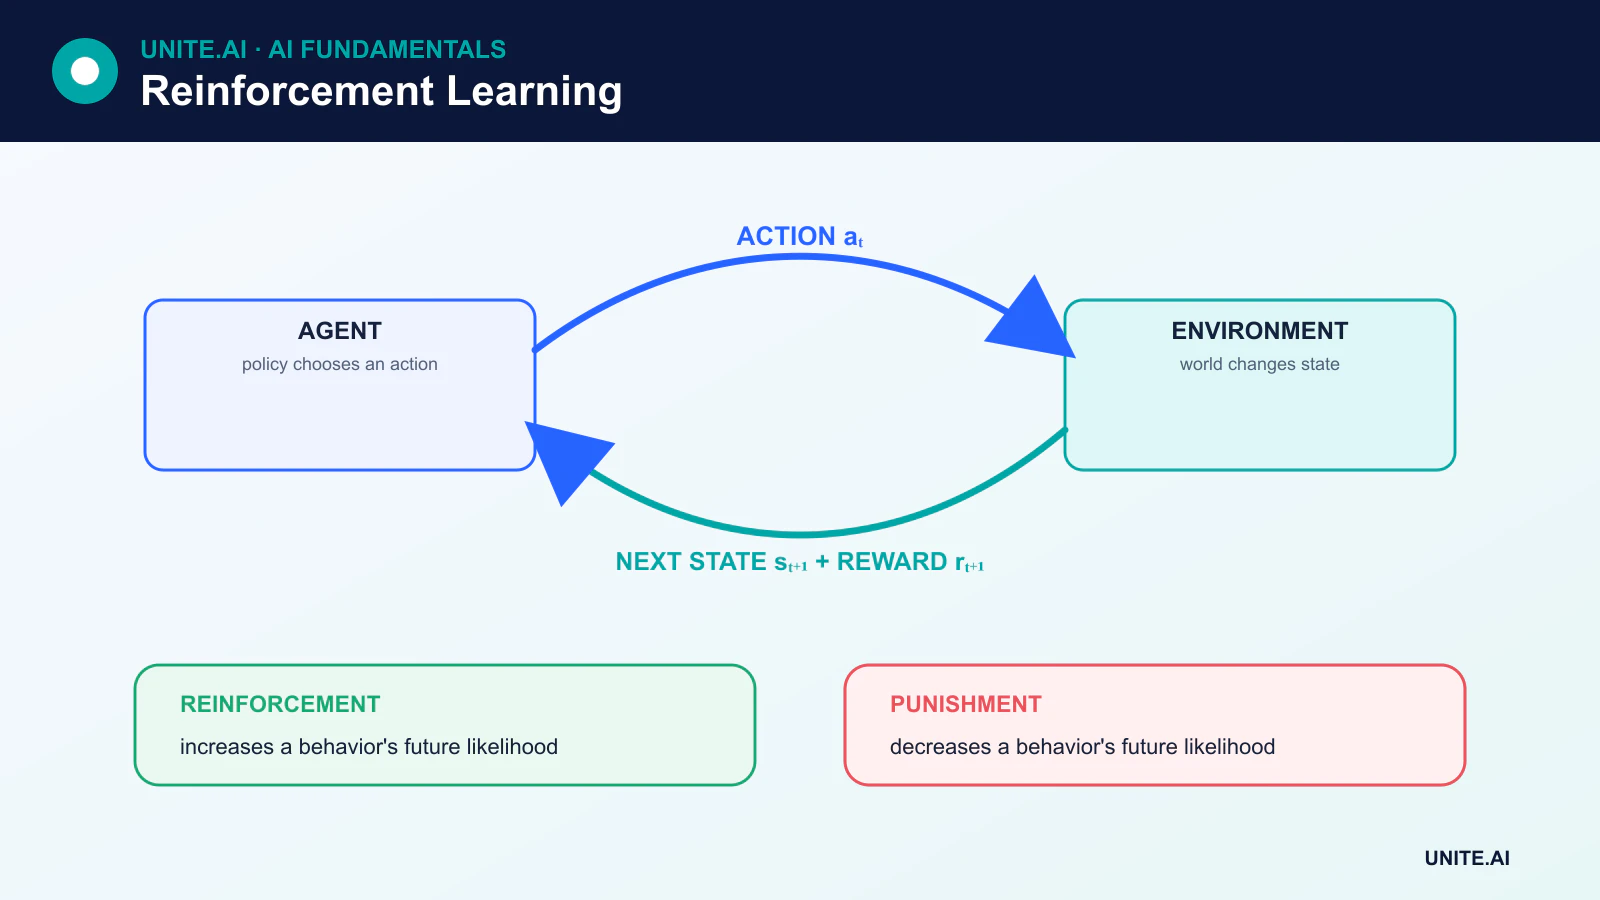
Reinforcement learning (RL) je rámec strojového učení, ve kterém se agent učí jednat prostřednictvím interakce s prostředím. Po každém kroku se prostředí změní a může vrátit odměnu. Cílem agenta je naučit se politiku, která maximalizuje očekávanou kumulativní odměnu, nikoli jen odměnu za následující tah.
RL se používá, když se rozhodnutí odehrávají v čase a jeden krok ovlivňuje, co se stane dál. Je konceptuálně odlišné od řízeného učení, kde datová sada poskytuje cílovou odpověď pro každý tréninkový příklad.
Klíčové body
- Problém RL obsahuje agenta, prostředí, stavy, akce, odměny a politiku.
- Pozitivní i negativní posilování oba zvyšují chování; trest snižuje chování.
- Agent musí vyvážit prozkoumávání neznámých akcí a využívání akcí, o kterých již ví, že fungují.
- Metody založené na hodnotě, politice, actor‑critic, model‑based a offline řeší různé nastavení RL.
Komponenty posilovacího učení
Mnoho problémů RL je modelováno jako Markovův rozhodovací proces (MDP). MDP zahrnuje:
- State: informace popisující aktuální situaci.
- Action: volba dostupná agentovi.
- Transition: jak se stav mění po akci.
- Reward: okamžitá zpětná vazba vzniklá při přechodu.
- Policy: strategie agenta pro výběr akcí.
- Discount factor: jak silně se budoucí odměny počítají vůči okamžitým odměnám.
Stav nemusí odhalovat vše o světě. Když jsou důležité informace skryté, může být problém částečně pozorovatelný a agent může potřebovat paměť nebo stav víry.
Posilování není to samé jako trest
Terminologie pochází z behaviorální psychologie. Pozitivní posilování přidává důsledek, který činí chování pravděpodobnějším. Negativní posilování odstraňuje nepříjemný stav a také činí chování pravděpodobnějším. Pokuta zaměřená na snížení pravděpodobnosti akce je trest, nikoli negativní posilování.
V strojovém učení se výzkumníci častěji vyjadřují přímo k pozitivním odměnám, negativním odměnám, nákladům a penalizacím. Klíčová otázka je, jak tyto signály formují návratnost, kterou se agent snaží maximalizovat.
Návratnost, hodnota a přiřazení kreditu
Odměna popisuje jeden přechod. Návratnost kombinuje odměny v čase, obvykle diskontuje odměny, které přicházejí dál v budoucnosti. Funkce hodnoty stavu odhaduje očekávanou návratnost ze stavu, zatímco funkce hodnoty akce odhaduje očekávanou návratnost po provedení konkrétní akce v tomto stavu.
Tím vzniká problém přiřazení kreditu: pokud užitečný výsledek nastane mnohem později, které dřívější akce si zaslouží kredit? Algoritmy RL se liší v tom, jak odhadují tento vztah.
Metody Monte Carlo a učení s časovým rozdílem
Metody Monte Carlo se učí z kompletních vzorkovaných návratností, typicky po skončení epizody. Metody časového rozdílu (TD) aktualizují odhad před konečným výsledkem kombinací pozorované odměny s odhadem toho, co přijde dál. TD učení tak odvozuje své odhady z aktuálních hodnot.
Žádná z těchto rodin není univerzálně lepší. Cíle Monte Carlo jsou nestranné podle vzorkované politiky, ale mohou mít vysokou varianci a vyžadují dokončení epizody. TD metody mohou učit online a z probíhajících úloh, ale jejich bootstrapped cíle zavádějí zaujatost.
Prozkoumávání versus využívání
Prozkoumávání shromažďuje informace vyzkoušením akcí, jejichž hodnota je nejistá. Využívání vybírá akci, o níž se v současnosti věří, že nabízí nejlepší návratnost. Agent, který nikdy neprozkoumává, může setrvat u slabé strategie; agent, který nikdy nevyužívá, nečerpá výhody ze získaných znalostí.
Jednoduché strategie zahrnují epsilon‑greedy výběr akcí, prozkoumávání založené na důvěře, entropní bonusy a metody vnitřní odměny. V prostředích, kde je bezpečnost kritická, může být neomezené prozkoumávání nepřijatelné, a proto se stávají důležité simulace, omezení, offline data nebo lidský dohled.
Hlavní přístupy posilovacího učení
Metody založené na hodnotě
Q‑learning a související algoritmy se učí hodnoty akcí a odvozují politiku výběrem akcí s vysokou hodnotou. Deep reinforcement learning používá neuronové sítě k aproximaci hodnotových funkcí nebo politik, když jsou prostory stavů příliš velké pro tabulku.
Metody gradientu politiky
Metody gradientu politiky přímo upravují parametrizovanou politiku za účelem zlepšení očekávané návratnosti. jsou užitečné pro spojité akce a stochastické politiky, ale mohou mít odhady gradientu s vysokou variancí.
Metody actor‑critic
Actor vybírá akce, zatímco kritik odhaduje hodnotu a poskytuje učební signál. Toto kombinuje přímou optimalizaci politiky s odhadem hodnoty.
Model‑based a model‑free RL
Systémy model‑based se učí nebo používají model přechodů a odměn, aby mohly plánovat. Systémy model‑free se učí hodnoty nebo politiky bez explicitního modelování prostředí. Metody model‑based mohou efektivně využívat zkušenosti, ale chyby v naučeném modelu mohou plánování zavést do omylu.
Offline posilovací učení
Offline RL se učí ze statického datového souboru místo sběru nových interakcí během tréninku. Může snížit náklady nebo riziko prozkoumávání, ale agent musí zabránit přeceňování akcí špatně zastoupených v datech.
RLHF a lidské preference
Reinforcement learning from human feedback (RLHF) používá data o preferencích k trénování signálu odměny nebo přímé optimalizaci politiky. Bylo použito k zarovnání chování jazykových modelů s lidskými úsudky. Optimalizace preferencí není zárukou pravdy nebo bezpečnosti: výsledky závisí na tom, kdo poskytl zpětnou vazbu, co bylo požadováno k posouzení a jak byl cíl navržen.
Omezení
RL může vyžadovat obrovské množství interakcí, během tréninku se může chovat nestabilně a využívat neúmyslné zkratky ve funkci odměny. Hodnocení je obtížné, protože výsledky se mohou lišit podle náhodných semínek a detailů prostředí. Osvědčená praxe zahrnuje více běhů, transparentní referenční modely, omezené cíle, testování mimo rozdělení a monitorování zneužívání odměny.
Navrhování problému RL: stav, akce, odměna a horizont
Posilovací učení modeluje sekvenční rozhodování. Prostředí poskytuje pozorování, agent podle politiky vybere akci a přechod vygeneruje odměnu a další pozorování. Markovův rozhodovací proces předpokládá, že stav obsahuje informace potřebné k předpovědi budoucích přechodů a odměn; částečná pozorovatelnost vyžaduje paměť, stav víry nebo rekurentní reprezentace. Diskontování řídí váhu odložených výsledků, zatímco epizodické a pokračující úlohy vyžadují odlišné definice návratnosti. Špatný návrh stavu nebo akce může učiněný řešitelný cíl nenaučitelným.
Návrh odměny specifikuje chování nepřímo a je hlavním zdrojem selhání. Proxy může být zneužita: agent odměněný za rychlost může ignorovat bezpečnost, zatímco ten odměněný jen při dokončení úlohy může dostat příliš málo učebního signálu. Přidejte omezení a pravidla ukončení založená na skutečných požadavcích, testujte citlivost odměny a kontrolujte trajektorie na neúmyslné strategie. Metody prozkoumávání vyvažují sběr informací s využíváním stávajících znalostí. Data mimo politiku mohou zlepšit efektivitu vzorkování, ale nesoulad mezi chováním a cílovou politikou vyžaduje algoritmy na to navržené.
Hodnocení, simulace a bezpečné nasazení
Metody založené na hodnotě odhadují očekávanou návratnost pro stavy nebo akce; metody gradientu politiky optimalizují parametrizovanou politiku; metody actor‑critic se učí oba. Model‑based RL se učí nebo používá dynamiku přechodů k plánování. Vhodná rodina závisí na typu akce, datech, věrnosti simulátoru, horizontu a požadavcích na stabilitu. Porovnávejte s heuristickými, řízenými a kontrolně‑teoretickými referencemi. Hodnoťte průměrnou i nejhorší případnou návratnost, porušení omezení, efektivitu vzorkování, odolnost vůči změnám prostředí a varianci napříč semínky, místo výběru běhu s nejlepším učebním křivkou.
Online prozkoumávání může být nepřijatelné ve zdravotnictví, financích, robotice a infrastruktuře. Trénujte v simulaci nebo na zaznamenaných datech, kde je to možné, kvantifikujte rozdíl mezi simulátorem a realitou a opatrně používejte hodnocení mimo politiku, protože neviděné akce postrádají podporu. Nasazení by mělo omezovat akce, rychlost, zdroje a provozní oblast; zahrnout lidské schválení pro rozhodnutí s důsledky a poskytovat bezpečný řídící prvek nebo vypnutí. Sledujte odměnu spolu se skutečnými výsledky, protože agent může zlepšit svůj skóre a zároveň škodit zamýšlenému cíli. Znovu ověřujte po změnách prostředí, politiky nebo odměny.
Praktický příklad: řízení energie pomocí posilovacího učení
Správce budovy modeluje teplotu, obsazenost, počasí, stav zařízení a cenu elektřiny, přičemž akce jsou omezeny na bezpečné úpravy nastavení. Odměna kombinuje komfort, energii, poplatky za odběr a omezení zařízení, ale skutečné porušení komfortu se hodnotí odděleně, takže optimalizace odměny nemůže skrýt škodu. Historické řízení a modelově‑prediktivní řízení poskytují referenční body. Trénink používá kalibrovaný simulátor s náhodným počasím, šumem senzorů a účinností zařízení.
Před ovlivněním budovy se politika spouští na živých pozorováních bez zásahu. Inženýři kontrolují trajektorie, okraje omezení a chování během svátků, včerejších vln vln? (teplotních vln), výpadků a chybějících senzorů. Nasazení omezuje rychlost a rozsah akcí a zachovává stávající bezpečnostní řídící prvek. Člověk může kdykoli přebít. Monitorování porovnává spotřebu energie a komfort s odpovídajícími obdobími, zaznamenává zásahy a vrací se zpět, pokud překročí definované prahy pro porušení, nečekané koloběhy nebo nesoulad modelu.
Důkazy o implementaci a operační připravenost
Rozhodnutí o nasazení do produkce vyžaduje víc než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledek každého důležitého selhání. Nastavte reprodukovatelnou referenci a verzovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun rozdělení, výpadek závislosti, zneužití a skupiny či prostředí, která jsou pravděpodobně nedostatečně obsloužena. Měřte kvalitu úlohy spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přidělte pravomoc pro vydání, výjimky, změny, rollback a ukončení. Použijte postupné nasazení, zachovejte bezpečnou náhradní možnost a ověřte monitorování pomocí úmyslně vložených selhání. Operační telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu či pravidla, stav závislostí, lidské přebití a potvrzené výsledky, aniž by shromažďovala zbytečná citlivá data. Definujte prahové hodnoty výstrah a odpovědnou osobu, poté po nasazení přezkoumávejte reálné důkazy místo předpokladu, že offline výkonnost přetrvá. Přehodnoťte kdykoli se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také potřebuje dokumentované postupy pro obnovu, učení z incidentů, mazání a archivaci a jasný okamžik, kdy by měl být deaktivován nebo nahrazen.
Primární reference