Základy AI
Co je Transfer Learning?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Transfer learning znovu využívá znalosti získané pro jeden problém k vylepšení učení na souvisejícím problému. Místo náhodného inicializování všech parametrů začíná odborník s předtrénovaným modelem nebo reprezentací a přizpůsobuje ji cílovému úkolu.
Tento přístup je zvláště užitečný, když je cílová datová sada malá, označování je nákladné, nebo předtrénování vyžaduje více výpočetního výkonu, než si tým může dovolit. Trénování modelu od nuly je alternativou k transfer learningu – ne typem transfer learningu.
Klíčové poznatky
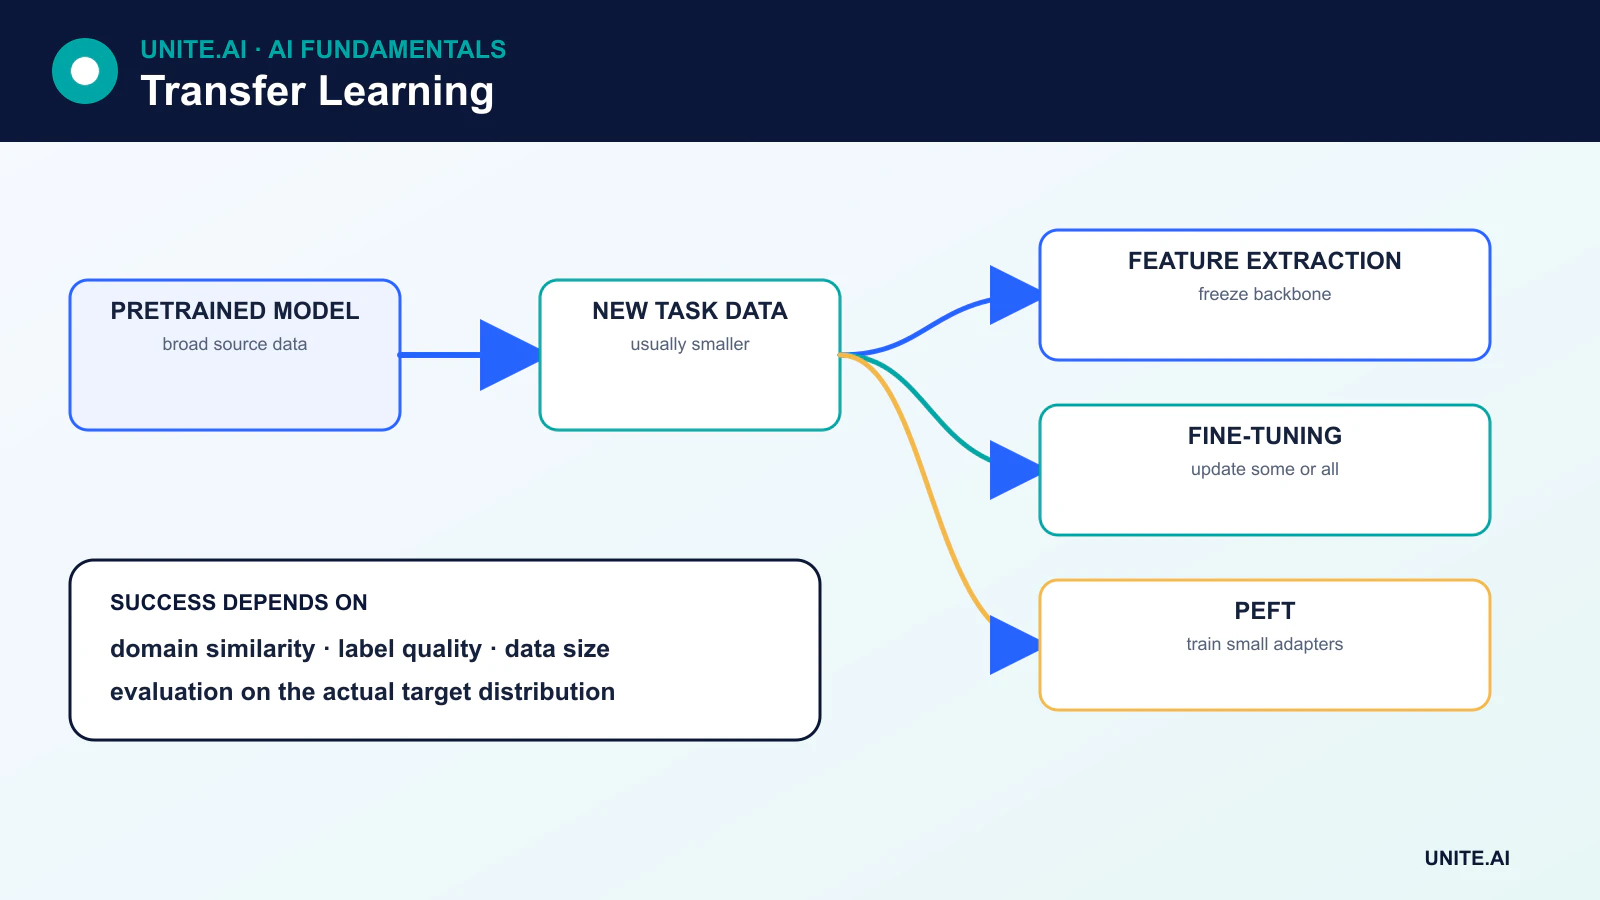
- Extrakce příznaků udržuje předtrénovanou základnu zmraženou a trénuje novou úlohově specifickou hlavu.
- Doladění aktualizuje některé nebo všechny předtrénované parametry pomocí dat z cílové domény.
- Parametricky úsporné metody, jako jsou adaptéry a LoRA, aktualizují malou část modelu.
- Transfer může selhat, když se zdrojové a cílové domény liší, licence jsou v konfliktu, nebo zdrojový model obsahuje nevhodné zkreslení.
Proč funguje transfer learning
Modely často učí reprezentace, které jsou užitečné i mimo přesná data, na nichž byly trénovány. Rané vrstvy obrazového modelu mohou zachytit znovupoužitelné lokální vzory; jazykový model může získat syntaxi, sémantiku a široké asociace ze samouzorčujícího predikčního úkolu. Cílový úkol může stavět na těchto reprezentacích místo toho, aby se učil vše znovu z omezených příkladů.
Výhoda závisí na podobnosti mezi zdrojovým a cílovým úkolem, rozsahu a kvalitě předtrénování a způsobu, jakým je model přizpůsoben. Opětovné využití není zaručeno: přenesené příznaky mohou být irelevantní nebo dokonce škodlivé.
Extrakce příznaků
Při extrakci příznaků je předtrénovaná základna zmražena, takže se její parametry nemění. Její výstup se stane vstupem pro nový klasifikátor, regresor nebo jinou úlohově specifickou hlavu. Trénuje se pouze nová hlava.
Toto je rychlé a datově úsporné a snižuje riziko zničení užitečných předtrénovaných reprezentací. Může však také podfiltrovat, když se cílová doména výrazně liší od předtrénování. Vrstvy jako normalizace dávky (batch normalization) vyžadují zvláštní péči, protože jejich uložené statistiky a chování během trénování mohou ovlivnit adaptaci i když jsou většina vah zmraženy.
Doladění
Doladění aktualizuje předtrénované parametry na cílových datech. Běžný pracovní postup je:
- Načtěte předtrénovaný model a nahraďte nebo přidejte výstupní hlavu.
- Zmražte základnu a trénujte novou hlavu.
- Odzmrazte vybrané vrstvy – nebo celý model – a pokračujte s menší učební rychlostí.
- Ověřte přetrénování, zapomínání a výkon v cílové doméně.
Neexistuje univerzální pravidlo, že by měly být laděny jen poslední vrstvy. Nejlepší volba závisí na architektuře, velikosti cílových dat, podobnosti domén, normalizačních vrstvách, paměti a výpočetních zdrojích. Plné doladění může poskytnout větší kapacitu, ale vyžaduje více prostředků a může způsobit katastrofické zapomínání.
Parametricky úsporné doladění
Velké transformery dělají plné doladění nákladným. Parametricky úsporné doladění (PEFT) upravuje nebo přidává malou sadu parametrů, zatímco většina základního modelu zůstává zmražena.
- Adaptéry vkládají do sítě malé trénovatelné moduly.
- LoRA představuje aktualizace vah pomocí nízkohodnotných matic, čímž snižuje počet trénovatelných parametrů a paměť optimalizátoru.
- Doladění promptů a prefixů učí kontinuální úlohově specifické vstupy nebo vnitřní prefixy.
PEFT může uložit mnoho úlohových adaptací kolem jednoho základního modelu, ačkoliv nasazení inference, kompatibilita adaptérů a správa sloučených vah stále vyžadují pečlivé inženýrství.
Transfer learning napříč typy dat
Klasifikátory obrázků obvykle začínají s modely předtrénovanými na velkých datasetů obrázků. Jazykové systémy vycházejí ze základního modelu a přizpůsobují jej pomocí řízeného doladění, optimalizace preferencí, vyhledávání nebo používání nástrojů. Modely řeči, audia, proteinů a multimodální modely následují podobné vzorce.
Transfer může také nastat bez změny původního modelu. Zmražený model může generovat embeddingy pro následný klasifikátor, systém vektorového podobnostního vyhledávání nebo vyhledávací pipeline.
Posun domény a negativní transfer
Posun domény nastává, když se cílové vstupy liší od zdrojových dat. Například model pro medicínské obrazy může narazit na zařízení, populace nebo akviziční protokoly, které chyběly při předtrénování. Negativní transfer znamená, že opětovné využití zhoršuje výkon v cíli oproti vhodnému baseline trénovanému od nuly.
Týmy by měly porovnat strategie adaptace, vyhodnotit smysluplné podskupiny a udržovat testovací sadu pro cílovou doménu. Pokud je zdrojový úkol špatně sladěn, menší doménově specifický model může překonat větší obecný model.
Licencování, původ a bezpečnost
Stáhnutelný model není automaticky bezpečný k nasazení. Přezkoumejte licenci, povolené použití, zveřejnění tréninkových dat, omezení modelové karty a řetězec závislostí. Modely mohou reprodukovat bias, zapamatovat si citlivá data nebo obsahovat škodlivý serializovaný kód. Používejte důvěryhodné formáty, skenujte artefakty a načítejte nedůvěryhodné váhy v izolovaném prostředí.
Kdy použít transfer learning
Transfer learning je silná výchozí volba, když existuje relevantní předtrénovaný model a cílová data jsou omezená. Trénování od nuly může být výhodnější, když je doména vysoce specializovaná, licence jsou nekompatibilní, velikost modelu přesahuje limity nasazení nebo jednoduchý úkol neprofituje z velké předtrénované reprezentace. Rozhodnutí by mělo být ověřeno empiricky, nikoli předpokládáno na základě velikosti modelu.
Co se přenáší a jak to přizpůsobit
Transfer learning znovu využívá reprezentace naučené na zdrojovém úkolu nebo datasetu pro cílový úkol. Ve vizuální oblasti často rané příznaky zachycují hrany a textury; v jazyce předtrénované modely kódují statistické vzory napříč tokeny a kontexty. Transfer funguje, když zdrojové reprezentace obsahují informace relevantní pro cíl, ale rozdíly v doméně, štítcích, modalitě a akvizici mohou způsobit negativní transfer. Začněte s předtrénovaným baseline, prověřte jeho licenci a dokumentaci a porovnejte s trénováním malého cílově specifického modelu od nuly.
Extrakce příznaků zmrazí páteř a trénuje novou hlavu; částečné doladění odmrzne vybrané vrstvy; plné doladění aktualizuje celý model. Parametricky úsporné metody přidávají adaptéry nebo nízkohodnotné aktualizace, čímž snižují počet trénovatelných parametrů, ale ne nutně paměť inference. Použijte nižší učební rychlost pro předtrénované váhy, zachovejte chování normalizace a vyhněte se katastrofickému zapomínání pomocí plánů, regularizace, opakování nebo omezených aktualizací, kde je to potřeba. Vyberte kontrolní body na validačních datech cíle a otestujte několik semínek, protože malé cílové datasety mají vysokou variabilitu.
Data, hodnocení a kompromisy při nasazení
Cílová data by měla reprezentovat podmínky nasazení a důležité podskupiny, nikoli jen pohodlný označený vzorek. Rozdělte podle subjektu, zdroje, času nebo místa, aby se související příklady nepřekrývaly mezi částmi. Testujte jak podmínky v doméně, tak posunuté podmínky. Porovnejte zmražené, částečně laděné a plně laděné varianty z hlediska kvality, kalibrace, nákladů na trénování, latence a odolnosti. Zlepšení průměrného skóre může skrývat ztrátu u vzácných tříd zděděných ze zdrojového biasu. Přezkoumejte příklady selhání kvůli zdrojově specifickým zkratkám, mezerám ve slovní zásobě nebo rozdílům v senzorech.
Sledujte základní model, váhy, tokenizér nebo předzpracování, adaptér, data a licenci jako jeden graf závislostí. Hostované základní modely mohou měnit chování; otevřené váhy mohou zavést odpovědnost za dodavatelský řetězec a opravy. Ověřte sloučený nebo exportovaný artefakt a skenujte soubory modelu z nedůvěryhodných zdrojů. V produkci monitorujte posun cíle a výkon a zachovejte možnost vrátit jak adaptaci, tak základní verzi. Transfer snižuje požadovaná cílová data; neodstraňuje označování, hodnocení, soukromí ani doménovou odbornost.
Praktický příklad: přizpůsobení vizuálního modelu nové klinice
Klinika přizpůsobuje předtrénovaný obrazový enkodér k klasifikaci kvality obrazu před diagnostickým přezkumem. Ověřuje licenci zdrojového modelu a zamýšlenou modalitu, sbírá místní zařízení a podmínky akvizice a rozděluje data podle pacientů. Varianty zmražených příznaků, adaptérů, částečného a plného doladění jsou porovnávány s malým místním baseline. Metriky zahrnují připomenutí třídy, kalibraci, chování podskupin, výpočetní náročnost a citlivost na zařízení, místo a vzácné artefakty.
Přizpůsobený model nedokáže stanovit diagnózu a směruje obrazy s nízkou důvěrou nebo nepodporované obrazy technikům. Exportní validace potvrzuje místní předzpracování a číselnou ekvivalenci. Model, adaptér, zařízení a verze datasetu jsou v záznamu propojeny. Monitorování detekuje nové skenery, změny protokolů a posun výstupu, zatímco periodické revizní vzorky odhadují skutečný výkon. Aktualizace zdrojového modelu se považuje za novou závislost vyžadující validaci; transfer learning automaticky neospravedlňuje opětovné použití starých důkazů.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení do produkce vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Zaveďte reprodukovatelný baseline a verzovanou evaluační sadu před doladěním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislostí, zneužití a skupiny či prostředí, která jsou pravděpodobně nedostatečně obsloužena. Měřte kvalitu úkolu spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a prahovou hodnotu, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte odpovědnost za vydání, výjimky, změny, rollback a ukončení. Použijte postupné nasazení, zachovejte bezpečnou zálohu a ověřte monitorování s úmyslně zavedenými selháními. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky, aniž by sbírala zbytečná citlivá data. Definujte prahové hodnoty alarmů a odpovědného za reakci, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte vždy, když se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také potřebuje dokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být deaktivován nebo nahrazen.
Primární reference