
Základy AI
Hotové vs. Vlastní modely strojového učení

 Přidejte Unite.AI mezi své preferované zdroje na Google
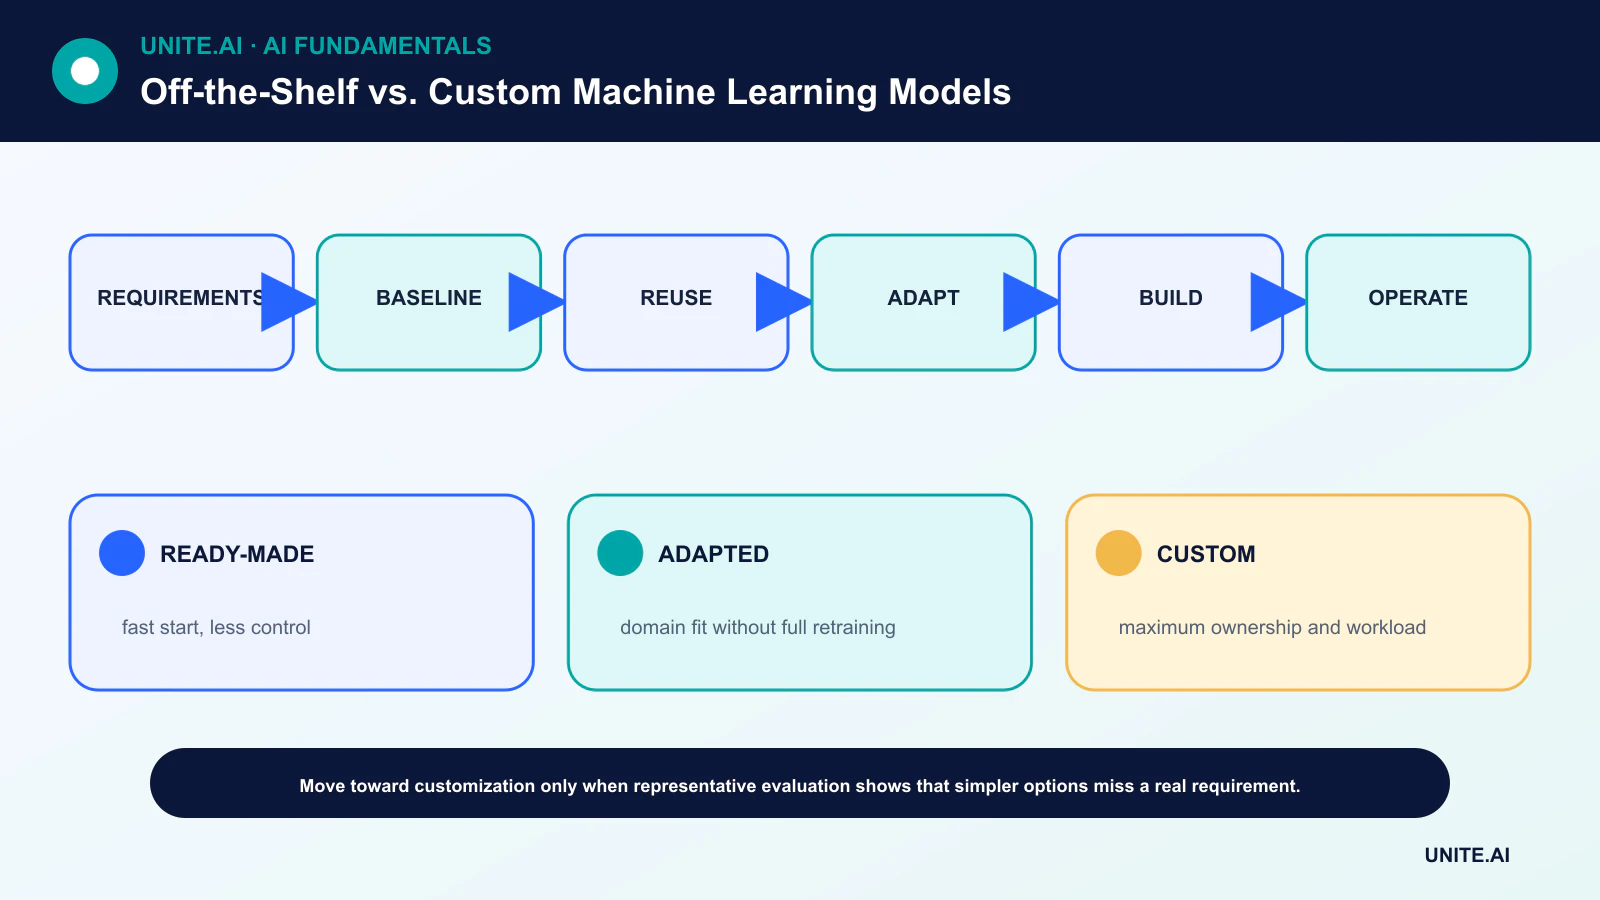
Výběr řešení strojového učení zřídka představuje jednoduché rozhodnutí mezi koupí a vývojem. Skutečný kontinuum sahá od hostovaného API nebo balíčkového modelu, přes promptování, vyhledávání a doladění, až po zcela vlastní architekturu trénovanou na datech specifických pro organizaci.
Nejlepší volbou je nejméně složitý přístup, který splňuje ověřený požadavek produktu. Vlastní model může poskytnout kontrolu a odlišení, ale zároveň vytváří trvalý závazek provozovat datové kanály, hodnocení, monitorování, zabezpečení, aktualizace a návrat k předchozí verzi.
Klíčové poznatky
- Začněte měřitelným úkolem, ne‑ML referenčním bodem a akceptačními prahy.
- Hodnoťte kandidátní modely na reprezentativních soukromých datech, nikoli jen na veřejných benchmarkových skórech.
- Zahrňte integraci, latenci, revizi, přeškolení a náklady na incidenty do celkových nákladů na vlastnictví.
- Upřednostňujte reverzibilní fáze: referenční bod, vyhledávání nebo prompt, doladění, a teprve trénování od nuly, pokud to podpoří důkazy.
Definujte rozhodnutí před výběrem modelu
Uveďte uživatele, rozhodnutí, vstup, výstup, náklady na chyby, rozpočet latence, vzor provozu a eskalační cestu. Zjistěte, zda deterministické pravidlo nebo vyhledávací systém řeší dostatečnou část problému. Pravidla ML od Googlu doporučují jednoduché referenční body a spolehlivou infrastrukturu před složitým modelováním.
Vytvořte offline hodnotící sadu, která odráží produkci, včetně vzácných a adversariálních případů. Kde rozhodnutí ovlivňují lidi, definujte kontroly podskupin a pravidla lidské revize. Tyto brány učiní srovnání konkrétním místo toho, aby volba architektury byla jen preferencí.
Kontinuum opětovného využití a adaptace
Hostované API poskytuje rychlou integraci a řízené škálování, ale omezenou kontrolu nad vnitřními částmi modelu, verzemi a zpracováním dat. Otevřený předtrénovaný model zvyšuje kontrolu nasazení. Vyhledávání nebo prompt engineering může přidat kontext domény bez změny vah.
Doladění nebo parametricky úsporné adaptéry mohou specializovat chování. Trénování od nuly je oprávněné jen tehdy, když data, cíl, rozsah nebo požadavek na vlastnictví nelze splnit prostřednictvím opětovného využití. Transfer learning často zachytí většinu hodnoty s podstatně menším množstvím dat a výpočetní kapacity.
Kvalita, kontrola a vázanost
Měřte kvalitu úkolu, kalibraci, latenci, propustnost, dostupnost a konzistenci selhání. Model od dodavatele se může automaticky zlepšovat, ale může také měnit chování; samohostovaný model lze uzamknout, ale tým musí spravovat aktualizace a zranitelnosti.
Smluvní podmínky by měly řešit uchovávání dat, využití při trénování, regionální zpracování, duševní vlastnictví, úrovně služeb, exportní cesty a ukončení podpory. Přenositelnost se zlepšuje, když aplikace odděluje modelově specifické adaptéry od obchodní logiky a ukládá reprodukovatelné hodnotící artefakty.
Soukromí, bezpečnost a provoz
Zmapujte každý tok dat a hranici hrozby. Citlivé vstupy mohou vyžadovat soukromou síť, lokální inferenci nebo edge AI. Samohostování automaticky nezaručuje bezpečnost systému; přenáší odpovědnost za zabezpečení a soulad na provozovatele.
Vlastnictví produkce zahrnuje pozorovatelnost, kontroly driftu, monitorování zneužití, reakci na incidenty a návrat k předchozí verzi. Provozní tým musí být schopen odpovědět, který model, prompt, verze dat a politika vytvořily výsledek.
Používejte stupňované důkazy, ne ideologii
Proveďte časově omezený benchmark se stejným datasetem a akceptačními kritérii napříč možnostmi. Odhadněte čas inženýrství, anotaci, využití akcelerátorů, poplatky dodavatele, pracovní náklady na revizi, náklady na selhání a očekávanou frekvenci změn.
Vyberte nejjednoduššího kandidáta, který projde branami, a poté přehodnoťte, jakmile se požadavky nebo ceny změní. Přizpůsobení je cenné, když přináší měřitelný přínos nebo nezbytnou kontrolu – ne jen proto, že na míru vytvořený model zní strategicky důležitě.
Požadavky a porovnání celkových nákladů
Hotový model, API nebo balíčkový systém poskytuje předpřipravenou funkčnost s podporou dodavatele a rychlejší úvodní nasazení. Vlastní model je trénován nebo podstatně adaptován pro konkrétní úkol, data a provozní prostředí. Volba začíná požadavky: cílový výsledek, kvalita podle podskupin a okrajových případů, latence, propustnost, dostupnost, vysvětlitelnost, umístění dat, kontrola aktualizací, integrace, bezpečnost a důsledek selhání. Obecný benchmark nebo demo nedokáže odpovědět, zda produkt tyto požadavky splňuje.
Celkové náklady zahrnují hodnocení, přípravu dat, označování, integraci, licence nebo využití, infrastrukturu, monitorování, revizi, reakci na incidenty, aktualizace a odchod. Hotové řešení snižuje počáteční inženýrské úsilí, ale může vytvořit proměnlivé náklady, vázanost, změny chování a omezenou pozorovatelnost. Vlastní vývoj přidává odpovědnost za data a MLOps a může stále záviset na předtrénovaných vahách a dodavatelích. Náklady na model by měly být měřeny na úspěšný úkol při požadované kvalitě, nikoli jen na token nebo samotný trénink.
Hodnocení, nákup a adaptace
Vytvořte reprezentativní soukromou testovací sadu před výběrem dodavatele a spusťte každého kandidáta pod identickými prompty, předzpracováním, prahy a provozními limity. Zahrňte nejednoznačné, adversariální, nepodporované, vícejazyčné a vysoce důsledkové případy. Měřte přesnost, kalibraci, latenci, náklady, odmítnutí, bezpečnost a dopad na lidský pracovní tok. Testujte výpadky API, limity rychlosti, regionální chování a změny verzí. Nároky dodavatele vyžadují dokumentaci o trénování, právech, soukromí, uchovávání, subprocesorech, bezpečnosti, podpoře a oznámení incidentu.
Možnosti adaptace tvoří spektrum: konfigurace, vyhledávání, promptování, doladění, parametricky úsporné aktualizace, vlastní hlavy nebo trénování od nuly. Použijte nejméně složitou metodu, která splňuje důkazy. Vyhledávání je vhodné pro často se měnící znalosti; doladění může formovat formát nebo doménové chování; deterministický kód by měl řešit přesná pravidla. Ověřujte kombinované systémy, protože silný základní model může selhat kvůli špatnému vyhledávání, oprávněním nebo integraci.
Životní cyklus a plánování odchodu
Hostované produkty se mohou měnit nebo zmizet, zatímco vlastní modely se stávají technickým dluhem bez vlastníků. Sledujte závislosti verzí, monitorujte chování a výsledky, definujte spouštěče pro přeškolení nebo přehodnocení a udržujte možnost návratu. Uchovávejte data a rozhraní potřebná k migraci, vyjednávejte o smazání a exportu a vyhněte se tomu, aby proprietární schéma jednoho dodavatele bylo rozšířeno po celé aplikaci. Nejlepší volbou může být hybridní přístup: komerční schopnosti pro běžné úkoly a vlastní komponenty tam, kde výkon domény, kontrola nebo riziko vytvářejí trvalou hodnotu.
Praktický příklad: výběr modelu pro extrakci dokumentů
Společnost vytvoří soukromou testovací sadu faktur od různých dodavatelů, v různých jazycích, skenů, rukopisu a okrajových případů a poté porovná spravované API, otevřený předtrénovaný model, adaptovaný model a referenční pravidla. Hodnotí přesnost polí, finanční chybu, nepodporované dokumenty, latenci, propustnost, soukromí, umístění dat, integraci a náklady na správně zpracovanou fakturu. Demo dodavatele a veřejné benchmarky nenahrazují toto spárované hodnocení.
Vybraný hybrid používá komerční OCR službu s lokální validací a lidskou revizí pro nízkou důvěru nebo vysoké částky. Smlouvy definují uchovávání, subprocesory, aktualizace a mazání; architektura zachovává zdrojové soubory a odchodovou cestu. Stínové období odhaluje mezery ve schématu a u dodavatelích. Monitorování odděluje OCR, extrakci, validaci a opravy recenzentů. Pokud se chování dodavatele změní, tým může zmrazit, přepnout nebo přesunout více práce do vlastní komponenty, aniž by přepisoval finanční workflow.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení do produkce vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledek každého důležitého selhání. Zaveďte reprodukovatelný referenční bod a verzovanou hodnotící sadu před doladěním. Testujte běžné případy, hraniční podmínky, poškozený nebo chybějící vstup, posun distribuce, výpadek závislosti, zneužití a skupiny nebo prostředí, která jsou nejpravděpodobněji nedostatečně obsloužena. Měřte kvalitu úkolu spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoc pro vydání, výjimky, změny, návrat a ukončení. Použijte stupňované nasazení, zachovejte bezpečný fallback a ověřte monitorování pomocí úmyslně zavedených selhání. Provozní telemetrie by měla odhalit kvalitu vstupu, chování výstupu, verzi modelu nebo pravidla, zdraví závislostí, lidské zásahy a potvrzené výsledky, aniž by sbírala zbytečná citlivá data. Definujte prahové hodnoty výstrah a odpovědného, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte vždy, když se změní zdroje dat, uživatelé, modely, dodavatelé, zásady, hardware nebo cíle. Udržovaný systém také potřebuje zdokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Kdy by měl tým trénovat model od nuly?
Když předtrénované nebo hostované možnosti nedokážou splnit ověřené požadavky a tým má dostatečná proprietární data, výpočetní kapacitu, odborné znalosti a dlouhodobou provozní kapacitu.
Je hotový model bezúdržbový?
Ne. Integrace, hodnocení, změny verzí, monitorování, kontrola soukromí a chování fallbacku zůstávají odpovědností uživatele.
Primární odkazy











