Základy AI
Co je generativní AI?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Generativní AI označuje modely, které se učí vzory v datech a vytvářejí nový text, obrázky, audio, video, kód nebo jiné reprezentace na základě instrukcí či příkladů. Výstup je syntetizován z pravděpodobnostního modelu; není přímo načten z databáze, i když nástroje pro vyhledávání mohou dodat externí důkazy.
Různé rodiny modelů generují různými způsoby. Autoregresivní transformátory předpovídají sekvenci token po tokenu, difúzní modely iterativně odstraňují šum ze vzorku a generativní adversariální sítě se učí prostřednictvím soutěže mezi generátorem a diskriminátorem.
Klíčové poznatky
- Generování je podmíněné vzorkování z naučené distribuce, nikoli zaručené faktické připomenutí.
- Transformátory, difúzní modely, GANy a variacionální autoenkodéry představují různé kompromisy.
- Vyhledávání a nástroje mohou systému poskytnout oporu, ale jejich výstupy a oprávnění stále vyžadují ověření.
- Řízení rizik zahrnuje data, model, rozhraní, nasazení, monitorování a původ obsahu.
Jak se generativní modely učí
Cíle tréninku odměňují model za předpovídání nebo rekonstrukci vzorů v příkladech. Jazykový model odhaduje následující token; difúzní model se učí obrátit proces šumu; variacionální autoenkodér se učí strukturovanou latentní distribuci a dekodér.
Tento trénink vytváří statistickou generalizaci, ale může také reprodukovat zaujatosti, zapamatovat si neobvyklé sekvence nebo selhat mimo datovou distribuci. Dokumentace datasetu, deduplikace, kontrola soukromí a testování na oddělených datech jsou proto důležité před nasazením.
Hlavní rodiny architektur
Autoregresivní transformátory dominují textu a podporují multimodální sekvence. Difúzní modely jsou široce používány pro generování vysoce věrných obrázků a audia. GANy dokážou vytvářet ostré vzorky a ovladatelné obrazové systémy, ale mohou být obtížně trénovatelné.
Variacionální autoenkodéry poskytují modelování latentních proměnných a efektivní reprezentace, někdy slouží v rámci větších generativních pipeline. Skutečné produkty často kombinují několik modelů s vyhledáváním, filtry, nástroji a deterministickým kódem.
Podmínkování, vzorkování a kontrola
Prompt, štítek třídy, obrázek, audio klip nebo strukturovaný záznam mohou podmínit generování. Parametry vzorkování mění rozmanitost a determinismus. Nižší teplota může soustředit pravděpodobnosti tokenů, ale neudělá nesprávnou odpověď pravdivou.
Kontrola se zlepšuje, když systém používá explicitní schémata, omezené dekódování, referenční materiály a validaci. Prompt engineering mění kontext; doladění mění parametry; vyhledávání poskytuje externí informace. Každý přistupuje k jinému typu selhání.
Hodnocení je specifické pro aplikaci
Textové systémy mohou vyžadovat testy faktuality, dokončení úkolu, podporu citací, toxicitu a kalibraci. Systémy pro obrázky nebo audio mohou potřebovat testy věrnosti, sémantické zarovnání, rozmanitost, bezpečnost identity a percepční revizi. Kombinujte automatické metriky se reprezentativním lidským hodnocením.
Vytvořte verzovanou evaluační sadu, která zahrnuje běžné, vzácné, adversariální a politicky relevantní případy. Sledujte latenci, náklady a chování odmítnutí stejně jako kvalitu výstupu. Demo vybrané tvůrcem není důkazem spolehlivosti na úrovni populace.
Rizika, ochranná opatření a původ
Mezi důležitá rizika patří halucinace, injekce promptu, škodlivý obsah, napodobování, nebezpečné používání nástrojů, únik soukromí, spory o autorská práva, bias automatizace a neprůhledné dodavatelské řetězce. Profil generativní AI od NIST organizuje činnosti napříč správou, původem obsahu, testováním před nasazením a zveřejňováním incidentů.
Používejte nástroje s nejmenšími oprávněními, kontrolu vstupů/výstupů, lidskou revizi pro zásadní rozhodnutí, logování, rollback a hlášení uživatelů. Vodoznaky nebo obsahové certifikáty mohou přidat signály, ale žádný jediný detektor či štítek neprokazuje pravdu. Širší workflow syntetických médií musí zachovávat kontext a odpovědnost.
Rodiny modelů a mechanismy generování
Modely generativní AI odhadují nebo se učí proces, který může vytvářet nový text, obrázky, audio, video, kód nebo strukturovaná data. Autoregresivní modely předpovídají následující token nebo prvek; difúzní modely se učí obrátit proces šumu; variacionální autoenkodéry se učí pravděpodobnostní latentní proměnné; GANy trénují generátor proti diskriminátoru. Multimodální systémy propojují reprezentace napříč médii. Výstup je vzorkován z naučené statistické struktury podmíněné promptem, kontextem, nástroji nebo jinými vstupy – není získán jako zaručený fakt.
Základní modely jsou předtrénovány na širokých datech a adaptovány pomocí promptování, vyhledávání, doladění, optimalizace preferencí, řídicích sítí nebo úlohově specifických hlaviček. Tokenizéry, enkodéry, dekodéry, latentní prostory a nastavení vzorkování formují výsledky. Teplota a filtrování kandidátů vyvažují determinismus a rozmanitost. Delší prompty poskytují kontext, ale mohou být v rozporu, rozptylovat nebo obsahovat škodlivé instrukce. Vyhledávání může poskytovat oporu měnícím se znalostem, zatímco deterministický kód by měl zvládat přesné výpočty a pravidla.
Hodnocení, původ a práva
Hodnoťte podle úkolu: faktickou správnost a citace u odpovědí, provádění a bezpečnost u kódu, věrnost a rozmanitost u médií a lidský výsledek u kreativní asistence. Zahrňte odmítnutí, kalibraci, latenci, náklady, jazyky, přístupnost a adversariální testy. Plynulý nebo fotorealistický výstup může být nesprávný. Zachovejte model, prompt, seed, zdrojové důkazy, volání nástrojů a postprocessing pro reprodukovatelnost. Oddělte kvalitu vyhledávání od generování, aby vyladěná odpověď nemohla skrývat chybějící důkazy.
Trénink a výstupy vyvolávají otázky autorských práv, licencí, souhlasu, soukromí, publicity a důvěrnosti. Stanovte původ a povolené využití vstupních dat; zabraňte uživatelům v odhalování tajemství; testujte memorování; a poskytujte procesy hlášení a odstraňování. Syntetická média by měla nést trvalý původ nebo zveřejnění, kde je to proveditelné, zejména když může být zaměněna za důkaz. Nepoužívejte podobizny, hlas ani styl způsobem, který porušuje práva nebo klame.
Kontroly nasazení
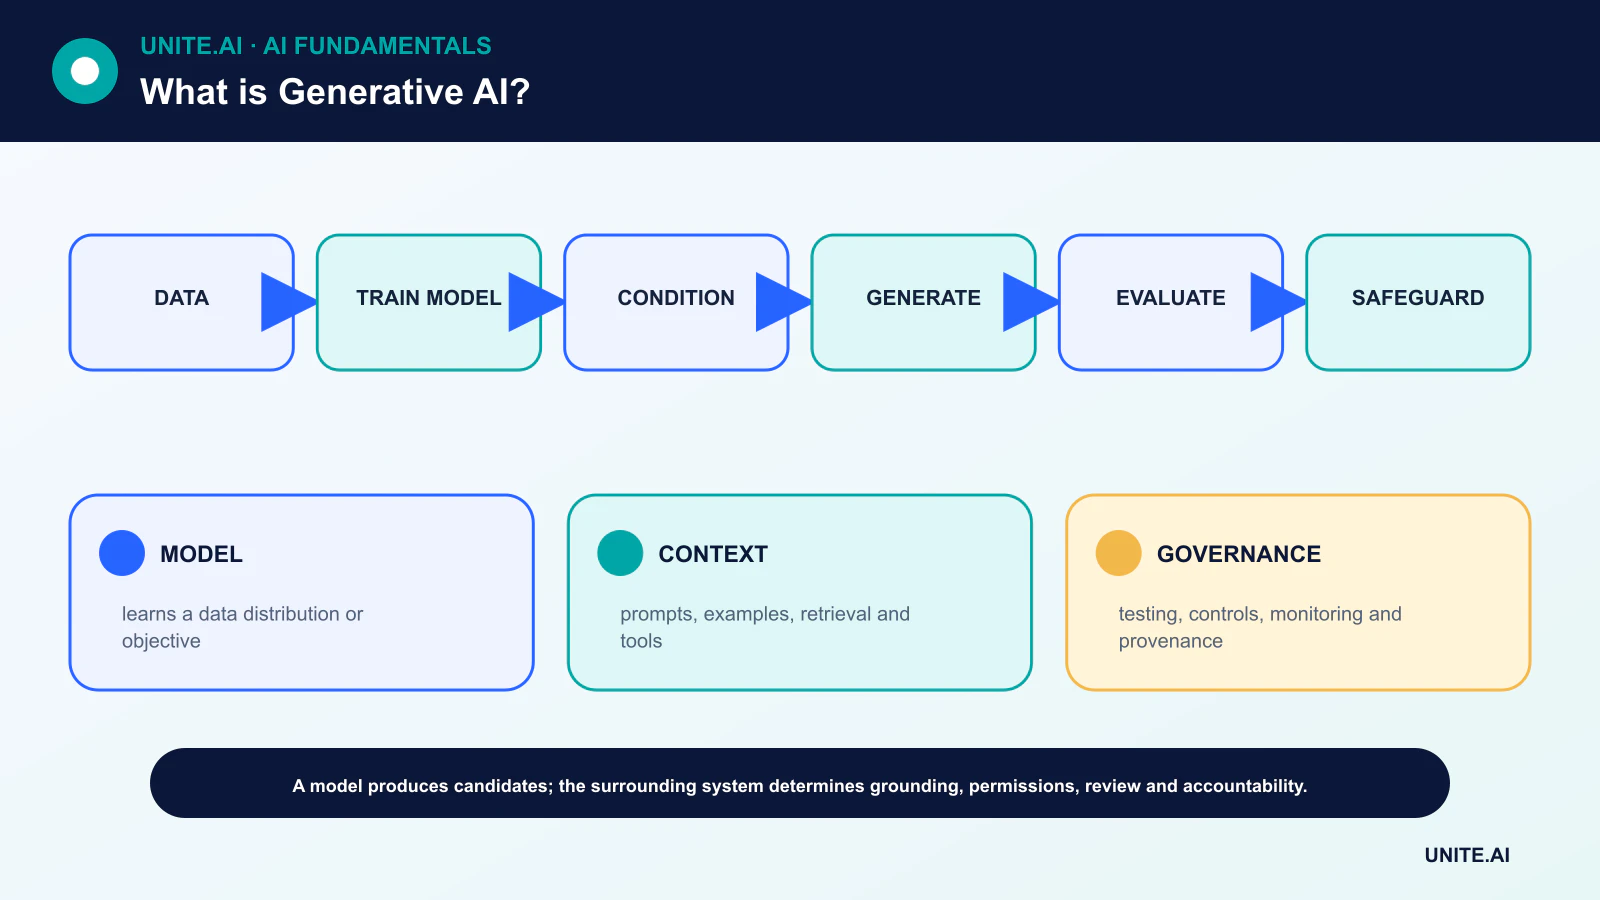
Považujte výstup modelu za nedůvěryhodný vstup. Validujte schémata, sanitizujte kód a soubory, izolujte vykonávání, externě autorizujte každý nástroj, omezte náklady a rychlost a vyžadujte potvrzení pro zásadní akce. Monitorujte selhání, zneužití, drift a uživatelské opravy, s rollbackem a ne‑generativní záložní možností. Dokumentujte zamýšlené i zakázané použití. Generativní AI rozšiřuje rozhraní pro tvorbu a transformaci informací, ale spolehlivost a odpovědnost pocházejí z okolních dat, hodnocení, bezpečnosti, původu a lidského rozhodovacího procesu.
Praktický příklad: generativní asistent pro popisy produktů
Maloobchodník umožňuje editorům generovat návrhy popisů pouze z ověřených atributů produktu a brandových směrnic. Prompt obsahuje strukturovaná fakta, zatímco vyhledávání poskytuje aktuální politiku. Výstup musí odpovídat schématu a je validován vůči zdrojovým hodnotám; nepodporované dimenze, bezpečnostní tvrzení nebo certifikace způsobí odmítnutí. Hodnocení zahrnuje faktickou přesnost, styl, duplicitu, vícejazyčnou kvalitu, přístupnost, latenci a korekce editorů, ve srovnání s šablonami a ručním psaním.
Editorové schvalují každou publikaci a mohou vidět zdrojová pole. Model nemá schopnost měnit cenu, skladové množství ani publikovat přímo. Prompt a produktová data jsou chráněna před injekcemi a důvěrné poznámky dodavatelů jsou vyloučeny. Monitorování sleduje nepodporovaná tvrzení, úpravy, stížnosti, náklady a verze poskytovatele. Generovaný text je uložen s původem. Systém šetří čas tvorby jen pokud korekce a revize nevymazávají výhodu a pravda o produktu zůstává řízena autoritativními daty.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení vyžaduje víc než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Stanovte reprodukovatelný výchozí stav a verzovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislostí, zneužití a skupiny či prostředí, která jsou nejčastěji nedostatečně obsloužena. Měřte kvalitu úkolu spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a prahovou hodnotu, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoc pro vydání, výjimky, změny, rollback a ukončení. Použijte postupné nasazení, zachovejte bezpečnou záložní možnost a ověřte monitorování pomocí záměrně vložených selhání. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu či pravidla, stav závislostí, lidské zásahy a potvrzené výsledky, aniž by sbírala zbytečná citlivá data. Definujte prahové hodnoty upozornění a odpovědnou osobu, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte, kdykoli se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také potřebuje zdokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Je generativní AI totéž jako velký jazykový model?
Ne. LLM jsou jednou třídou generativních modelů. Generativní AI zahrnuje také systémy pro obrázky, audio, video a strukturovaná data postavené na různých architekturách.
Kopíruje model svá tréninková data?
Obvykle syntetizuje z naučených vzorů, ale může dojít k memorování a téměř duplicitě. Rizika soukromí a původu je třeba vyhodnotit, nikoli předpokládat, že neexistují.
Primární reference