Základy AI
Co je datová věda?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Datová věda je praxe převádění dat na obhajitelné poznatky, předpovědi nebo rozhodnutí. Kombinuje odborné znalosti z dané oblasti, statistiku, výpočetní techniku, datové inženýrství, vizualizaci a komunikaci. Model může být součástí práce, ale disciplína začíná před modelováním a pokračuje po nasazení.
Nejdůležitější otázkou není „Jaký algoritmus bychom měli použít?“, je „Jaké rozhodnutí podporujeme, jaké důkazy by na to odpověděly a jak zjistíme, že výsledek zůstává užitečný?“
Klíčové poznatky
- Datová věda je end-to-end workflow založený na důkazech, nikoli synonymum pro strojové učení.
- Definice problému, měření a správa dat často určují úspěch více než složitost modelu.
- Prediktivní a kauzální otázky vyžadují odlišné předpoklady a návrhy hodnocení.
- Nasazená analýza potřebuje monitorování, dokumentaci a komunikaci přizpůsobenou svým uživatelům.
Začněte rozhodnutím a odhadem
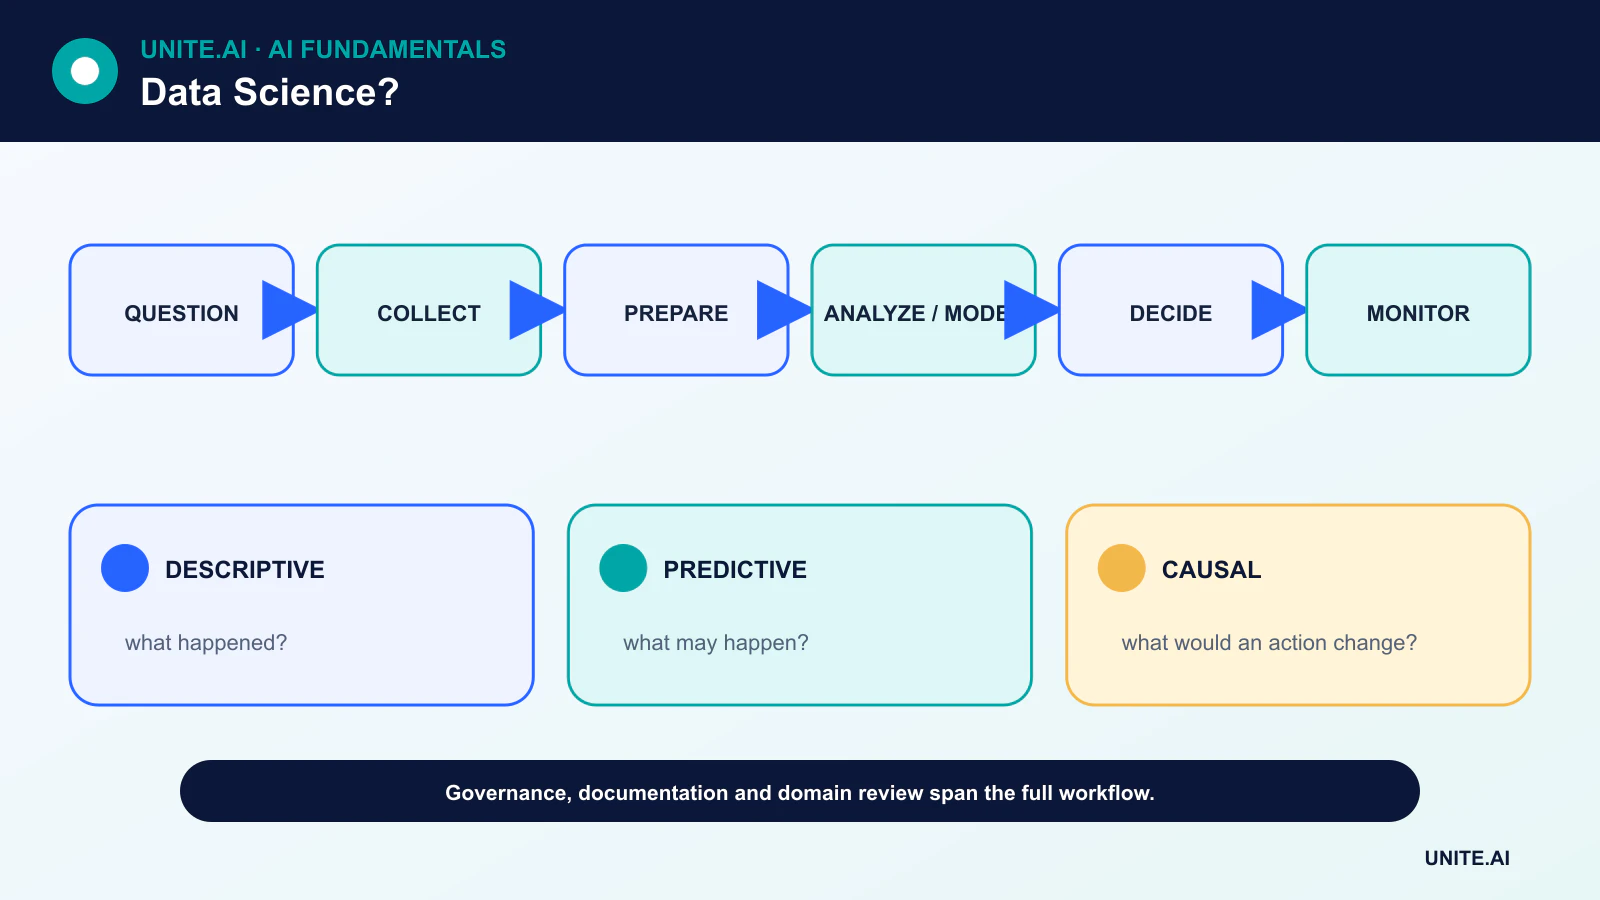
Projekt by měl identifikovat uživatele, rozhodnutí, zásah a náklady na chybu. Pro popisnou otázku může být cílem míra nebo trend. Pro predikci to může být budoucí poptávka nebo riziko. Pro kauzální otázku odhad (estimand) popisuje efekt definovaného zásahu za předpokladu uvedených předpokladů.
Nejasné cíle jako „najít poznatky“ znemožňují hodnocení. Měřitelný cíl vytváří hranici pro sběr dat a zabraňuje rozšíření analýzy do všech dostupných oblastí.
Sbírejte, spravujte a pochopte data
Týmy inventarizují zdroje, vlastnictví, souhlas, uchovávání, původ a přístup. Rozlišují strukturovaná a nestrukturovaná data, definují jednotky a časová razítka a zkoumají, zda záznamy představují populaci a časové období, o které jde.
Čištění není jen mazání chybějících řádků. Zahrnuje řešení duplicit, nemožných hodnot, nejasností štítků, posunu schématu, cenzurování a spojení, která mění jednotku analýzy. Každá transformace by měla být reprodukovatelná a zdokumentovaná.
Prozkoumejte před modelováním
Explorativní analýza zkoumá rozdělení, chybějící hodnoty, vztahy a potenciální artefakty měření. Vizualizace může odhalit odlehlé hodnoty a rozdíly ve skupinách, které průměrný souhrn skryje. Průzkum by měl informovat hypotézy, aniž by byl zaměněn za potvrzující důkazy.
Feature engineering, redukování dimenzionality a učení reprezentací mohou zlepšit modelování, ale transformace musí být natrénovány pouze na trénovacích datech, aby se zabránilo úniku informací.
Vyberte metody pro otázku
Statistické odhadování kvantifikuje nejistotu kolem zajímavých veličin. Strojové učení je užitečné, když je hlavním cílem predikční výkon na nových datech. Experimenty a metody kauzální inference jsou vyžadovány, když je cílem efekt zásahu.
Základní model by měl být dostatečně jednoduchý na pochopení. Složitější modely musí ospravedlnit svůj vyšší náklad lepším výkonem na testovacích datech, kalibrovanou nejistotou, provozní hodnotou nebo nezbytnou schopností, jako je zpracování obrazu či jazyka.
Vyhodnocujte, komunikujte a monitorujte
Vyhodnocení by mělo odpovídat rozhodnutí. Klasifikátor může vyžadovat přesnost, odvolání, kalibraci a analýzu podskupin spíše než jen přesnost; předpovědní systém potřebuje časově uvědomělé testování v reálném čase. Přeučení a únik informací jsou selhání procesu, nikoli jen vlastnosti modelu.
Komunikace zahrnuje předpoklady, nejistotu, omezení a doporučené kroky. Jakmile je model nebo dashboard používán, týmy monitorují kvalitu vstupů, posun výsledků, chování uživatelů a dopad na následné procesy. Ukončený rozhodovací proces potřebuje archiv a jasné vlastnictví, stejně jako nasazený proces potřebuje operátora.
Životní cyklus datové vědy a analytické otázky
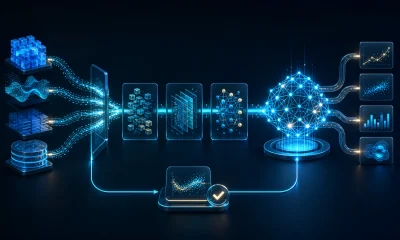
Datová věda kombinuje znalosti z oboru, statistiku, výpočetní techniku a komunikaci, aby přetavila data na důkazy pro rozhodování. Začněte rozlišováním popisu, diagnostiky, predikce a kauzální inference. Dashboard, který hlásí, co se stalo, model, který předpovídá, kdo odejde, a experiment, který odhaduje, zda zásah mění odchod, odpovídají na různé otázky. Před extrakcí dat definujte jednotku, populaci, časové okno, výsledek, akci a náklady chyb. Mnoho neúspěšných projektů řeší měřitelný proxy, který nemůže podpořit zamýšlené rozhodnutí.
Získávání vyžaduje původ, oprávnění, návrh výběrového plánu a datovou smlouvu. Průzkum kontroluje rozdělení, chybějící hodnoty, duplicity, odlehlé hodnoty, vztahy, změny měření a potenciální únik informací. Volby při čištění jsou analytické předpoklady: mazání chybějících řádků, imputace hodnot nebo ořezávání odlehlých hodnot mohou změnit populaci a závěr. Verze surových dat a transformací jako kódu by měly být neměnné a vytvořte datový slovník s jednotkami a významem. Rozdělte hodnotící data před učením transformací nebo opakovaným testováním hypotéz.
Modelování, inference a reprodukovatelnost
Statistická inference kvantifikuje nejistotu pod předpoklady; prediktivní modelování odhaduje výkonnost mimo vzorek; kauzální analýza vyžaduje identifikaci pomocí designu nebo obhajitelných předpokladů. Vyberte metody, které odpovídají otázce a procesu generování dat. Porovnávejte se jednoduchými základními modely, používejte seskupenou nebo časově uvědomělou validaci a uvádějte nejistotu a citlivost. Vysoká korelace nebo důležitost proměnných nezakládá kauzalitu. Vícenásobné testování, výzkumná svoboda a selektivní zveřejňování mohou vytvořit přesvědčivé vzory, proto může pomoci předregistrace nebo jasně oddělená potvrzovací fáze.
Reprodukovatelnost zahrnuje kód, prostředí, snímek dat, náhodná semena, definice dotazů a záznam manuálních rozhodnutí. Automatizované testy by měly pokrývat schémata, obchodní invarianty, transformace a metriky. Notebooky jsou cenné pro průzkum, ale produkční práce vyžaduje modulární, kontrolovatelné pipeline. Peer review by měl zpochybňovat předpoklady, únik informací, platnost cíle a zda se výsledky zobecňují. Komunikujte velikosti efektu, nejistotu, omezení a protidůkazy místo pouhé statistické významnosti nebo skóre modelu.
Nasazení a dopad rozhodnutí
Pokud analýza řídí opakující se proces, přiřaďte vlastníky, monitorujte čerstvost dat a kvalitu výsledků a definujte rollback nebo ukončení. Chraňte osobní a důvěrné informace prostřednictvím minimalizace, řízení přístupu, uchovávání a bezpečných výstupů. Vyhodnocujte efekty podskupin a reakce uživatelů na model; zpětné smyčky mohou měnit budoucí data. Změřte, zda rozhodnutí zlepšilo skutečný cíl, nikoli jen to, že byl nasazen model. Datová věda je úspěšná, když důkazy spolehlivě a transparentně mění akce – ne když organizace hromadí dashboardy, funkce nebo experimenty bez vlastnictví.
Praktický příklad: měření zásahu na retenci
Tým produktu zaznamená nižší retenci a definuje aktivního uživatele, kohortu, časové okno, vyloučení a rozhodnutí. Analytici auditují instrumentaci, chybějící události a mix akvizic před modelováním. Popisné kohorty identifikují, kde dochází k poklesu, prediktivní model upřednostňuje výzkumné účastníky a randomizovaný onboardingový experiment odhaduje, zda navrhovaná změna zlepší retenci. Jedná se o tři odlišné analýzy s oddělenými předpoklady a výstupy.
Notebook, dotazy, snímek dat, definice metriky a plán experimentu jsou verzovány a podléhají peer review. Výsledky uvádějí velikost efektu a nejistotu s omezeními pro poptávku po podpoře a přístupnost. Dashboard monitoruje experiment, ale nenahrazuje předem definovanou analýzu. Pokud zásah uspěje, nasazení zůstává fázované a kontroluje dlouhodobé chování. Práce je považována za hodnotnou jen tehdy, když podporuje reprodukovatelné rozhodnutí, ne proto, že byl vytvořen složitý model nebo vizuálně působivý graf.
Důkazy o implementaci a operační připravenost
Produkční rozhodnutí vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledek každého důležitého selhání. Zaveďte reprodukovatelný základ a verzovanou hodnotící sadu před laděním. Testujte běžné případy, okrajové podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislosti, zneužití a skupiny nebo prostředí, která jsou nejčastěji nedostatečně obsloužena. Měřte kvalitu úkolu spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoc pro vydání, výjimky, změny, rollback a ukončení. Použijte fázované nasazení, zachovejte bezpečný fallback a ověřte monitorování pomocí úmyslně vložených selhání. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky bez sběru zbytečných citlivých dat. Definujte prahové hodnoty alarmů a odpovědného, poté přezkoumejte reálné důkazy po nasazení místo předpokladu, že offline výkon přetrvá. Přehodnocujte vždy, když se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také potřebuje zdokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy by měl být deaktivován nebo nahrazen.
Často kladené otázky
Je datová věda stejná jako datová analytika?
Termíny se překrývají. Datová věda často zahrnuje tvorbu datových produktů a prediktivních systémů, zatímco analytika se může více zaměřovat na popisnou a diagnostickou podporu rozhodování. Použití v organizacích se liší.
Vyžaduje každý projekt datové vědy AI?
Ne. Dobře navržený dotaz, graf, experiment nebo statistický odhad může být užitečnější a důvěryhodnější než složitý model.
Primární reference