
Základy AI
Co je přeučení?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Přeučení nastává, když model zachytí vzory nebo šum, které na trénovacích datech fungují neobvykle dobře, ale nedokážou se zobecnit na nové příklady. Přeučený model může mít velmi nízkou chybu na trénovacích datech, zatímco výkon na validačních nebo reálných datech je podstatně horší.
Problém opačný je underfitting: model nebo trénovací proces nedokáže zachytit dostatek signálu ani na trénovací sadě. Dobré modelování vyvažuje přizpůsobení a zobecnění místo snahy o dokonalý výkon na trénovacích datech.
Klíčové poznatky
- Výkon na trénovacích datech sám o sobě nedokáže diagnostikovat zobecnění.
- Early stopping by měl využívat chování na validační sadě, nikdy neopakované rozhodování na finální testovací sadě.
- Více dat může pomoci, ale více vlastností nebo kapacity může také zhoršit přeučení.
- Regularizace, augmentace, křížová validace, prevence úniku informací a vhodné hodnocení řeší různé příčiny.
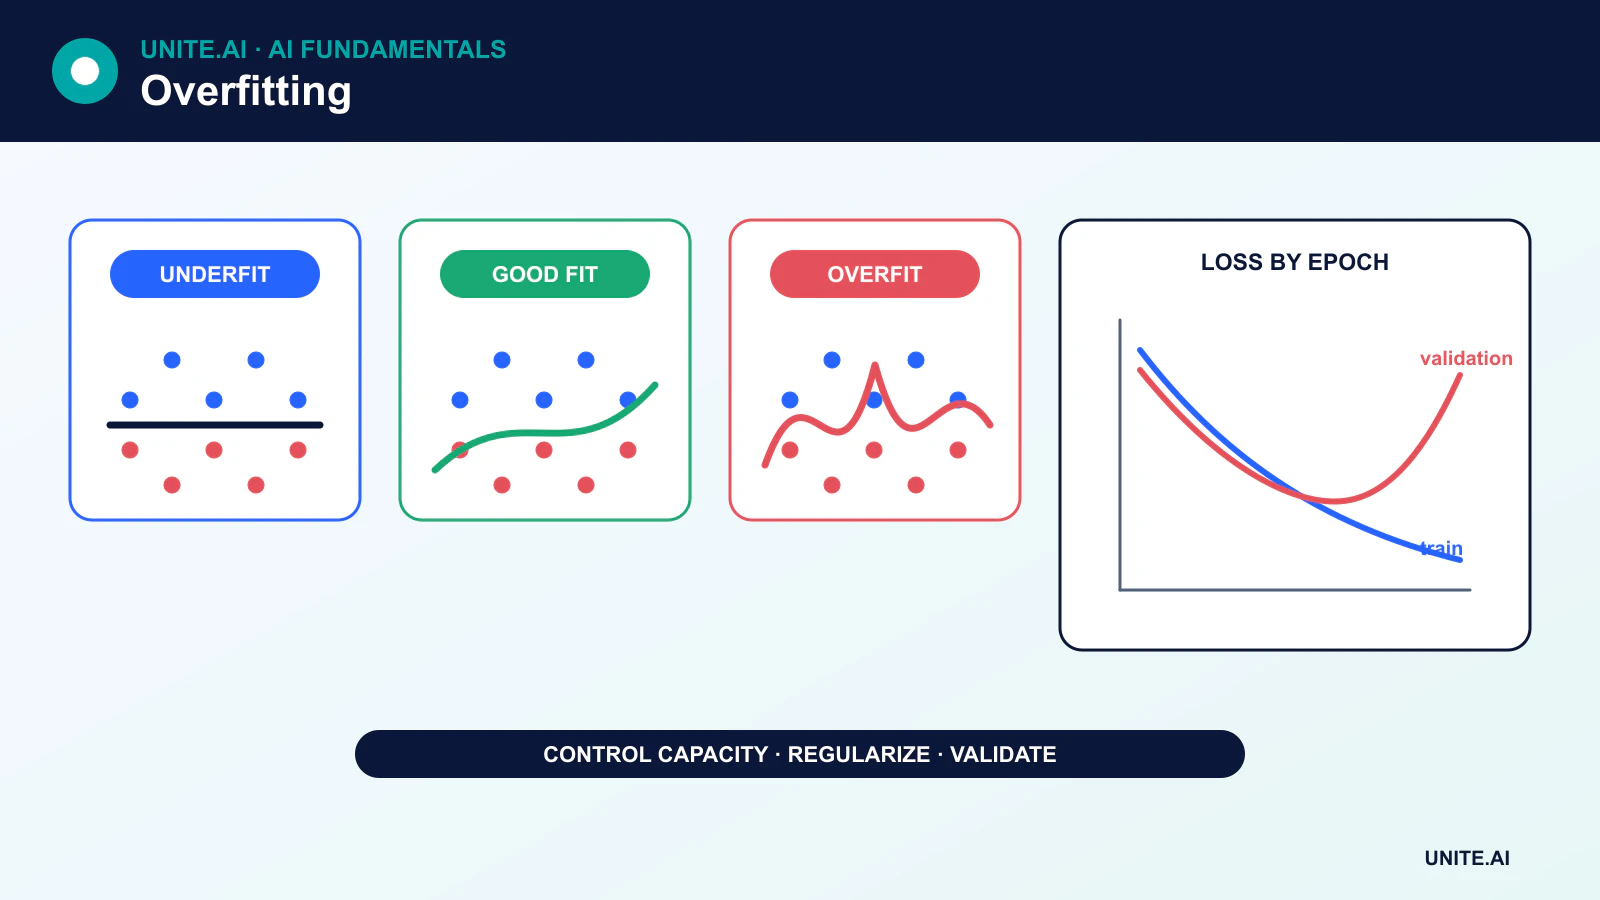
Přizpůsobení, podučení a přeučení
Model podučí, když jsou jeho předpoklady příliš omezující, jeho vlastnosti opomíjejí důležitý signál, optimalizace je nedostatečná nebo trénink není dostatečný. Přidání relevantních vlastností nebo kapacity může pomoci, ale pouhé přidání libovolných vlastností může zvýšit šum a přeučení.
Model přeučí, když je jeho efektivní kapacita příliš vysoká vzhledem k informacím v trénovacích datech. Příklady zahrnují hluboký rozhodovací strom, který vytváří malé listy, polynom, který sleduje náhodné výkyvy, nebo neuronovou síť, která si pamatuje příklady.
Role trénovacích, validačních a testovacích dat
- Trénovací data slouží k nastavení parametrů modelu.
- Validační data slouží k výběru architektury, hyperparametrů, prahových hodnot a okamžiku zastavení.
- Testovací data poskytují konečný odhad po dokončení těchto výběrů.
Pokud testovací sada opakovaně řídí rozhodnutí, stane se součástí vývojového procesu a již neposkytuje nestranný konečný odhad. Křížová validace může efektivněji využít omezená data, ale veškeré předzpracování a výběr vlastností musí probíhat uvnitř každého trénovacího skladu.
Předčasné zastavení
Během tréninku ztráta na trénovacích datech obvykle nadále klesá. Validační ztráta může nejprve klesat a později stoupat, jak se model specializuje na šum v trénovacích datech. Předčasné zastavení uloží kontrolní bod s nejlepším validačním cílem nebo zastaví trénink poté, co validační metrika nepokazuje zlepšení po definované dobu trpělivosti.
Správný kontrolní bod není ten s nejnižší ztrátou na trénovacích datech. Samostatná finální testovací sada se vyhodnocuje po ukončení předčasného zastavení a po dokončení rozhodnutí o ladění.
Metody regularizace
Penalizace vah
L2 regularizace nebo úbytek vah (weight decay) odrazuje od velkých hodnot parametrů. L1 regularizace může podporovat řídké koeficienty. Jejich účinky závisí na modelu a optimalizátoru; například AdamW odděluje úbytek vah od adaptivní aktualizace.
Dropout a stochastická regularizace
Dropout náhodně maskuje aktivace během tréninku. Ostatní metody odstraňují cesty, ruší vlastnosti nebo vyhlazují štítky. Tyto techniky mění tréninkový cíl a musí být při inferenci vypnuty nebo s nimi zacházeno vhodným způsobem.
Augmentace dat
Augmentace vytváří realistické variace – například ořezy, rotace, šum nebo parafráze – které by měly zachovat cíl. Neplatné transformace mohou změnit štítek a poškodit model. Pro počítačové vidění pomáhají nástroje jako Albumentations implementovat kontrolované pipeline.
Řízení kapacity
Méně hluboké stromy, méně parametrů, výběr vlastností, ořezávání a jednodušší třídy hypotéz mohou snížit rozptyl. Ořezávání stromů je řízené kritériem, nikoli náhodným odstraňováním naučených detailů.
Únik dat může vypadat jako výjimečný výkon
Únik dat nastává, když informace nedostupná v čase predikce vstoupí do tréninku nebo hodnocení. Běžné příklady zahrnují normalizaci na celém datovém souboru, rozdělení opakovaných záznamů mezi sklady, použití budoucích dat k predikci minulosti nebo zahrnutí vlastnosti odvozené od cíle.
Únik dat není běžné přeučení, ale vytváří stejný zavádějící rozdíl mezi offline výsledky a nasazením. Strategie rozdělení by měla respektovat čas, identitu, lokaci a procesy generování dat.
Posun distribuce je samostatný problém
Model může zobecnit na testovací distribuci a přesto selhat, když se data v produkci změní. Nová zařízení, politiky, populace, sezóny nebo adversariální chování mohou posunout vztah mezi vstupem a cílem. Monitorování a periodické přehodnocování jsou nutné i v případě, že původní model nebyl přeučen.
Diagnostika přeučení
Používejte učební křivky, rozptyl křížové validace, metriky podskupin, kalibraci a kontrolu chyb. Pokud jsou jak výkon na trénovacích, tak validačních datech špatné, zaměřte se na podučení, vlastnosti, štítky nebo optimalizaci. Pokud je trénink silný a validační výkon slabý, prozkoumejte kapacitu, únik dat, regularizaci a reprezentativnost dříve, než jen sbíráte více dat.
Proč dochází k přeučení a jak ho odhalit
Přeučení nastává, když model naučí vzory, které snižují chybu na trénovacích datech, ale neobecní se na cílovou populaci. Příčiny zahrnují nadměrnou kapacitu vzhledem k efektivním datům, šum ve štítcích, opakované entity, flexibilní výběr vlastností, únik dat a ladění vůči stejné validační sadě. Rozšiřující se mezera mezi výkonem na trénovacích a validačních datech je běžným důkazem, ale malá mezera nevylučuje přeučení, pokud obě sady sdílejí kontaminaci nebo se liší od nasazení. Učební křivky napříč objemem dat a kapacitou pomáhají rozlišit rozptyl od biasu.
Únik dat je zvláště klamavý: budoucí informace, duplikáty, překrývající se subjekty, předzpracování aplikované na všechna data nebo štítky zakódované v metadatech mohou přinést vynikající výsledky na odložených datech. Rozdělte podle jednotky, která bude nová při nasazení – pacient, zákazník, stroj, lokace nebo čas – před aplikací transformací nebo augmentací. Uchovejte finální testovací sadu uzavřenou během výběru vlastností, architektury a prahových hodnot. Pokud týmy opakovaně kontrolují výsledky testu, testovací sada se stane další validační sadou a vyžaduje nahrazení nebo formální opravu.
Regularizace, výběr modelu a drift v produkci
Snižte přeučení pomocí reprezentativnějších dat, nižší kapacity, úbytku vah, dropoutu, předčasného zastavení, augmentace, ensemble metod nebo omezení odrážejících strukturu domény. Každá metoda má kompromisy: augmentace může zkreslit štítky, dropout mění optimalizaci a ensemble zvyšuje náklady na nasazení. Křížová validace odhaduje variabilitu výběru, ale seskupené nebo časově citlivé sklady musí zachovat hranici nasazení. Porovnejte s jednoduchým modelem a uvádějte nejistotu napříč sklady nebo semeny místo výběru nejpříznivějšího běhu.
Produkce může odhalit jinou formu selhání zobecnění, když se změní vstupy, uživatelé, motivace nebo měření. Sledujte distribuce vlastností a predikcí, kalibraci, výsledky podskupin a opožděnou pravou hodnotu. Nepřeučujte automaticky na neprověřenou zpětnou vazbu; rozhodnutí modelu mohou formovat štítky, které později vidí. Diagnostikujte, zda selhání pochází z driftu, datových pipeline, změn politik nebo neplatného cíle. Přeučení je řízeno experimentálním designem a disciplínou životního cyklu, ne jediným nastavením regularizace.
Praktický příklad: eliminace úniku dat v modelu podvodu
Počáteční klasifikátor podvodu dosahuje vynikajících výsledků, protože se opakující události karet a obchodníků objevují v náhodných řádcích tréninku i testu a informace o chargebacku zaznamenané o týdny později jsou zahrnuty jako vlastnost. Tým rekonstruuje čas dostupnosti každé vlastnosti, odstraní pole po rozhodnutí, seskupí podle účtu a použije časové rozdělení dopředu. Výkon klesne ostře, ale nyní odhaduje skutečné rozhodnutí. Jednoduchá pravidla jako základ a učební křivky řídí požadovanou složitost modelu.
Regularizace a předčasné zastavení jsou laděny pouze v rámci historických skladů. Konečné hodnocení uvádí přesnost při kapacitě revize, recall, kalibraci a náklady podle typu podvodu a segmentu zákazníka. V produkci přicházejí potvrzené štítky pozdě a jsou zaujaté tím, které transakce byly přezkoumány, takže monitorování odděluje drift skóre od odhadů výsledků. Přeučování používá adjudikované případy a přehrává je proti aktuální politice. Projekt upřednostňuje nižší upřímné skóre před vysokým únikovým, které nemůže přežít nasazení.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Zaveďte reprodukovatelný výchozí stav a verziovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadky závislostí, nesprávné použití a skupiny či prostředí, která jsou pravděpodobně nedostatečně obsloužena. Měřte kvalitu úkolu spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a prahovou hodnotu, aby nezávislý recenzent mohl výsledek reprodukovat a rozlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoc pro vydání, výjimky, změny, rollback a ukončení. Použijte postupné nasazení, zachovejte bezpečnou záložní možnost a ověřte monitorování pomocí záměrně vložených selhání. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky bez sběru zbytečných citlivých údajů. Definujte prahové hodnoty alarmů a odpovědnou osobu, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte vždy, když se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také potřebuje dokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Může jednoduchý model přeučit?
Ano. Opakovaný výběr vlastností, ladění prahových hodnot nebo hodnocení na stejné odložené sadě může přeučit vývojový proces i když je finální model jednoduchý.
Zajistí více trénovacích dat vždy odstranění přeučení?
Ne. Více reprezentativních, správně označených dat může pomoci, ale duplicitní, zaujatá, úniková nebo mimo‑doménová data nemusí. Cíl učení a návrh hodnocení jsou stále důležité.
Primární reference












